独立した第2モデルによる再抽出、不一致の調査、スキーマ改善による90%以上の一致率達成。
7 · 検証と AI ジャッジ
抽出だけでは信頼とは言えません。 「データベースが正確であることをどのように確認できますか?」 に対する Sci-database の答えは、クロスモデル検証 です。独立した AI モデルが論文のサンプルを最初から再抽出し、プラットフォームは 2 つのモデルが一致する部分と一致しない部分をフィールドごと、レコードごとに正確に表示します。これは、大学院生の代わりにモデルを使用した、Cochrane スタイルの体系的レビューの二重抽出の実践を反映しています。
検証を開始しています
[データベース] タブで、完了したジョブの [検証] をクリックします。 「Validate」タブが開き、設定コントロールが表示されます。
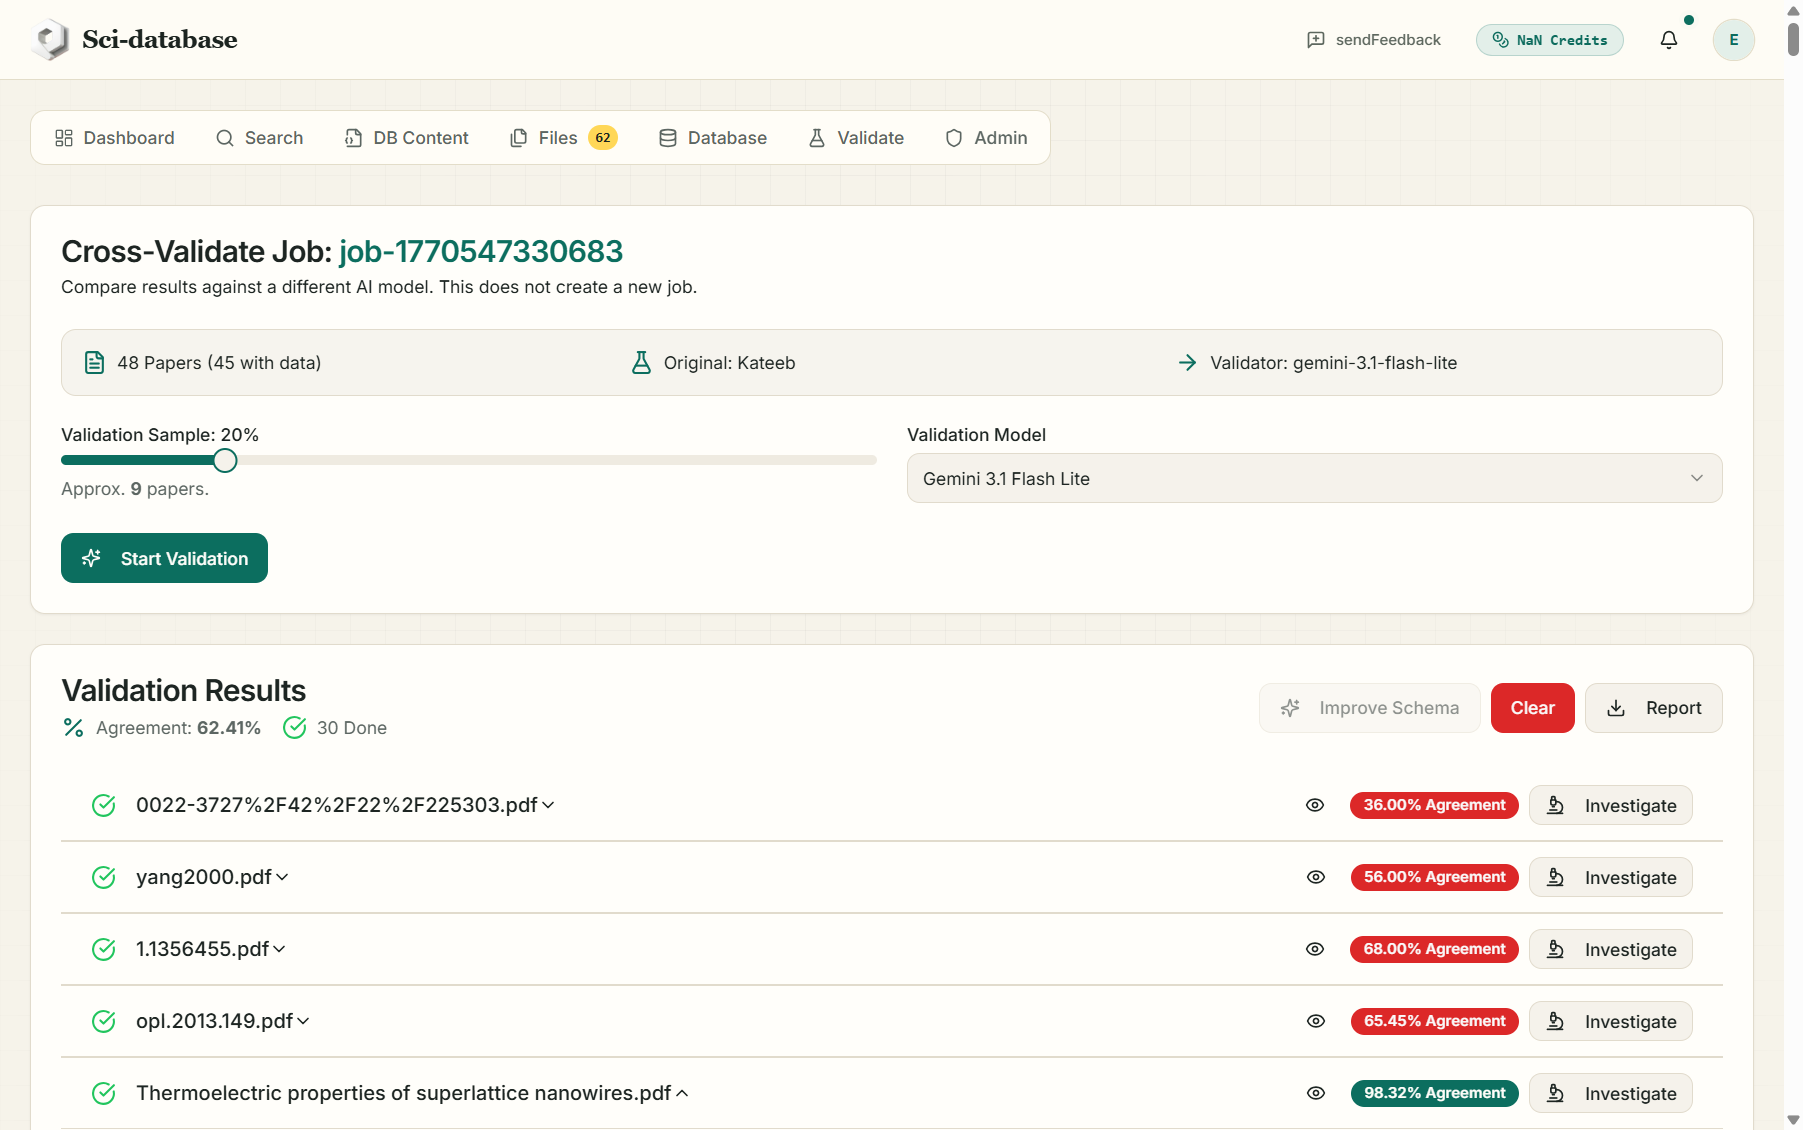
- 検証サンプル — データを生成した論文の 1 ~ 100% (デフォルトは 20%) のスライダー。正確さを知るためにすべてを検証する必要はありません。ランダムなサンプルが監査の仕組みです。
- 検証モデル — 2 番目のリーダーを選択します。
- Gemini 3.1 Flash Lite (デフォルト) または ** Gemini 3.1 Pro**
- GPT-4o-mini (OpenAI) — 独自の API キーを持参する
- Claude 3.5 Sonnet (Anthropic) — 独自の API キーを持参してください
OpenAI/Anthropic モデルの場合、ダイアログで API キーの入力を求められ、次のように表示されます: 「このキーはこの検証セッションでのみ使用され、保存されません。」
- 検証の開始 — 費用はサンプル紙ごとに 2 クレジット です。進行状況は 「i/N の検証中」 として表示されます。
バリデーター モデルは、同じ完全な文書テキストと同じスキーマを受け取りますが、独自のさらに厳格な指示が含まれます (文書全体を分析し、絶対に要約のみに依存しない、省略しない、最大限の具体性、正確な数値精度、不在の場合は N/A)。
結果の読み取り
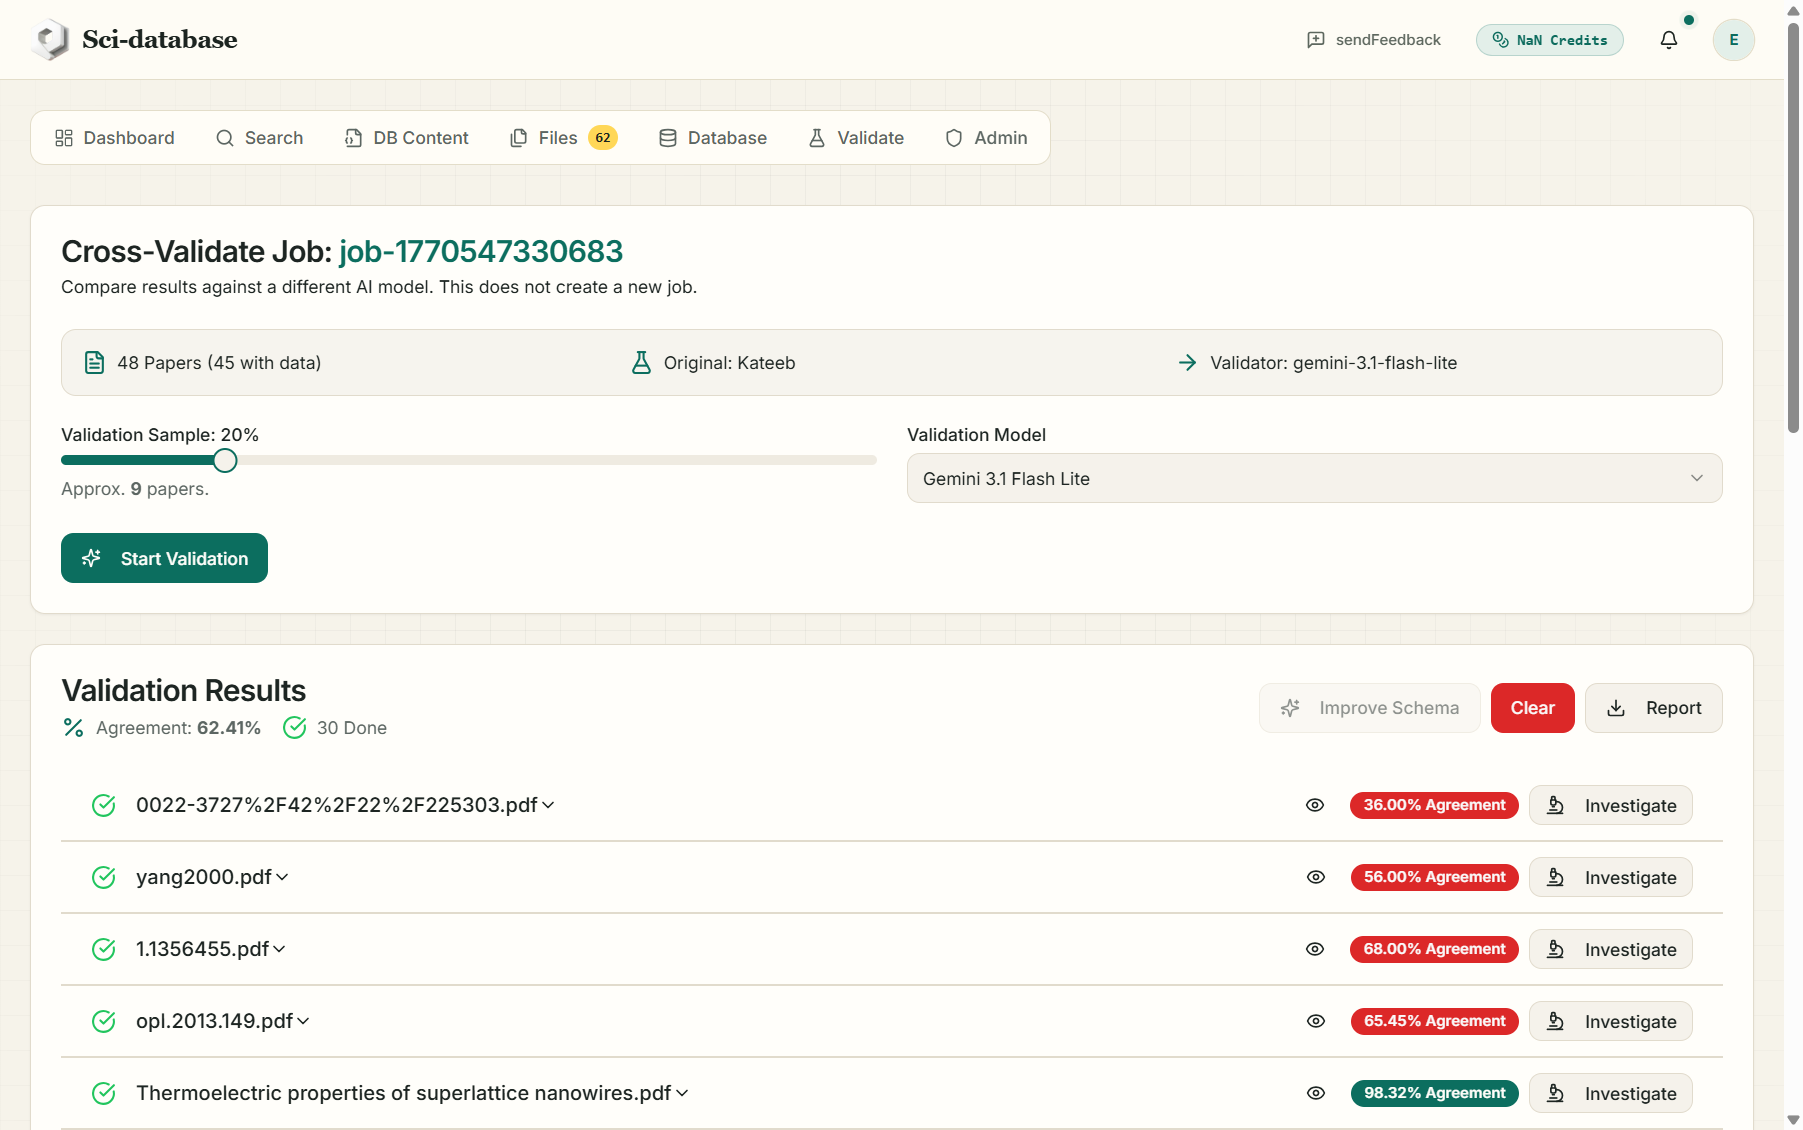
ヘッダーには、検証されたすべてのフィールドにわたる全体の同意率 が表示され、各論文には独自の同意バッジが付けられます。緑色のチェック = 完全に同意。赤い三角 = 意見の相違が見つかりました。フィールドは、バリデーターが 異なる空でない値 を返した場合にのみ 不一致 としてカウントされます。バリデーターがフィールドに対して何も見つけられなかった場合、それは競合ではなく中立 (ℹ) としてマークされます。
任意のペーパーを展開すると、レコード比較 テーブルが表示されます。
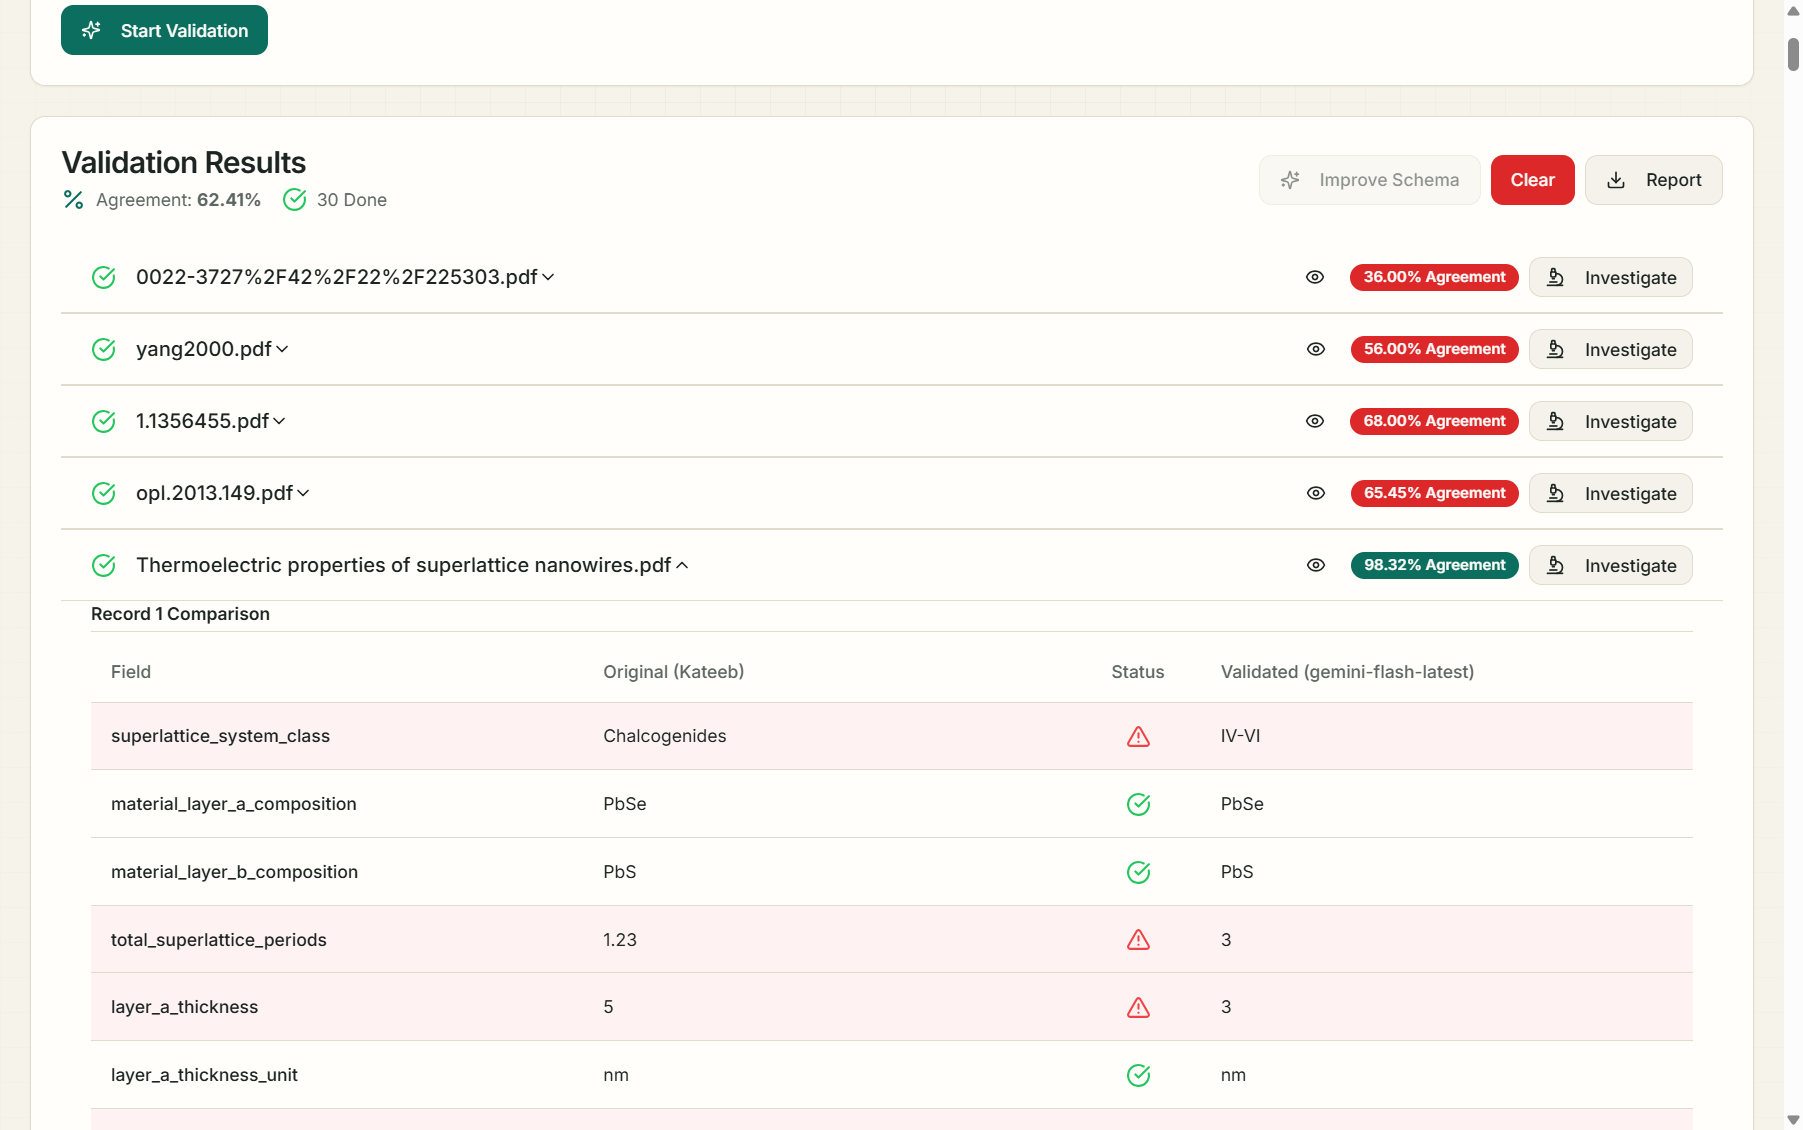
| コラム | 内容 |
|---|---|
| ** フィールド** | スキーマ フィールド |
| ** オリジナル (Kateeb)** | 最初の抽出で見つかったもの |
| ステータス | ✅ 一致 · ⚠️ 不一致 (行が赤で強調表示) · ℹ️ バリデータは何も見つかりません |
| 検証済み (モデル) | 2 番目のモデルで見つかったこと |
何も隠されておらず、何も自動修正されません。すべての赤い行は、プラットフォームがユーザーに提示する質問です。
AI 裁判官: 意見の相違を調査する
100% の同意に満たない論文については、調査 をクリックしてください (矛盾ごとに 2 クレジット)。 3 番目の AI は、専門裁定人 として機能します。係争分野ごとに論文のテキスト全文を再読み込みし、2 つの候補値のうちの 1 つ、テキスト内で直接示すことができる値、または N/A — および 1 ~ 2 文の推論を返さなければなりません。
結果は、最終値と裁定者の推論を含む 調査結果 行としてインラインで表示されます。それ以降、アービターの解決された値がそのフィールドの参照 になり、それに対して合意スコアが再計算されます。
完全な比較を レポート — 論文タイトル、レコードインデックス、フィールド名、元の値、検証された値、一致 の列を持つ CSV (validation_report_job_….csv) としてダウンロードでき、原稿の補足資料に添付することができます。
ループを閉じる: スキーマを改善する
ほとんどの不一致はモデルの失敗ではありません - それらは 曖昧なフィールドの説明 (「効率」 - 何の? 初期か安定か? どのユニット?) です。 スキーマの改善 (5 クレジット) をクリックすると、AI が調査された不一致を分析し、より良いフィールド 説明 を提案します (名前と型には一切触れません)。
各提案には、推論、古い説明 (赤) および編集可能な 提案された説明 (緑) が表示されます。フィールドごとに 承認して編集 または 拒否 を選択します。受け入れられた変更はスキーマ エディターに反映されます。スキーマを保存し、抽出を再実行します。
90%以上に収束中
これは、プラットフォームが設計されている信頼ループです。
  extract  →  validate (2nd model)  →  investigate (AI Judge)  →  improve schema  →  re-run
     ▲                                                                                │
     └────────────────────────────────────────────────────────────────────────────────┘
パス全体の典型的な軌跡: 最初の生の実行で ~70% の一致 (単位と曖昧なフィールドに関してモデルが一致しない) → スキーマの調整後 ~85% → 90%+ (プラットフォームの信頼しきい値)。この時点での不一致は、個人的に判断した真の厳しい判断に限定されます。あなたのデータベースは、それを証明する検証レポートによってピアレビューで防御できるようになりました。
