AI支援によるパラメータ自動生成、データ型設定、単位の関連付けとカスタマイズ。
5 · スキーマの構築
Your schema is the structure of your future database: the columns (fields), their types, and — crucially — the descriptions that tell the AI exactly what to extract. DB Content タブで構築します。
AI にドラフトを任せる: AI を活用したスキーマ生成
上部のカードにデータベースを平易な英語で説明し、パラメータの提案 をクリックします。
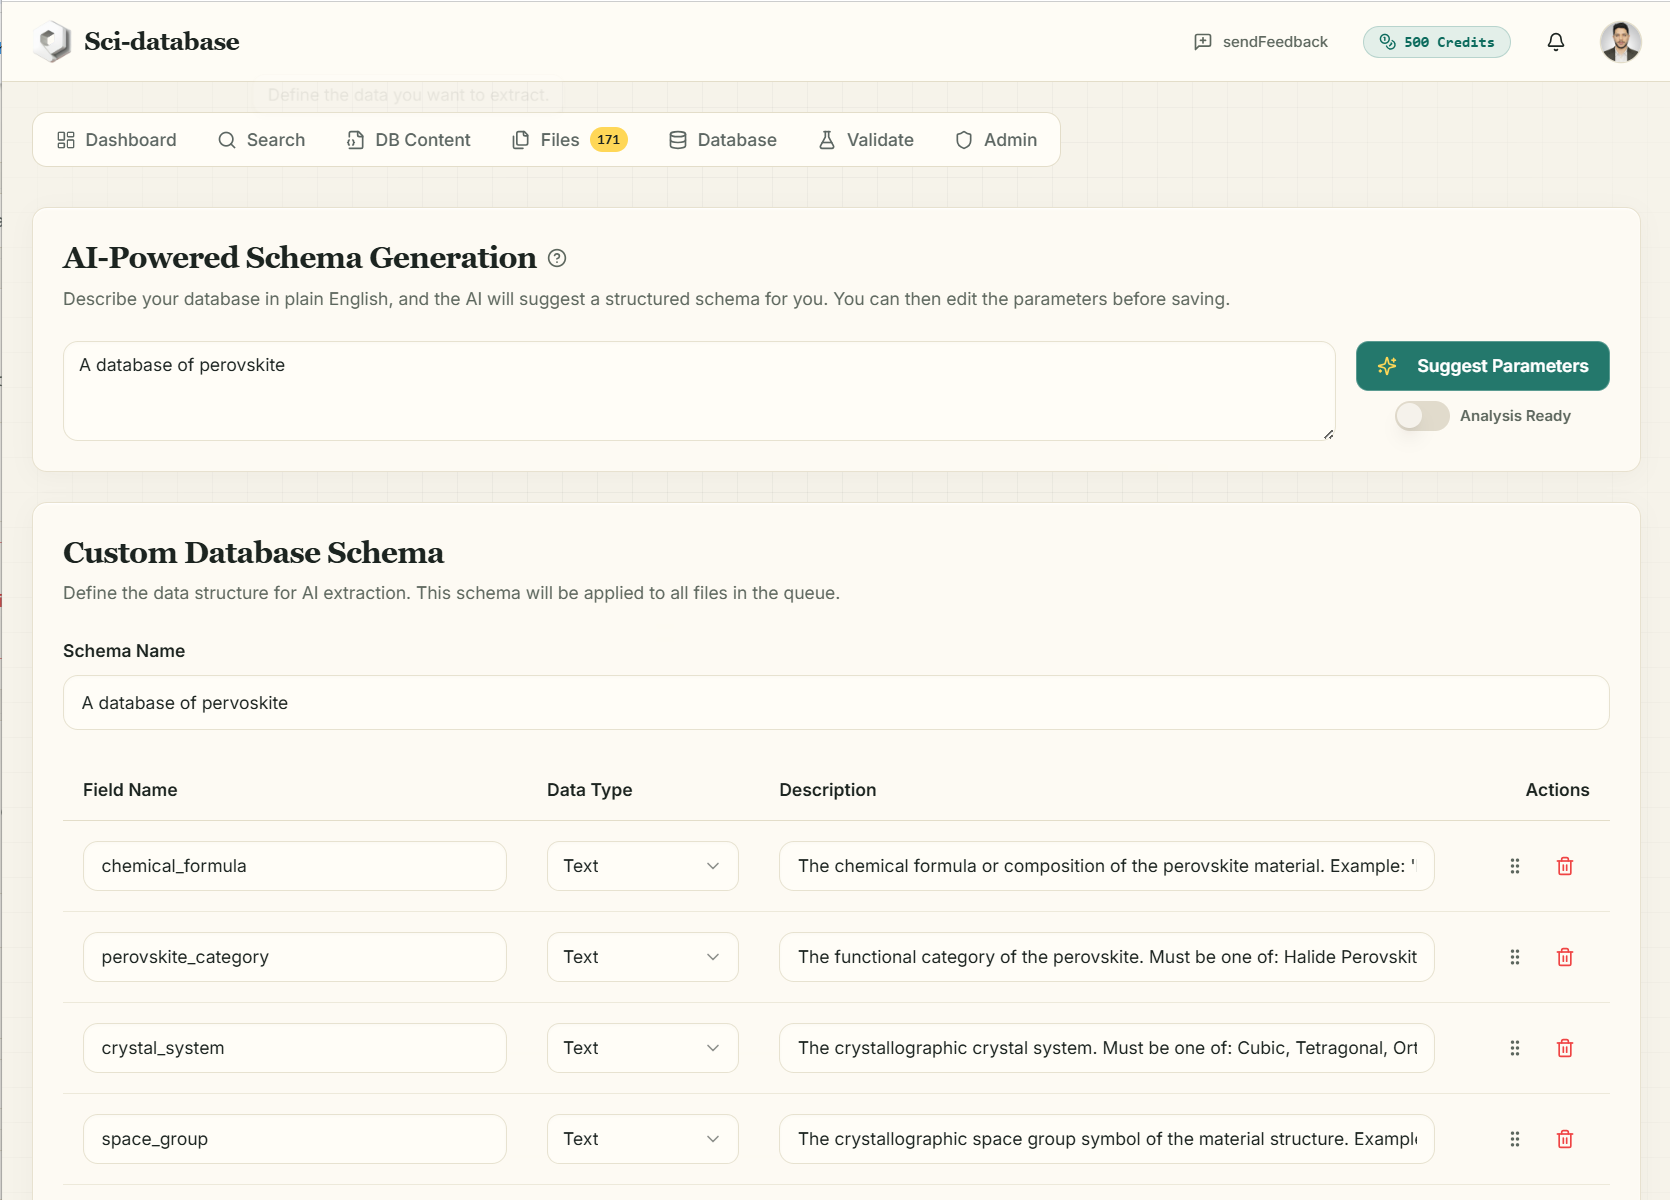
適切なプロンプトの例:
- 「ペロブスカイト太陽電池の効率と安定性のデータベース」
- 「高血圧に関するランダム化比較試験のデータベース: サンプルサイズ、介入、血圧の結果」
- 「熱電超格子測定データベース:ゼーベック係数、熱伝導率、ZT」
The AI (costs 2 credits) returns a complete draft schema following strict conventions that make extractions consistent and analyzable:
snake_case(chemical_formula、sample_size) のフィールド名。- タイプはテキスト、数値、日付、ブールに限定されます。
- すべての数値フィールドは
…_unitテキストフィールド (seebeck_coefficient+seebeck_coefficient_unit) とペアになっているため、単位が失われたり混在したりすることはありません。 - カテゴリフィールドには、制御された語彙が説明内に含まれます — 例: 「立方晶、正方晶、斜方晶、六角形、三方晶、単斜晶、三斜晶のいずれかである必要があります」 — 何百もの論文にわたって一貫した値が強制されます。
- A
doi/ 参照フィールドは常に最後 であるため、データベース内のすべての行をソース論文まで追跡できます。
The Analysis Ready switch tells the AI to prefer numeric, boolean, and single-word categorical fields (and to avoid long free-text fields) — use it when the database is destined for statistical analysis or ML training rather than narrative review.
If your prompt isn't recognizable as a scientific database request, the AI declines rather than inventing something: "The AI could not identify relevant parameters for this request. Please try a more specific scientific description."
すべてを編集: カスタム データベース スキーマ エディター
AI のドラフトは出発点です。以下のエディターで完全に制御できます。
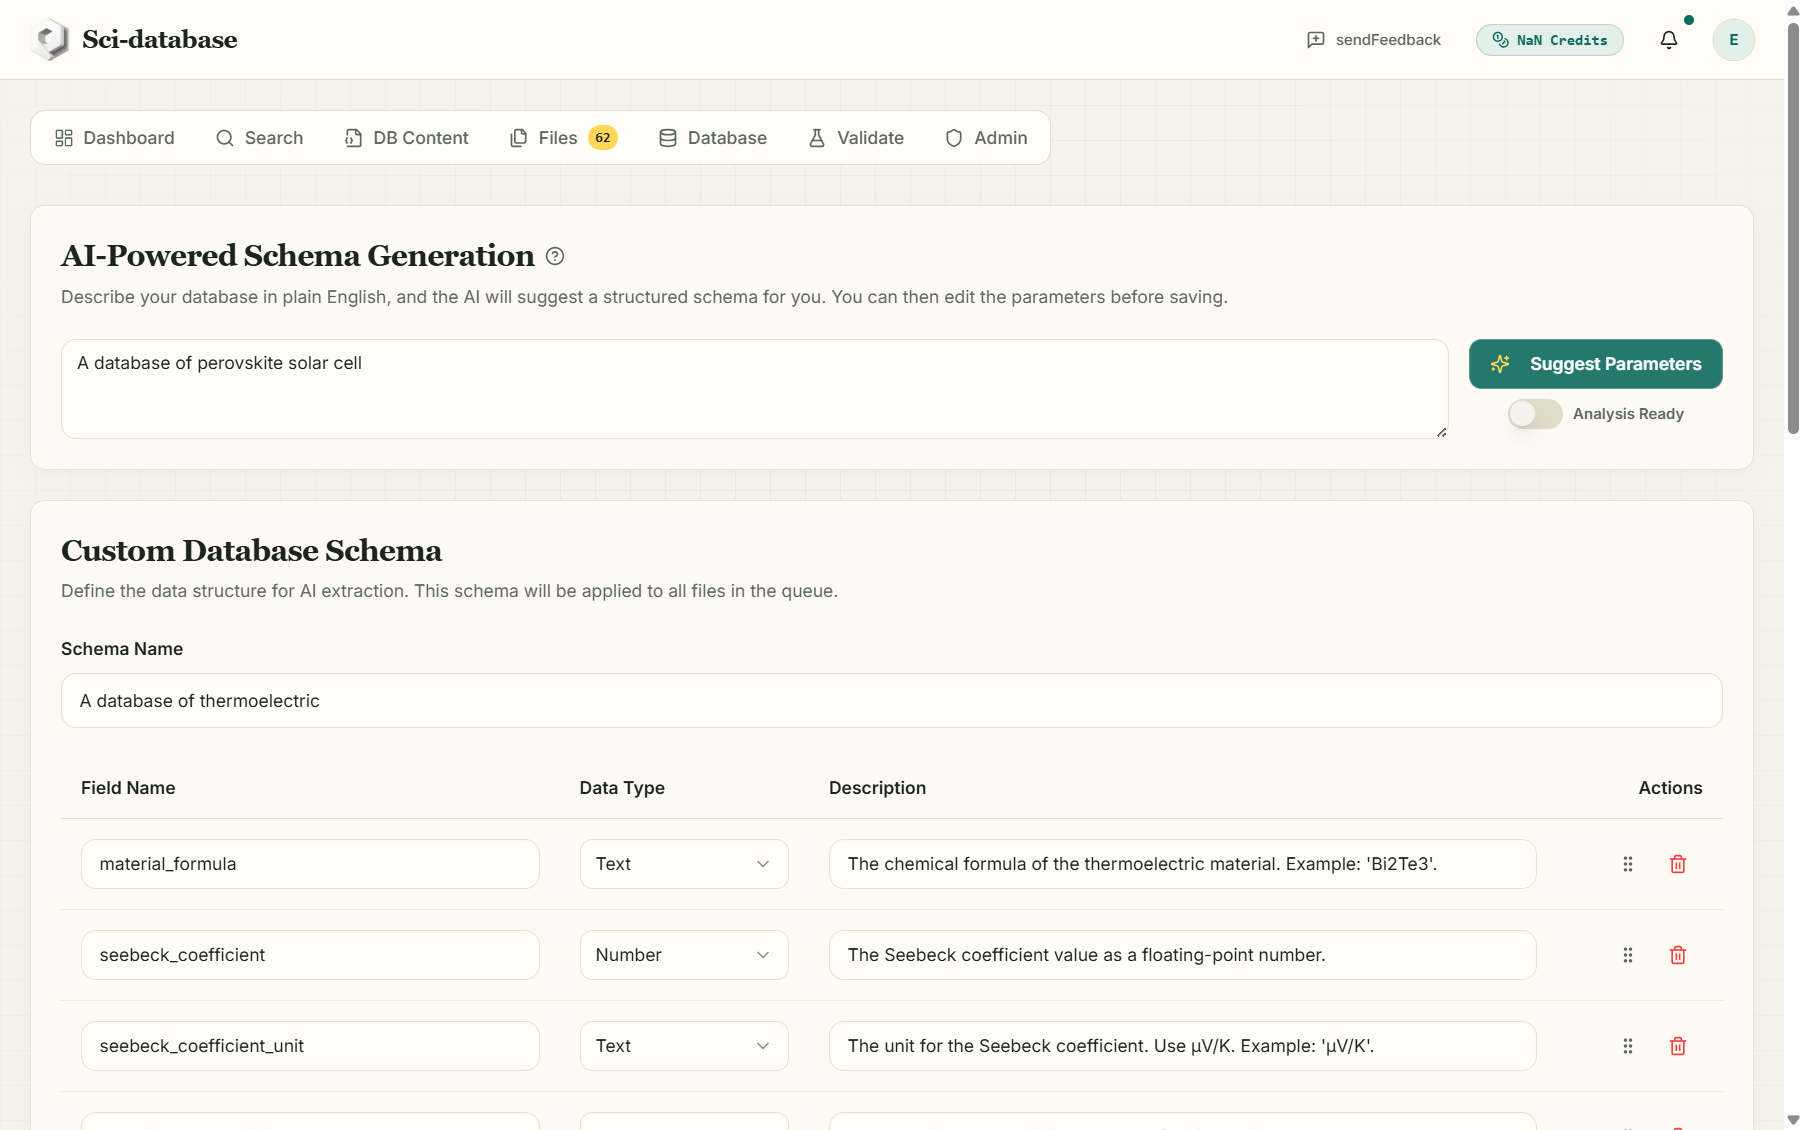
- スキーマ名 — データベースに名前を付けます。
- フィールドごと: フィールド名、データタイプ (テキスト / 数値 / 日付 / ブール値)、説明。
- 行をドラッグして並べ替えます、ゴミ箱アイコンでフィールドを削除し、フィールドを追加でフィールドを追加します。
- 「16⟧データ分析に適しています」** スイッチは、スキーマを分析準備完了としてマークします。
うまく抽出した説明を書く
説明は、抽出モデルが実際に従う指示です。それに投資してください。
| 弱い説明 | 強い説明 |
|---|---|
| "効率" | "浮動小数点数としてのデバイスのチャンピオン電力変換効率 (PCE)。丸めずに正確な値を抽出します。" |
| 「方法」 | 「蒸着方法。スピンコーティング、蒸着、ブレードコーティング、スプレーコーティング、インクジェット印刷のいずれかである必要があります。」 |
| "温度" | "特性が測定された温度を数値で示します。単位は測定温度単位 (K または °C) になります。 |
役立つ場合は値の例を含めます (「例: 'Bi2Te3'」)。後の検証でフィールドに関する体系的な不一致が示された場合は、スキーマの改善 機能によってこれらの説明が書き換えられます (第 7 章)。
保存中
スキーマの保存 をクリックします — 「スキーマが保存されました — スキーマがアカウントに保存されました。」 が表示されます。 ファイルを処理する前に保存が必要です。
保存について知っておくべき 2 つのこと:
- スキーマは設計により公開されています。 フィールド定義 (ユーザーのデータではありません) は 公開スキーマ ギャラリー に公開されるため、他の研究者は適切に設計されたテンプレートを再利用できます。論文と抽出された値は非公開のままです。
- 保存すると、スキーマがその場で更新されます。 既存のスキーマを編集して再保存すると、同じスキーマ レコードが更新され、以前のフィールド定義が置き換えられます。ただし、すべてのジョブは実行に使用したスキーマの永続的なスナップショットを保存するため、過去の結果は常に元の構造を維持します。
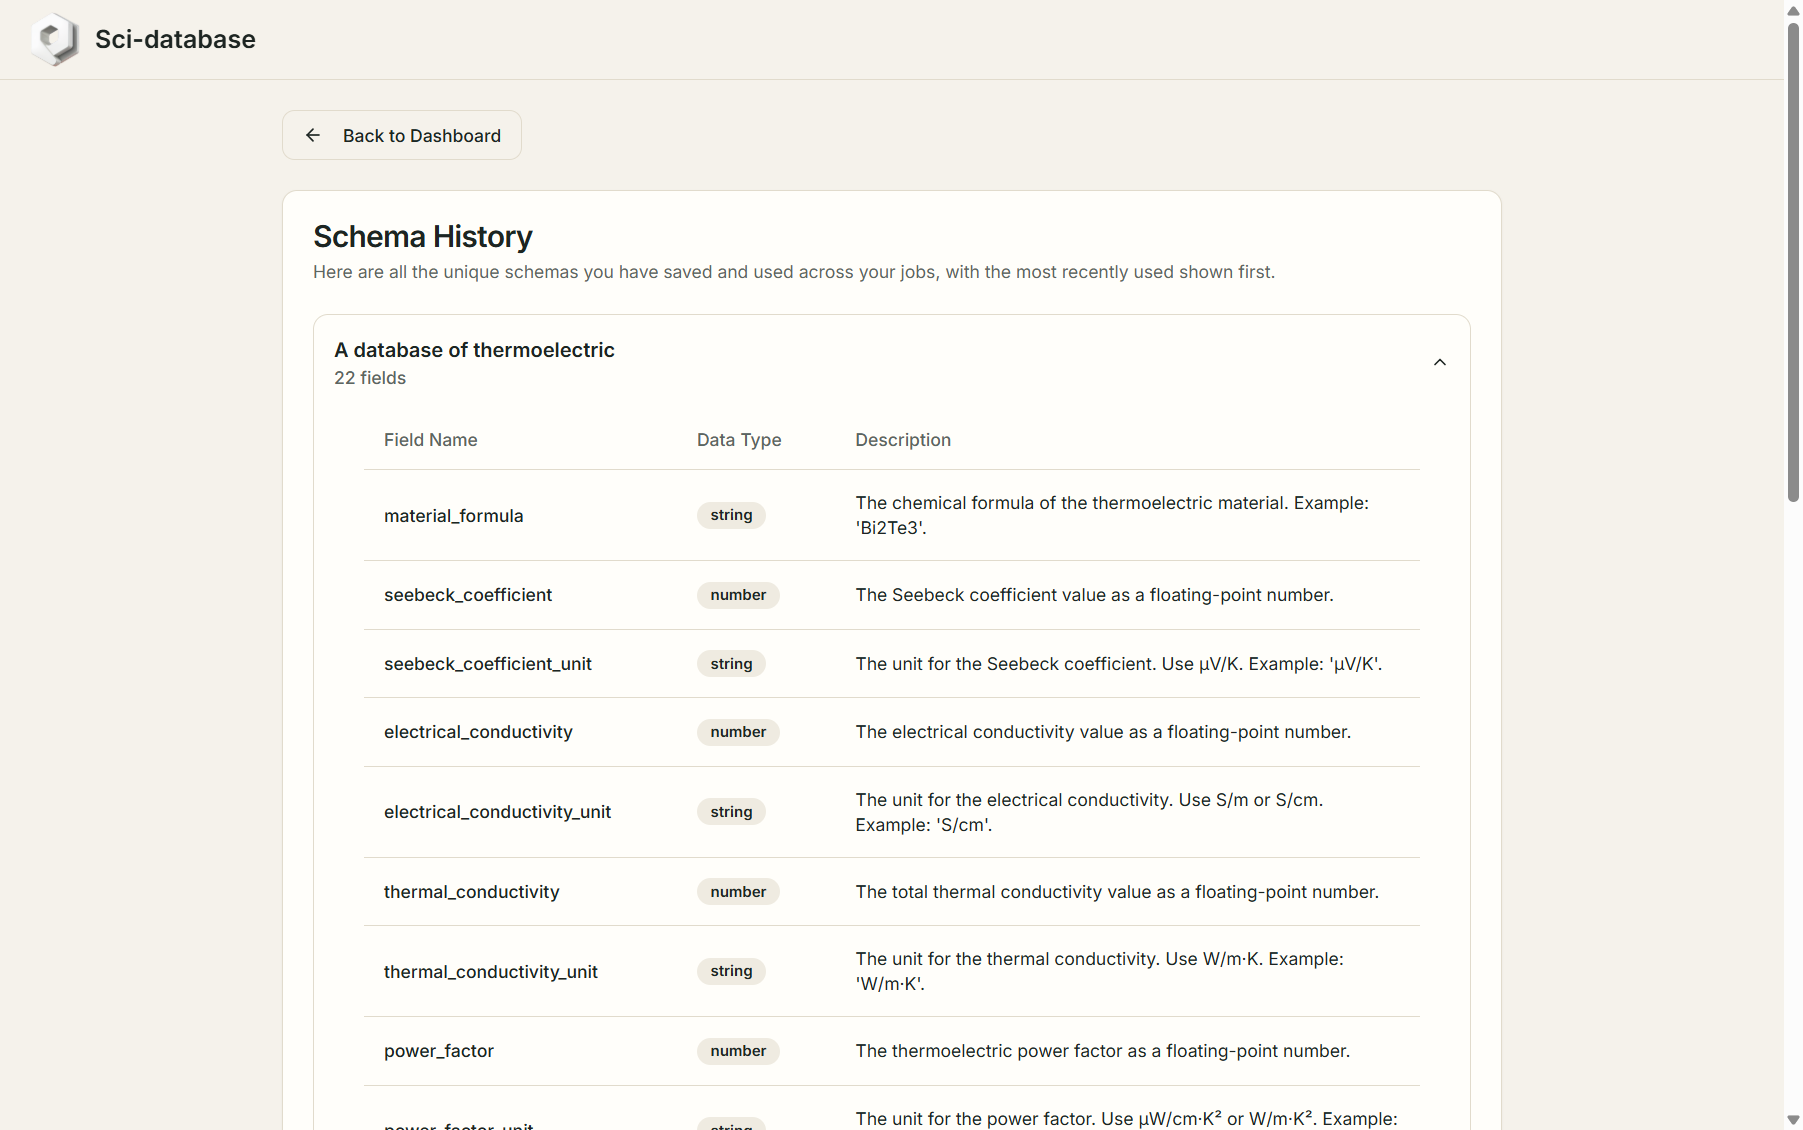
スキーマ履歴
ダッシュボードの スキーマ履歴 カードは、ジョブで実際に使用したすべての一意のスキーマを最新のものから順にリストするページへのリンクです。それぞれの完全なフィールド テーブルも含まれています。これを使用して、変更したスキーマを回復します。
パブリック スキーマから開始
パブリック ギャラリー でテンプレートを見つけましたか?任意のスキーマ ページで 「このデータベースを無料で構築する」 をクリックします。ログイン後、エディターにクローンが作成され (「スキーマが読み込まれました」)、すぐに使用または適応できます。
次: 抽出の実行 →
