第6章4 分で読める·公式マニュアル · 2026年版
Kateebエンジンによる全文読解、複数レコード抽出、合成データゼロのルールとバックグラウンド処理。
6 · 抽出の実行
検証済みのファイルがキューにあり、スキーマが保存されているので、メイン イベントの準備は完了です。
仕事を始める
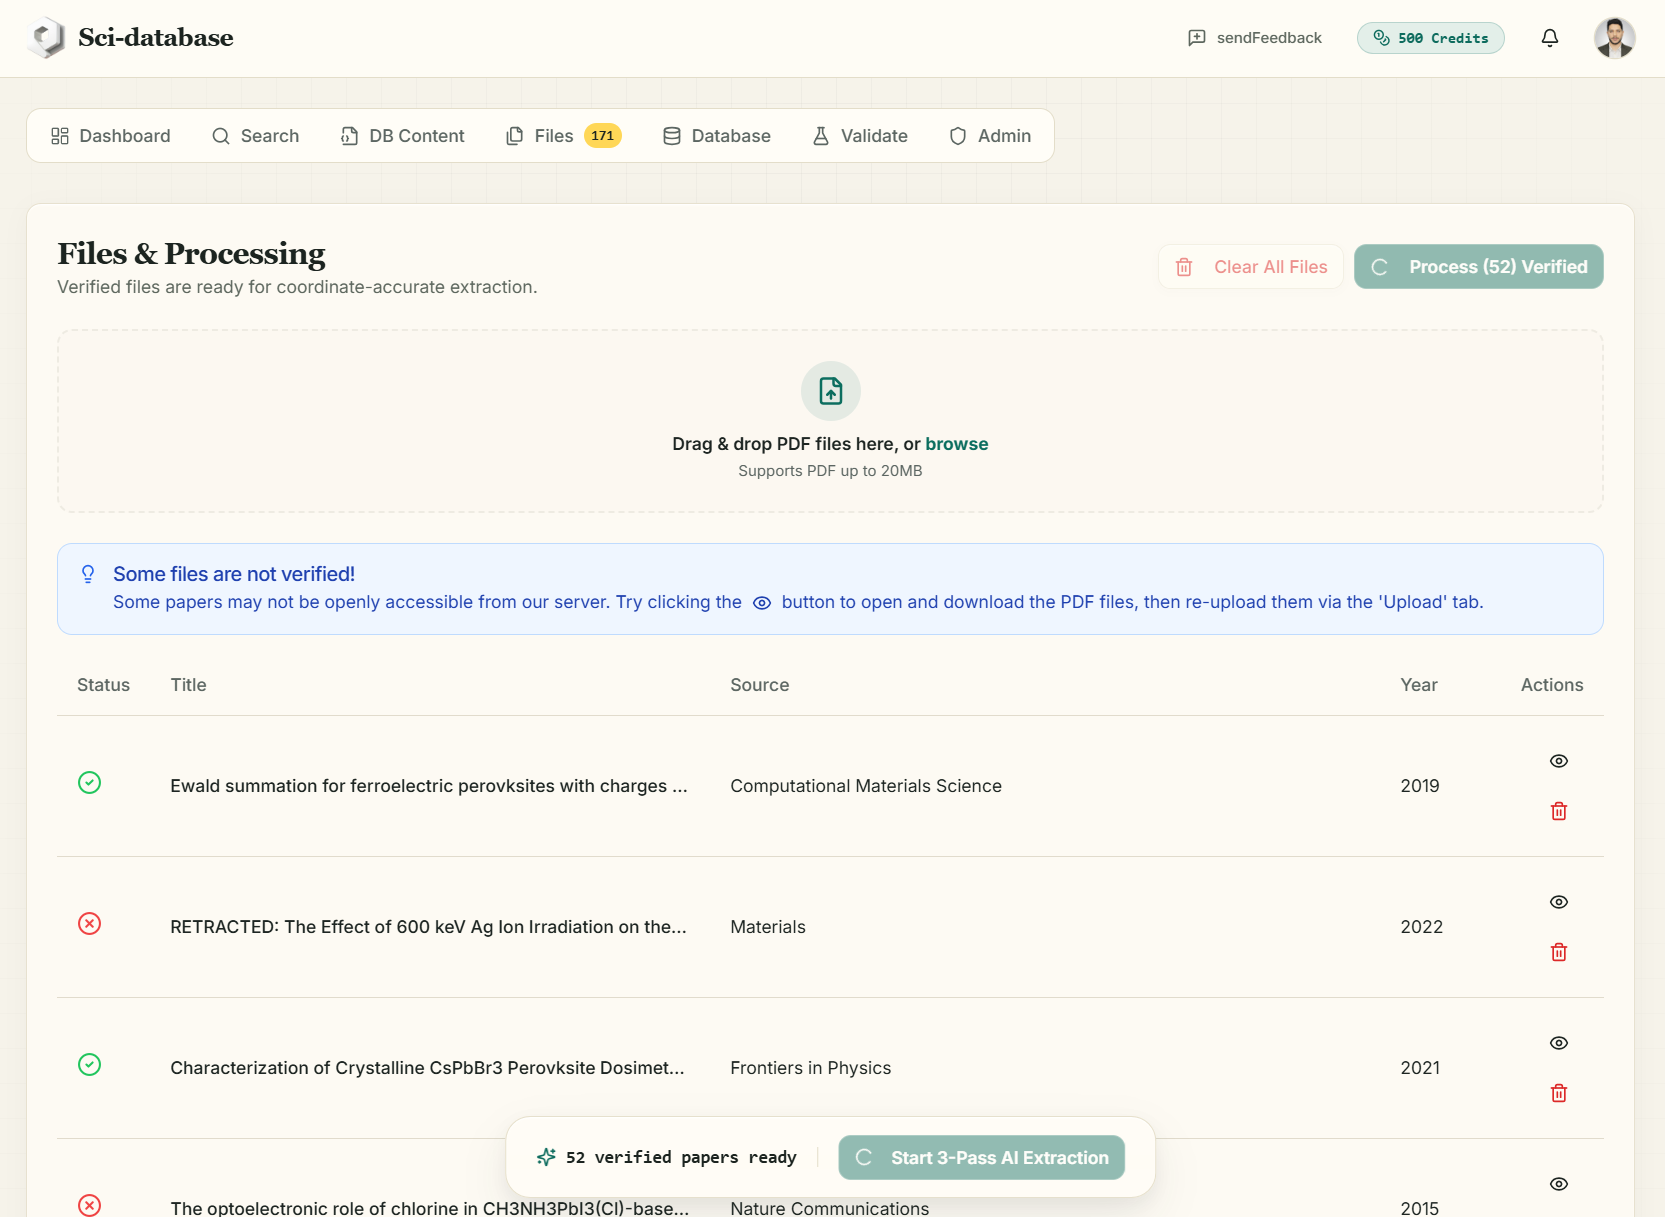
[ファイル] タブで、プロセス (N) 検証済み (または、フローティング ドックで 3 パス AI 抽出の開始) をクリックします。何が起こるか:
- 用紙 1 枚につき 1 クレジット が前払いされます。
- A job が作成され、論文とスキーマの永続的なスナップショットが含まれます。
- 確認メール (「Sci-database ジョブが送信されました」) が届き、トースト 「ジョブが送信されました — N 枚の論文が処理中です。」 が表示され、アプリは自動的に データベース タブに切り替えます。
ブラウザを閉じても構いません。サーバー上で処理が続行され、結果が電子メールで送信されます。
各紙はどうなるのか
書類は次の順序で一度に 1 つずつ処理されます。
- PDF がダウンロードされ、その全文が抽出されます (最大 950,000 文字、要約だけでなく論文全体)。
- Kateeb エンジンは、厳密な指示に基づいてスキーマに対してテキストを読み取ります。重要な指示は、抽出プロンプトからそのまま出力されます。
- 「スキーマに一致するすべての個別のレコードを検索」 — 1 つの論文で 複数の行 が生成される可能性があります (例: 複数の資料または研究アーム)。
- 「論文がスキーマに無関係な場合は、空の配列を返す」 — 無関係な論文はノイズではなく何も生成しません。
"* - 「数値については、紙から正確な値を抽出してください。四捨五入しないでください。」
- 抽出されたレコードとトークンの使用状況がジョブに保存されます。
進行状況を監視しています
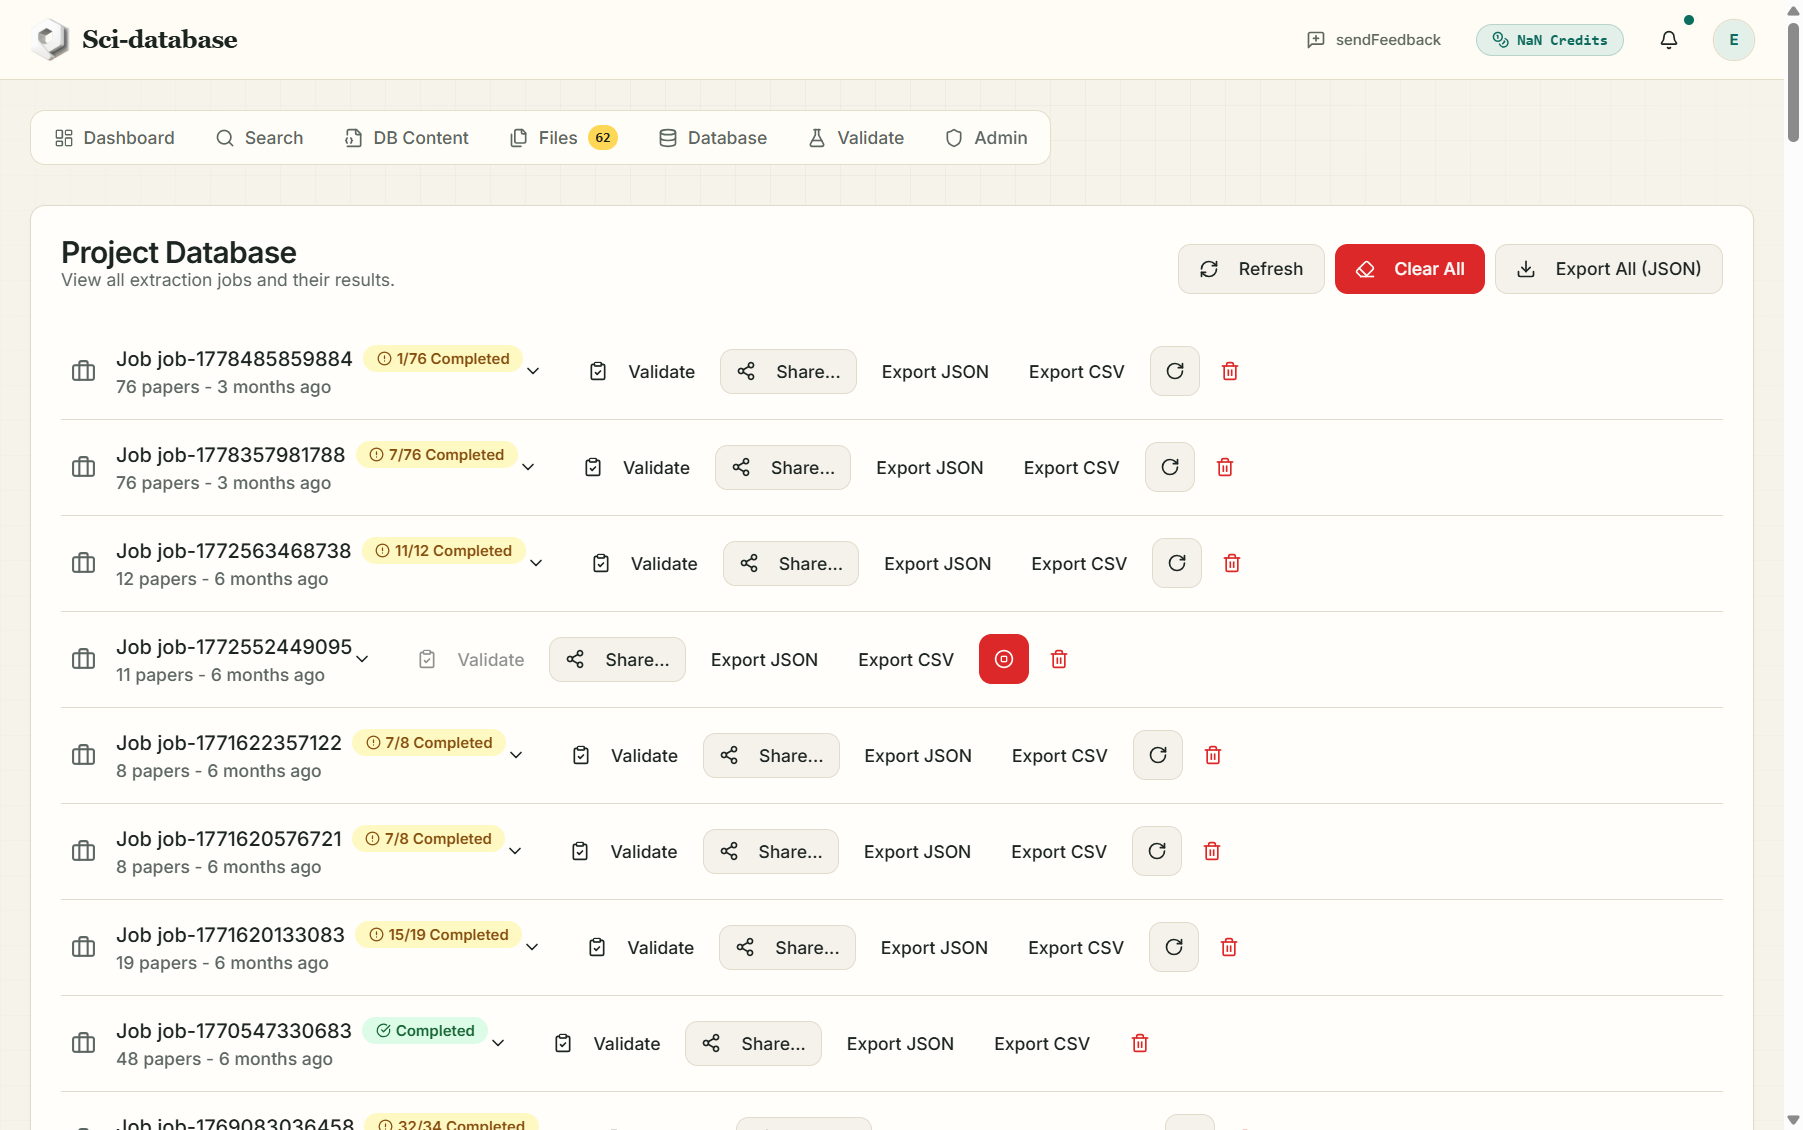
ジョブの実行中、「Database」タブは数秒ごとに自動的に更新されます。各紙にはステータスバッジが付いています。
| バッジ | 意味 |
|---|---|
| キューに入れました | 順番を待っています |
| ** 処理中** (スピナー) | 現在読んでいます |
| 完了 | 抽出完了 |
| エラー | この用紙は失敗しました (例: 読み取り不能/スキャンされた PDF) — エラー メッセージは用紙に保存されます |
ジョブレベルのステータス: 処理中 → 完了 (すべての論文が成功)、「X/Y 完了」 (部分的に成功 - 一部の論文が失敗)、または エラー (どれも成功しなかった)。
停止と再開
- 停止 (ジョブ行の ⏹ アイコン) は、現在のペーパーの後にワーカーを停止します: 「ジョブが停止しました — 処理はまもなく停止します。」 すでに完了したペーパーはデータを保持します。
- 再開 (↻ アイコン) は、停止したジョブまたは部分的なジョブを再開します。 未完成の 論文のみが再キューに入れられ、再請求されます (それぞれ 1 クレジット)。完了した論文が再処理されたり、再請求されたりすることはありません。
ジョブが終了したら
- メール — 「Sci-database ジョブが完了しました」 — ** 結果 CSV が添付** されるため、アプリに戻る前でもデータベースは受信トレイにあります。
- ダッシュボードの「次のステップ」カードは、「新しいデータベースの探索」 に進みます。
スケールに関する注意事項: 1 枚の用紙が滞っただけでジョブがブロックされることはありません。用紙にエラーが発生した場合、作業者はエラーを記録して作業を続行し、ジョブは部分的な成功として終了し、そのまま再開またはエクスポートできます。
お困りですか?FAQまたはトラブルシューティングをご確認ください。
