オープンアクセスPDFの自動取得検証、ドラッグ&ドロップによる独自PDFのアップロード。
4 · ファイルとアップロード
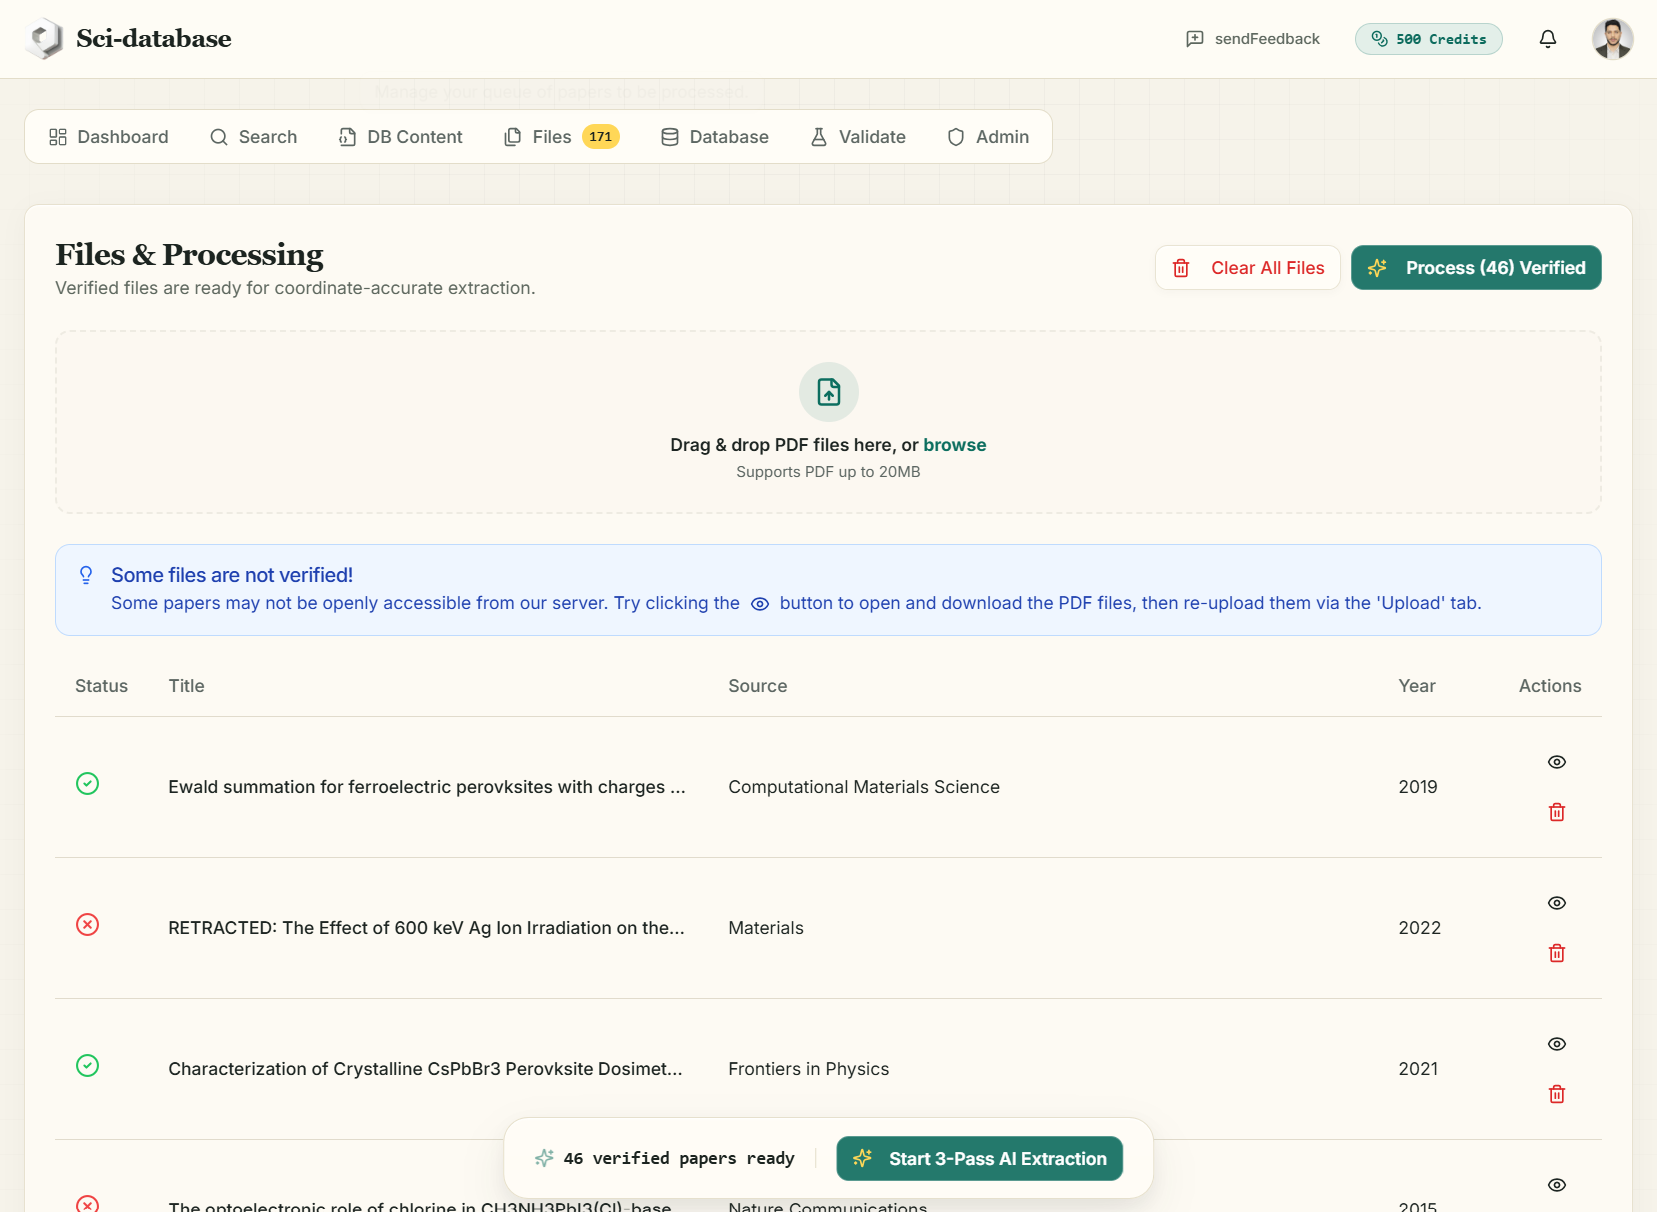
ファイル タブ (タイトル: ファイルと処理) は紙のキューです。検索または直接アップロードによって追加したものはすべてここに到達し、検証されて抽出を待ちます。
独自の PDF のアップロード
すでに論文をお持ちの場合は、検索を完全にスキップしてください: PDF ファイル をドロップゾーンにドラッグ アンド ドロップします (または 参照 をクリックします)。
- 形式: PDF のみ、ファイルあたり最大 20 MB。
- 各ファイルにはアップロードの進行状況バーが表示されます。アップロードされると、他の検索された論文と同様にキューに表示されます (ソースは「アップロードされた PDF」として表示されます)。
- アップロードされたファイルはアカウントのクラウド ストレージに非公開で保存され、キューから削除するとストレージから削除されます。
これは、PDF を自動的に取得できなかった論文のリカバリ パスでもあります (下記を参照)。
PDF の自動検証
キューに追加されたすべての論文は自動的に検証されます。サーバーは PDF のダウンロードを試行し、それが実際の読み取り可能なファイル (少なくとも 15 KB) であることを確認します。最大 10 件の論文が並行して検証され、ステータス アイコンがライブで更新されるのを確認できます。
| アイコン | ステータス | 意味 |
|---|---|---|
| ❔ グレー | 保留中 | 未チェック |
| ⏳ スピナー | 確認中 | ダウンロード中 |
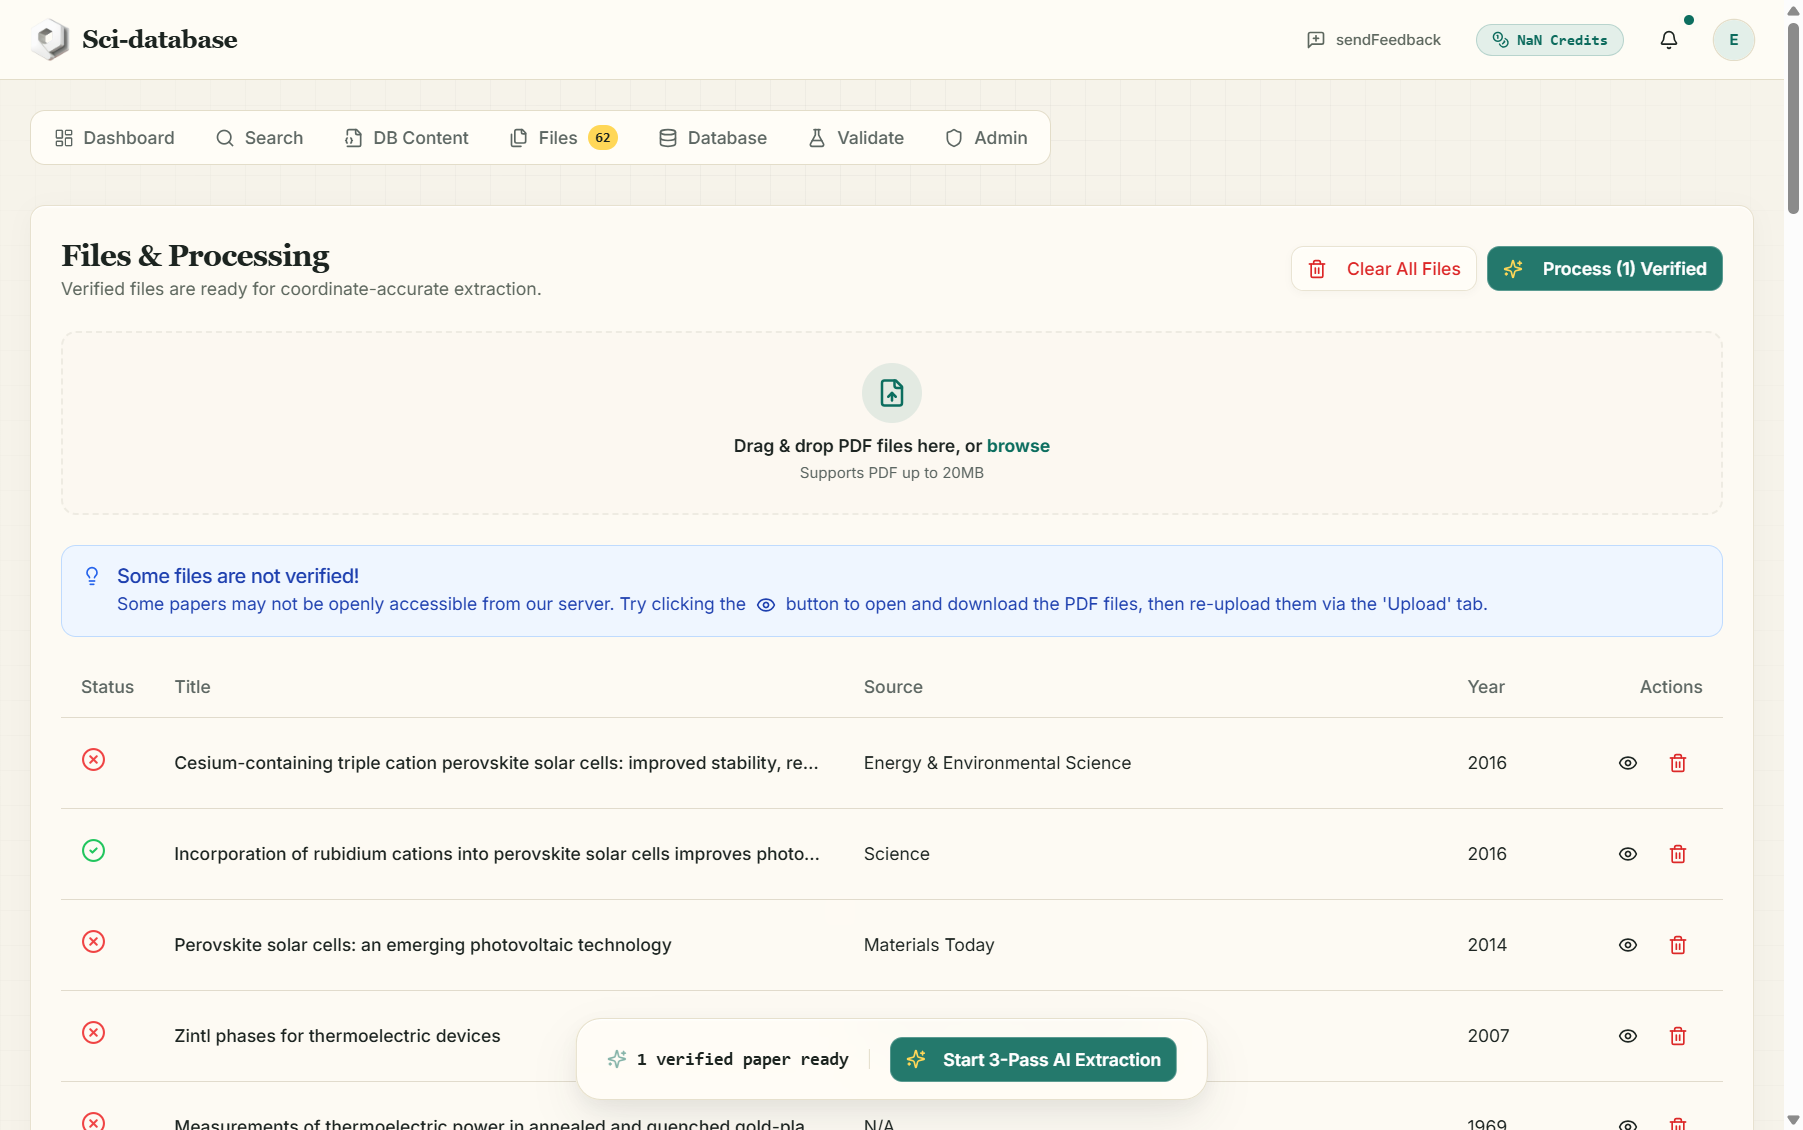
| ✅ 緑 | 確認済み | ファイルにアクセス可能で読み取り可能 — 抽出の準備ができています |
| ❌ 赤 | 失敗 | PDF を取得できませんでした (下記の理由を参照) |
認証に失敗した場合
ブラウザーで Download リンクが機能しても、一部の PDF はサーバーによって取得できません。よくある理由:
- 出版社は自動ダウンロードをブロックします (Science、Nature、Elsevier ジャーナルのペイウォール版によくあることです)。
- リンクは PDF ファイルではなくランディング ページを指します。
- リポジトリが一時的にダウンしているか、ファイルが 15 KB 未満です (通常はスタブまたはエラー ページ)。
これが発生すると、青いヒントが表示されます。
一部のファイルは検証されていません! 一部の論文はサーバーからオープンにアクセスできない可能性があります。 👁 ボタンをクリックして PDF ファイルを開いてダウンロードし、再アップロードしてみてください。
修正は簡単です:、失敗した行の目のボタン (👁) をクリックしてブラウザで PDF を開き、手動でダウンロードし、同じ [ファイル] タブの上部にあるドロップゾーンにドラッグします。アップロードされたコピーは即座に検証され、失敗した行 (ゴミ箱アイコン) を削除できます。
このハイブリッド モデルは意図的です。プラットフォームは、論文が読まれていないときに、論文が読まれたふりをすることはありません。 検証済み ファイルのみを処理できます。
キューの管理
- Eye (👁) — 論文の PDF を新しいタブで開きます。
- ゴミ箱 — キューから 1 枚の用紙を削除します (アップロードしたコピーもストレージから削除されます)。
- すべてのファイルをクリア — 確認後にキュー全体を空にします (「これにより、ファイルリストからすべての書類が削除されます。このアクションは元に戻すことができません。」)。
- キューに入れられたファイルは、処理によって消費されません****。ジョブの開始後、ファイルは削除されるまでキュー内に残るため、後で改善されたスキーマに対して再実行できます。
抽出開始
少なくとも 1 つのファイルが検証され、スキーマが保存されると (次の章)、ヘッダーの プロセス (N) 検証済み ボタンとフローティング 「N 検証済みの論文の準備完了 → 3 パス AI 抽出の開始」 ドックがアクティブになります。処理については、抽出の実行で説明します。
「ファイルを処理する前にスキーマを保存してください。」 でボタンが無効になっている場合は、まず、DB コンテンツ に移動し、スキーマの保存 をクリックします。
次: スキーマの構築 →
