Sci-databaseの概要、対象ユーザー、および学術研究における4つの信頼原則。
1 · はじめに
Sci-databaseとは何ですか?
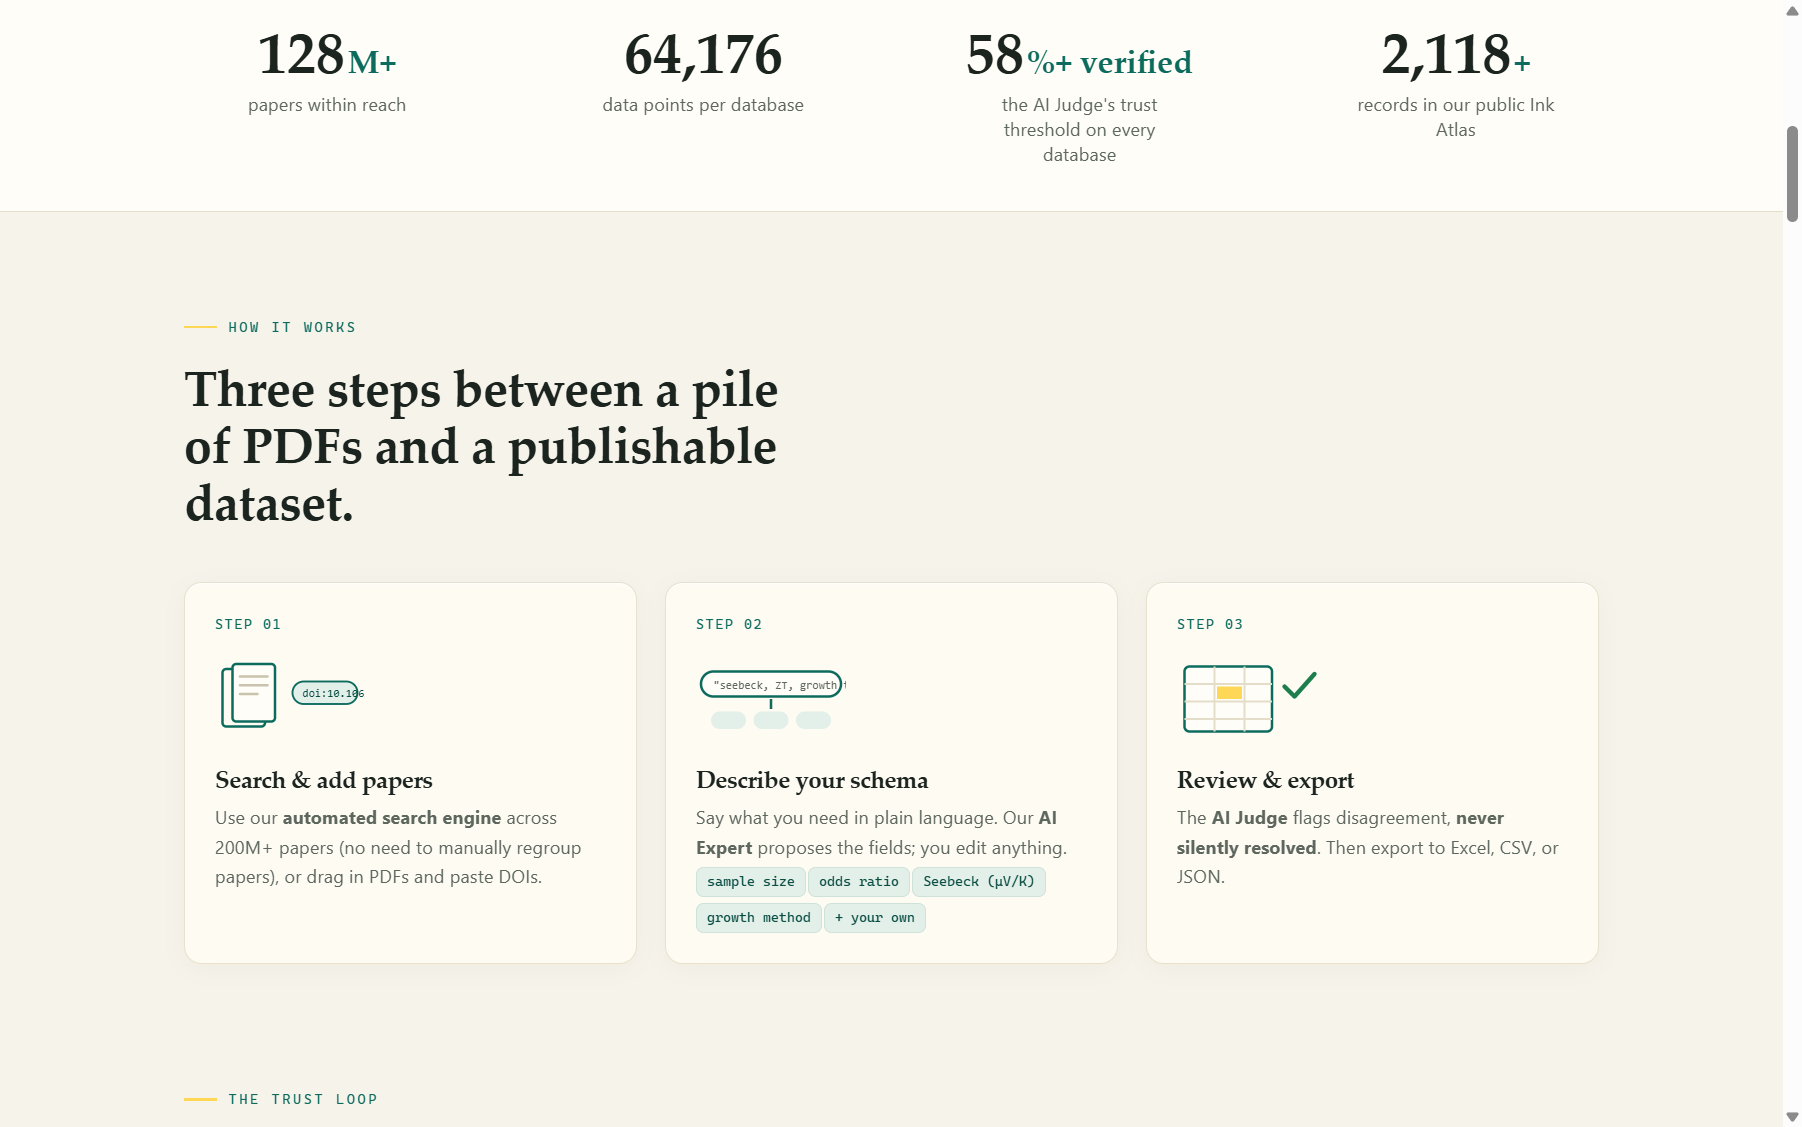
Sci-database は、研究用 PDF の山を 1 つの構造化された検証済みデータベースに変換します。何ヶ月もかけて何百もの論文からスプレッドシートに値を手動でコピーする代わりに、次のことが可能になります。
- 検索 公開リポジトリ (OpenAlex、CORE、Semantic Scholar) を通じて 2 億件以上の科学論文を検索するか、独自の PDF をアップロードします。
- 必要なデータをわかりやすい英語で説明します。AI が構造化スキーマ (将来のデータベースの列) を提案し、フィールドごとに編集できます。
- 抽出 — Kateeb エンジンは各論文を完全に読み取り、スキーマを埋めます。 1 つの論文から複数のレコードが得られることがあります (たとえば、材料ごと、または実験条件ごとに 1 行)。
- Validate — 2 番目の独立した AI モデルが論文のサンプルを再抽出し、プラットフォームがフィールドごとの比較を表示します。意見の相違にはフラグが立てられ、黙って解決されることはありません。
- データベースを Excel 対応の CSV または JSON にエクスポート — またはオープン サイエンスに貢献するために公開共有します。
誰向けですか?
| あなたは… | あなたは Sci-database を使って… |
|---|---|
| 体系的レビューアー/メタアナリスト | 数百の試験から結果、サンプルサイズ、効果サイズ、研究の特徴を抽出し、R (meta)、Stata、または RevMan |
| 材料科学者/物理学者/化学者 | レビュー論文用の特性データベース (ゼーベック係数、ZT 値、バンドギャップ、合成法など) を構築する |
| ML 研究者 | 文献を大規模なラベル付きトレーニング データに変換する |
| レビューを書いている研究者は誰でも | 数か月にわたる手作業のデータ入力を、午後の監視付き抽出に置き換えます |
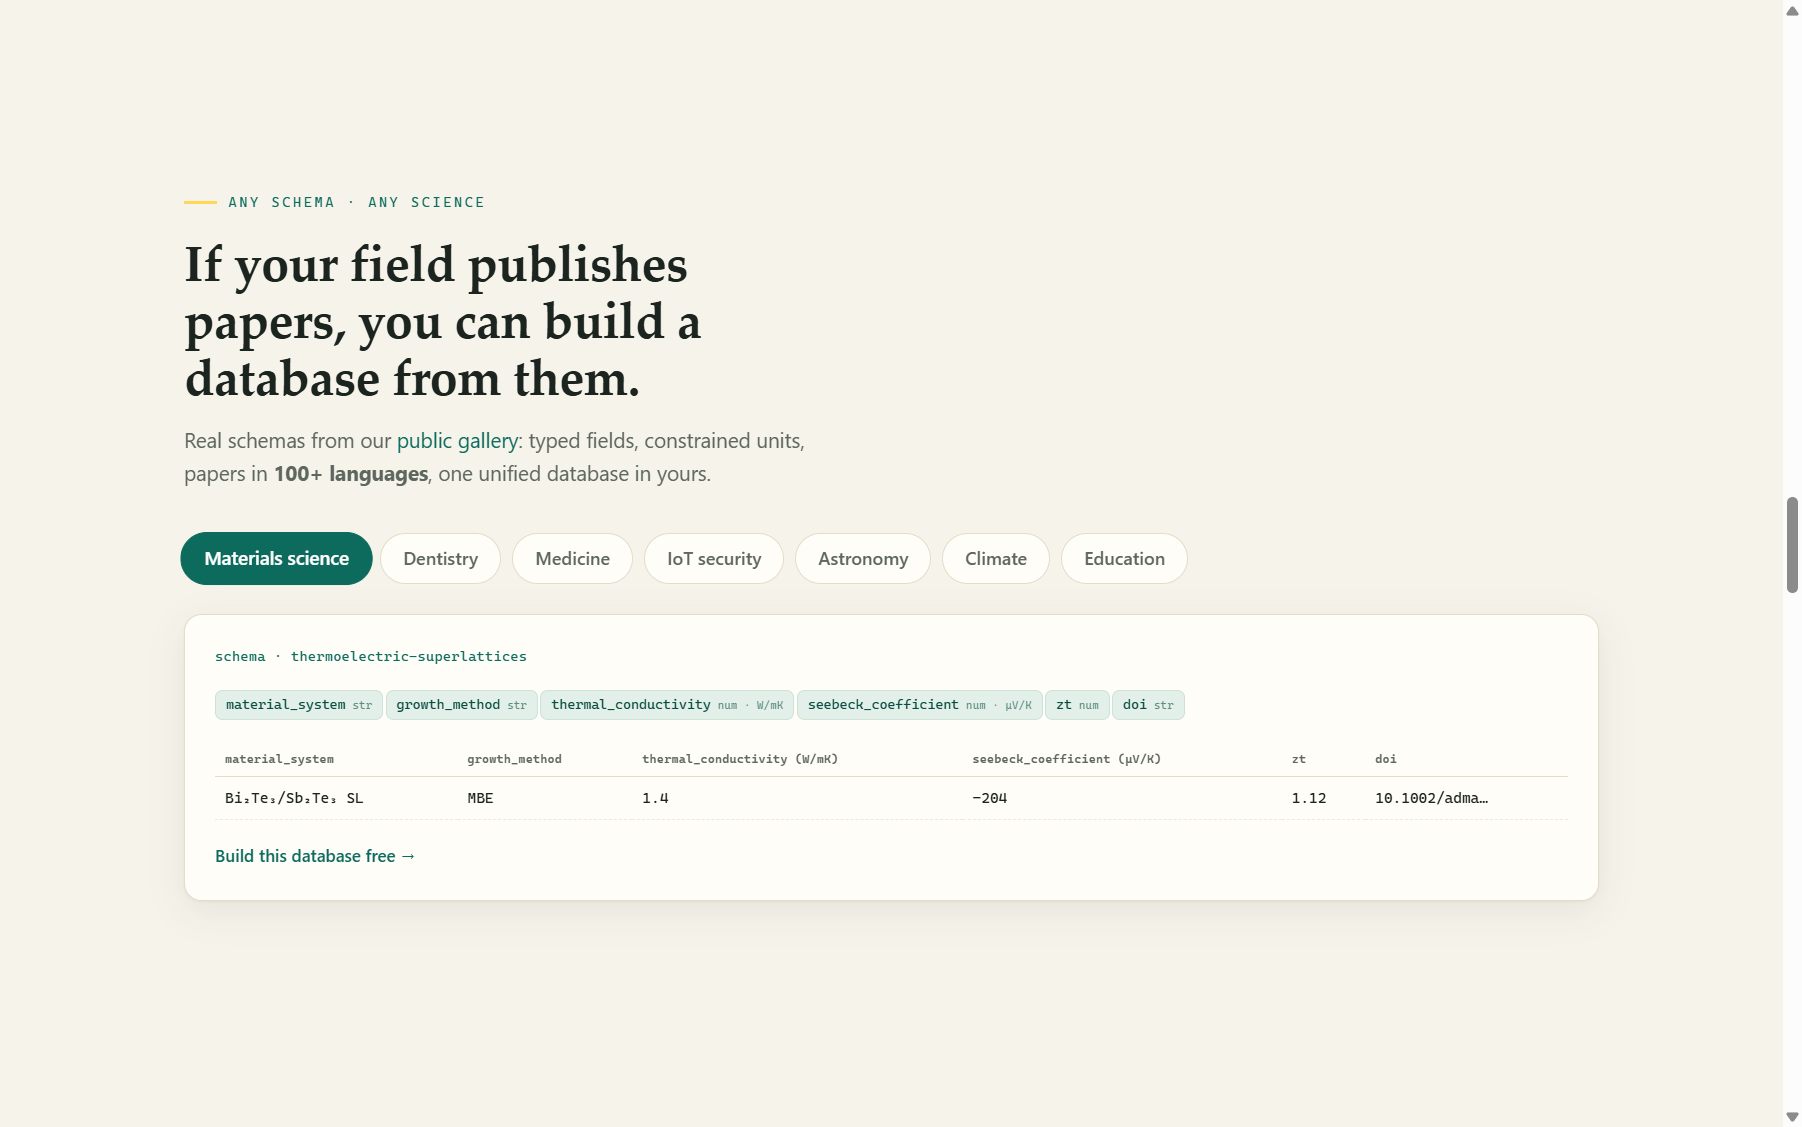
専門分野で論文が出版されている場合は、そこからデータベースを構築できます。プラットフォームはドメインに依存しません。熱電、歯科用複合材料、高血圧 RCT、IoT セキュリティ、超新星観測、気候予測などの公開スキーマがすでに存在しています。
信頼の原則
Sci-database は学術用途向けに構築されており、メタ分析での間違った数値は、欠落している数値よりも悪いです。製品全体には 4 つの原則が貫かれています。
1。合成データはゼロ
抽出モデルは厳密な指示に基づいて動作します。つまり、論文に値が欠落している場合、またはモデルにあまり自信がない場合は、正確に N/A を返さなければなりません。決して推測やもっともらしい捏造ではありません。
2.黙って何も解決しない
バリデーター モデルが元の抽出と一致しない場合、その不一致は赤で強調表示された比較行に 表示 で示されます。真実が何かを決めるのはあなたです (オプションで 3 番目の AI アービターの助けも借ります)。
3.収束、期待しないでください
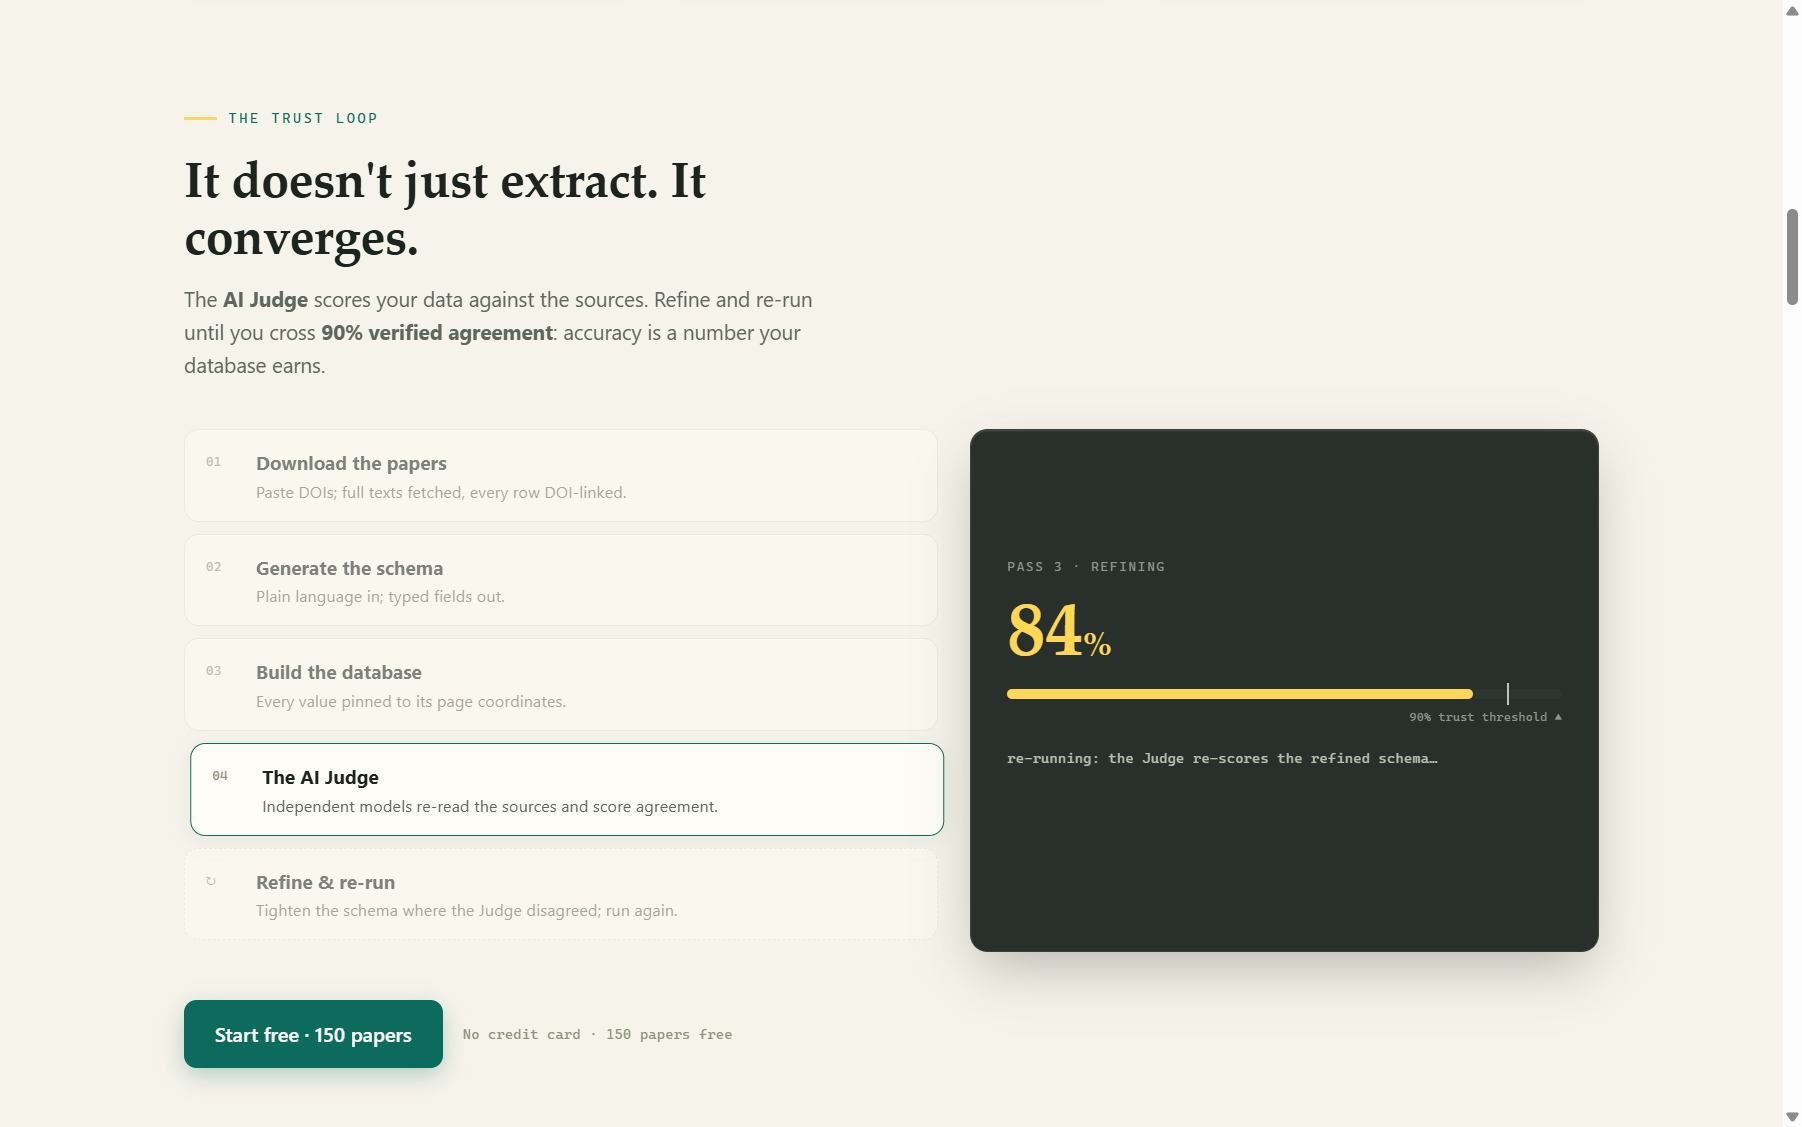
抽出は一発ではありません。意図したループは次のとおりです: 抽出 → 2 番目のモデルに対して検証 → 不一致の調査 → AI にスキーマのフィールド記述を改善させる → 再実行。各パスでは、モデル間の一致が生じます。データベースが「信頼できる」とみなされる前に、プラットフォームの信頼しきい値は 90%+ 一致 です。
4.データはあなたのもののまま
- あなたの 論文と抽出されたデータは、デフォルトではあなたのアカウントに対して非公開です。
- あなたの スキーマ (フィールド定義のみ - データなし) は、他の研究者を支援するためにパブリック ギャラリーで共有される場合があります。これは、サインアップ時に同意する規約に記載されています。
- アップロードは、モデルのトレーニングには決して使用されません。
- ファイル、ジョブ、データベースはいつでも削除できます。
Kateeb エンジン
抽出エンジンには、Kateeb (كاتب、アラビア語で 「スクライブ」) というブランドが付けられています。検証ビューでは、元の抽出列には常に「「オリジナル (Kateeb)」」というラベルが付けられるため、どのモデルがどの値を生成したかが一目でわかります。 Sci-database はハマド・ビン・ハリファ大学 (カタール、ドーハ) で開発され、特許登録されています (QF 参照: 2024-066)。
次: はじめに→
