PDF取得失敗、抽出タイムアウト、APIエラーなどの原因と具体的な対処法。
12 · トラブルシューティング
あなたが出会うかもしれないすべての注目すべきメッセージ、それが何を意味し、何をすべきか。
検索
「サーバーがビジーであるか、結果がありません — より信頼性の高い検索を行うには API キーを使用するか、後でもう一度お試しください。」
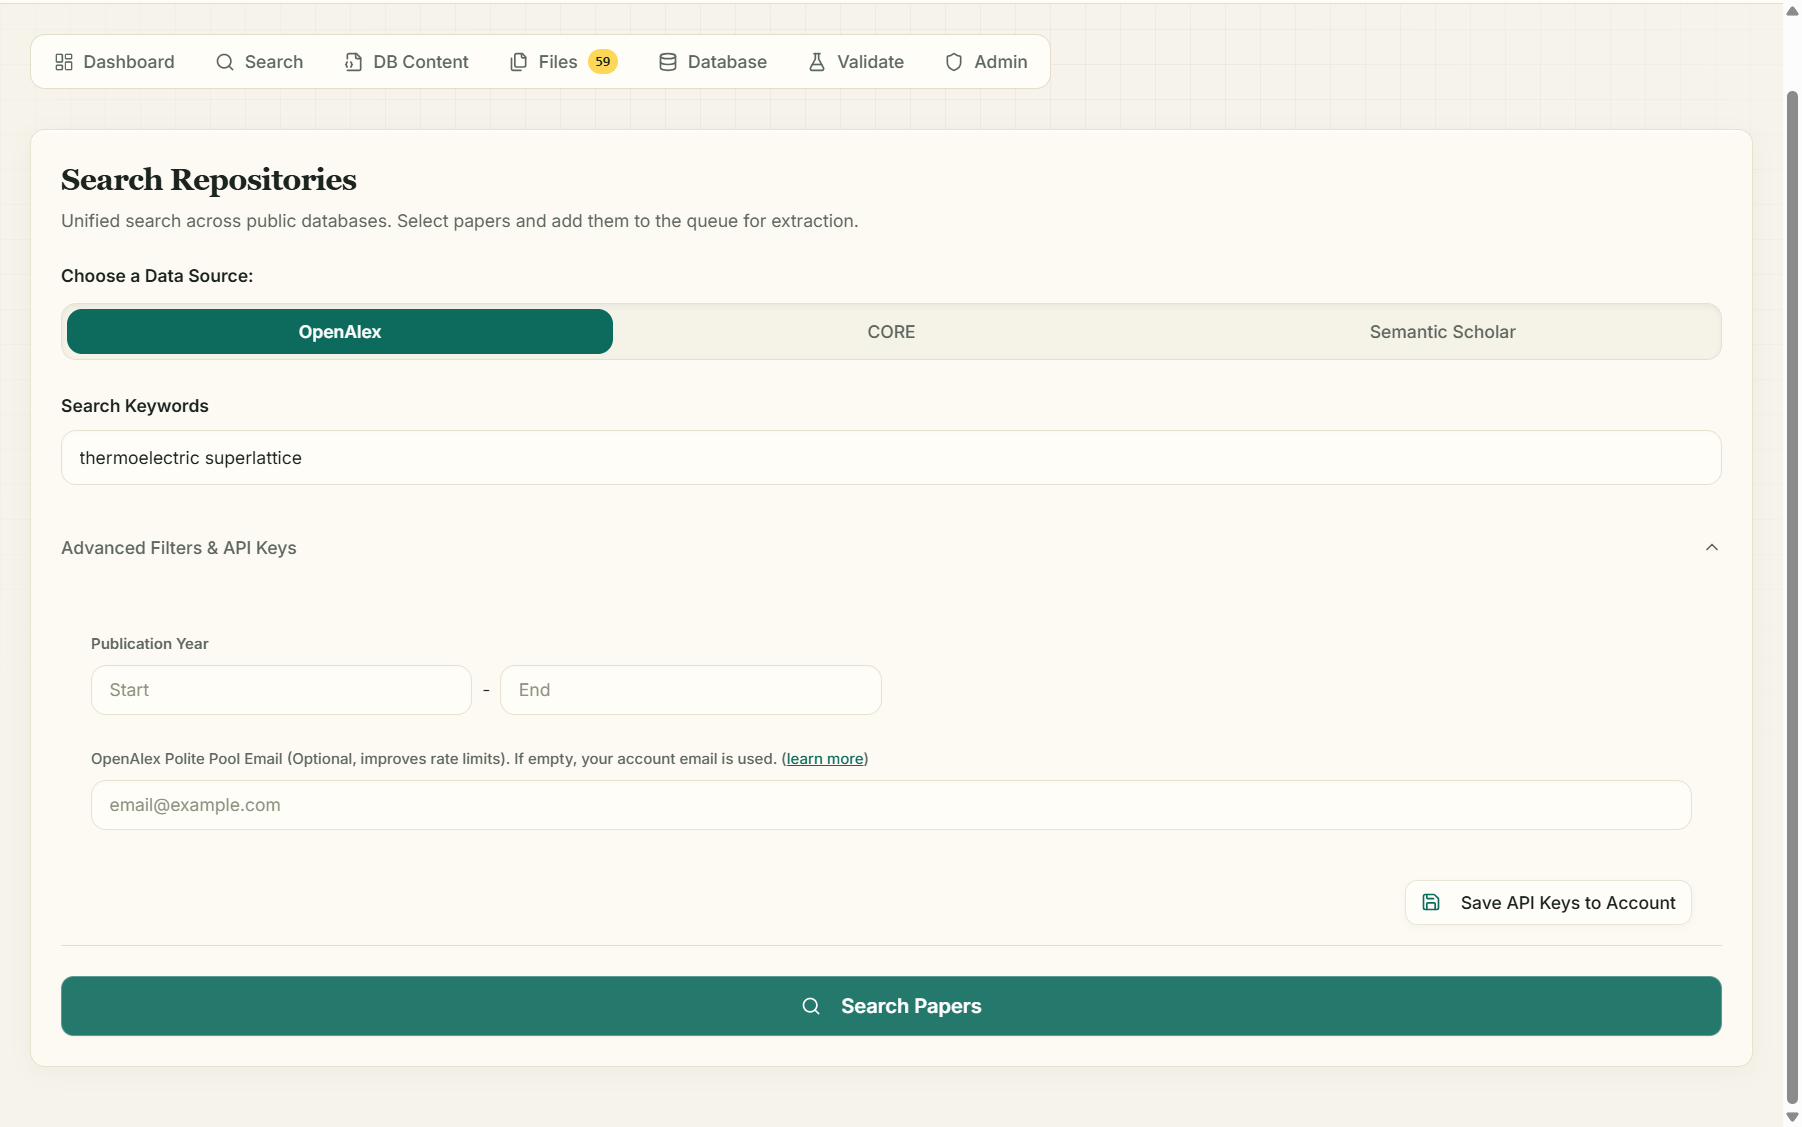
パブリック リポジトリ (OpenAlex / CORE / Semantic Scholar) がリクエストを抑制したか、使用可能なものを何も返しませんでした。有効性の順に:
- 少し待ってから再試行してください — リポジトリのレート制限は多くの場合一時的なものです (OpenAlex は、ピーク負荷時にすべての匿名検索を抑制する場合があります)。
- 高度なフィルターと API キー に (無料の) API キー を追加します。キー付きリクエストは共有匿名プールをバイパスします。 OpenAlex の場合、メールアドレスをポライトプールアドレスとして追加します。
- 別のソースを試してください — 3 つのリポジトリは異なるコーパスにインデックスを付けており、それぞれ独立して失敗します。
- オープンアクセス PDF を含む論文のみが表示されることに注意してください。ペイウォールで保護された文献に対する非常に狭いクエリでは、合法的にゼロが返される可能性があります。
「クエリは 5 つのキーワードに制限されています。全文ではなくキーワードを使用してください。」
クエリを本質的な用語に短縮します: perovskite stability humidity、「湿度下でのペロブスカイト太陽電池の安定性に関する論文」ではありません。
ファイルと検証
❌ とマークされた用紙が失敗しました / 「一部のファイルは検証されていません!」
サーバーが PDF を取得できなかったか (ペイウォール、ボットブロック、リンク切れ)、ファイルが 15 KB 未満でした (通常はエラー ページ)。 修正: 👁 をクリックして PDF を自分で開き、ダウンロードし、[ファイル] タブのドロップゾーンにドラッグし、失敗した行を削除します。検証されたファイルのみが処理されます。失敗した行はスキップされ、推測されることはありません。
「ファイル サイズが小さすぎます (…KB)」 / 「PDF を解析した結果、最小限のテキストが生成されました。ファイルは画像ベースであるか、破損している可能性があります。」
1 つ目は検証の失敗です (上記を参照)。 2 つ目は、PDF に抽出可能なテキストが含まれていない場合 (通常は スキャンされた 紙) に処理中に発生します。ファイルに対して OCR を実行して (Adobe Acrobat などで) 再アップロードするか、ボーンデジタル バージョンを見つけます。
アップロードが拒否されました
20 MB までの PDF ファイルのみが受け入れられます。
スキーマ
「ファイルを処理する前にスキーマを保存してください。」
DB コンテンツ → スキーマの保存 に移動します。処理は常に保存されたスキーマに対して実行されるため、ジョブのスナップショットは明確になります。
「AI はこのリクエストに関連するパラメータを特定できませんでした。」
あなたの説明は科学データベースとして認識できませんでした。具体的に: 領域と量の種類に名前を付けてください — 「高血圧 RCT 結果のデータベース: サンプル サイズ、介入、収縮期/拡張期の変化」。
「提案は失敗しました」(サーバー エラー)
AI 呼び出しの一時的なサーバー側の障害。 1 分以内に再試行してください。問題が解決しない場合は、ヘッダーに フィードバックを送信 を使用し、問題が発生した時刻を含めます。
クレジット
「クレジットが不足しています」 / 「クレジットが不足しています。必須: X、利用可能: Y」
アクションには残高を超えるコストがかかります。無料のクレジット (プロフィール +50、ソーシャルシェア +50) を獲得するか、クレジットと価格設定 をご覧ください。アクションが拒否された場合は何も請求されません。
処理中
ジョブが「処理中」で停止しています
論文は厳密に一度に 1 つずつ処理され、大きな PDF はそれぞれに時間がかかる場合があります。 [データベース] タブが自動的に更新されます。本当に停止していると思われる場合は、停止を押してから、再開を押してください — 未完了の用紙のみが再充電されます。クラッシュしたワーカーによって放棄されたジョブは、約 5 分後に新しいワーカーによって自動的に盗まれるようになるため、再起動すると正常に回復します。
個々の論文で「処理に失敗しました」
論文の View シートを開いて、保存されているエラー (ダウンロードの失敗、解析できない PDF など) を読み取ります。基礎となるファイルを修正し (通常: 手動ダウンロード + アップロード)、ジョブを 再開 します。
検証
「検証制限を超えました」
1 回の検証実行で最大 20 件の論文がサンプリングされます。サンプル スライダーを下げます。統計的には、精度を推定するには、ランダムな 10 ~ 20% のサンプルで十分です。
検証中に「N 件の用紙がスキップされました」
バリデーターは各 PDF を再ダウンロードします。抽出後にリンクが切れた論文は、黙って失敗するのではなくスキップされます。
「スキーマを変更した後でのみ再調査できます。」
AI 判事はすでにこの論文の矛盾について判決を下しました。再調査を依頼する前に、何かを変更します (通常: スキーマの改善を受け入れて保存します)。
共有
「このデータベースは 10KB 未満であるため、一般に共有することはできません。」
無料共有には少なくとも 10 KB の抽出データが必要です。最初にさらに多くの書類を処理してください。
「販売用のデータベースをリストするには、抽出されたデータを含む論文が 50 件以上含まれており、かつ 50KB より大きいデータベースが必要です。」
プレミアム データベースのマーケットプレイスの品質基準。抽出を続けます。
まだスタックしていますか?ダッシュボードのヘッダーにある フィードバックを送信 をクリックするか、メッセージは開発チームに直接送信されます。または、ebentria@hbku.edu.qa に電子メールを送信してください。
戻る: ドキュメント ホーム
