Cross-model validation, investigating disagreements, and converging above 90% agreement.
7 · Validierung und der KI-Richter
Extraktion allein ist kein Vertrauen. Die Antwort von Sci-database auf „Woher weiß ich, dass meine Datenbank korrekt ist?“ ist modellübergreifende Validierung: Ein unabhängiges KI-Modell extrahiert eine Stichprobe Ihrer Arbeiten von Grund auf neu, und die Plattform zeigt Ihnen genau, wo die beiden Modelle übereinstimmen und wo nicht – Feld für Feld, Datensatz für Datensatz. Dies spiegelt die duale Extraktionspraxis systematischer Überprüfungen im Cochrane-Stil mit Modellen anstelle von Doktoranden wider.
Eine Validierung starten
Klicken Sie auf der Registerkarte Datenbank bei jedem abgeschlossenen Auftrag auf Validieren. Die Registerkarte Validieren wird mit den Setup-Steuerelementen geöffnet:
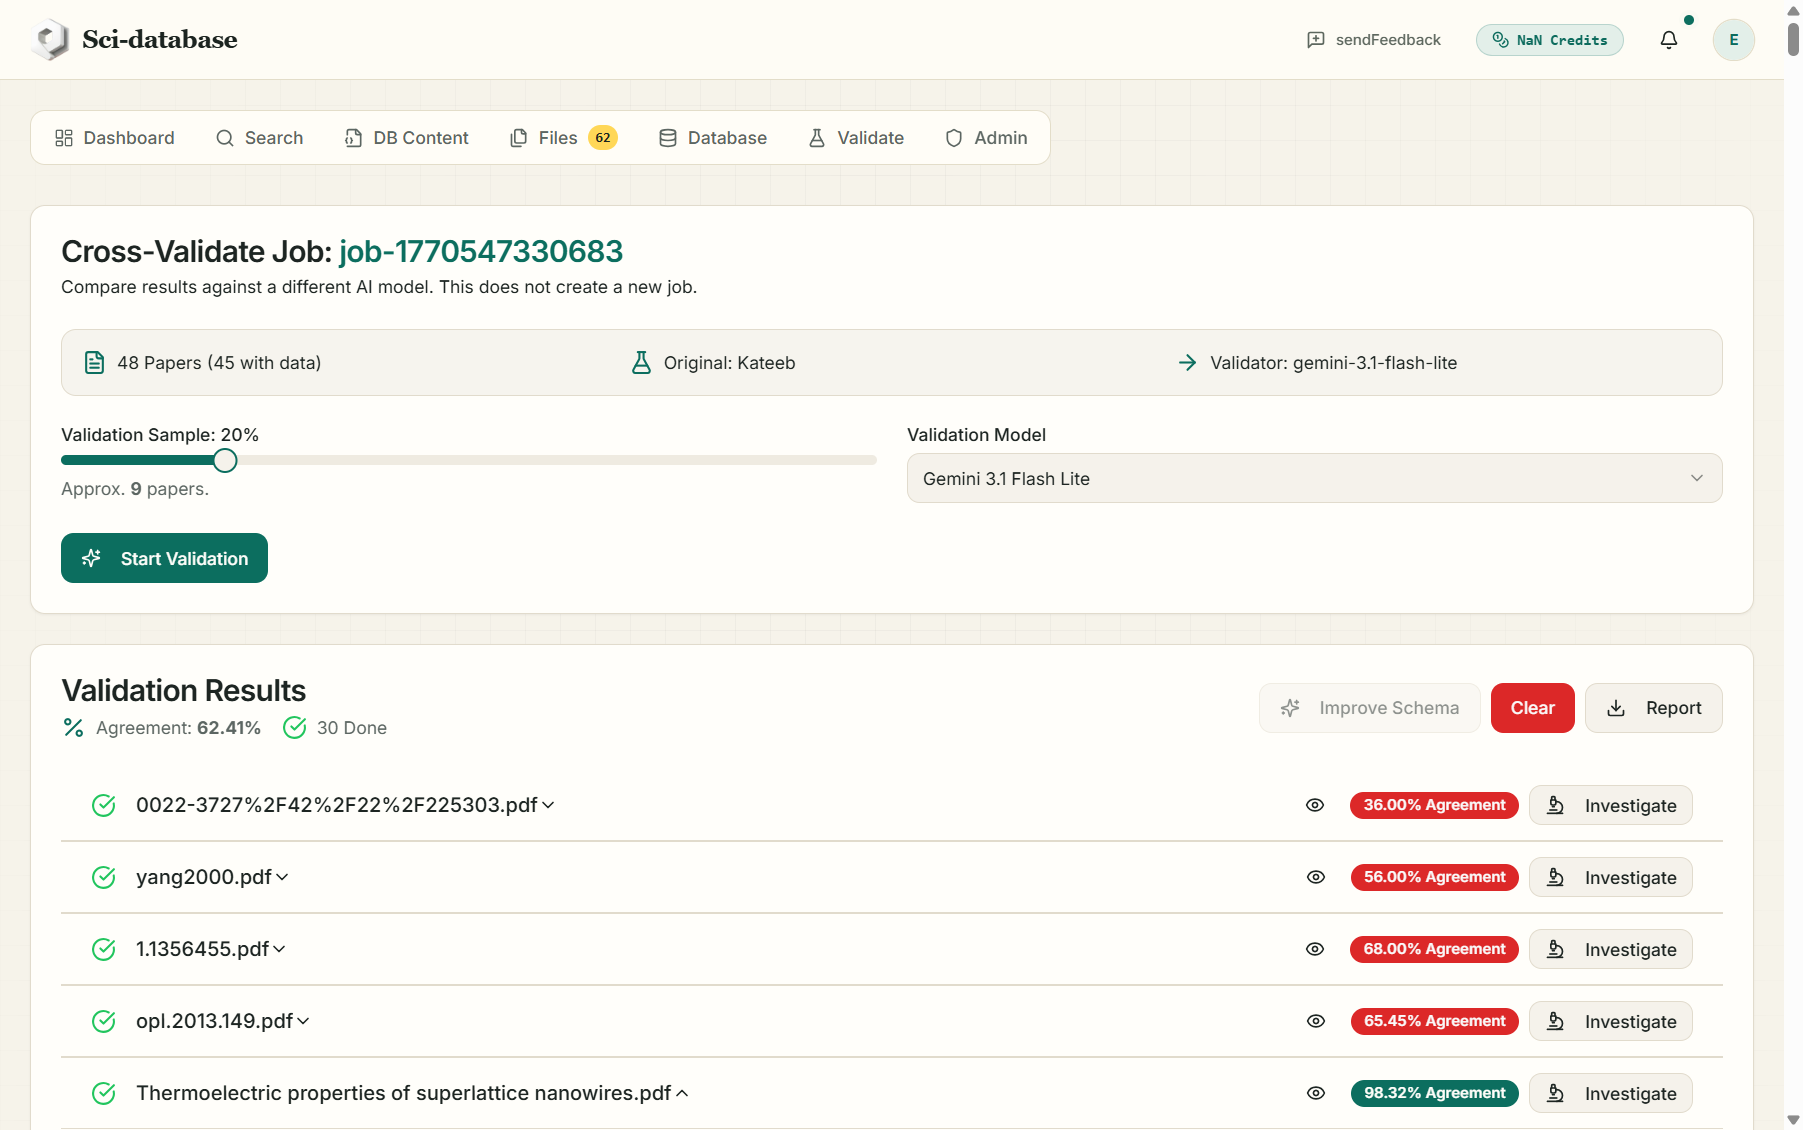
- Validierungsbeispiel – ein Schieberegler von 1–100 % (Standard 20 %) der Papiere, die Daten erzeugt haben. Sie müssen nicht alles validieren, um Ihre Genauigkeit zu ermitteln: Die Prüfung erfolgt anhand einer Zufallsstichprobe.
- Validierungsmodell – Wählen Sie den zweiten Leser:
- Gemini 3.1 Flash Lite (Standard) oder Gemini 3.1 Pro
- GPT-4o-mini (OpenAI) – bringen Sie Ihren eigenen API-Schlüssel mit
- Claude 3.5 Sonnet (Anthropic) – bringen Sie Ihren eigenen API-Schlüssel mit
Bei OpenAI/Anthropic-Modellen werden Sie in einem Dialogfeld nach Ihrem API-Schlüssel gefragt und erhalten folgende Meldung: * „Dieser Schlüssel wird nur für diese Validierungssitzung verwendet und nicht gespeichert.“*
- Validierung starten – kostet 2 Credits pro Musterarbeit. Der Fortschritt wird als "Validating i/N" angezeigt.
Das Validatormodell erhält denselben vollständigen Papiertext und dasselbe Schema, jedoch mit seinen eigenen, noch strengeren Anweisungen (analysieren Sie das vollständige Dokument, verlassen Sie sich niemals nur auf die Zusammenfassung; keine Abkürzungen; maximale Spezifität; genaue numerische Genauigkeit; N/A, wenn nicht vorhanden).
Lesen der Ergebnisse
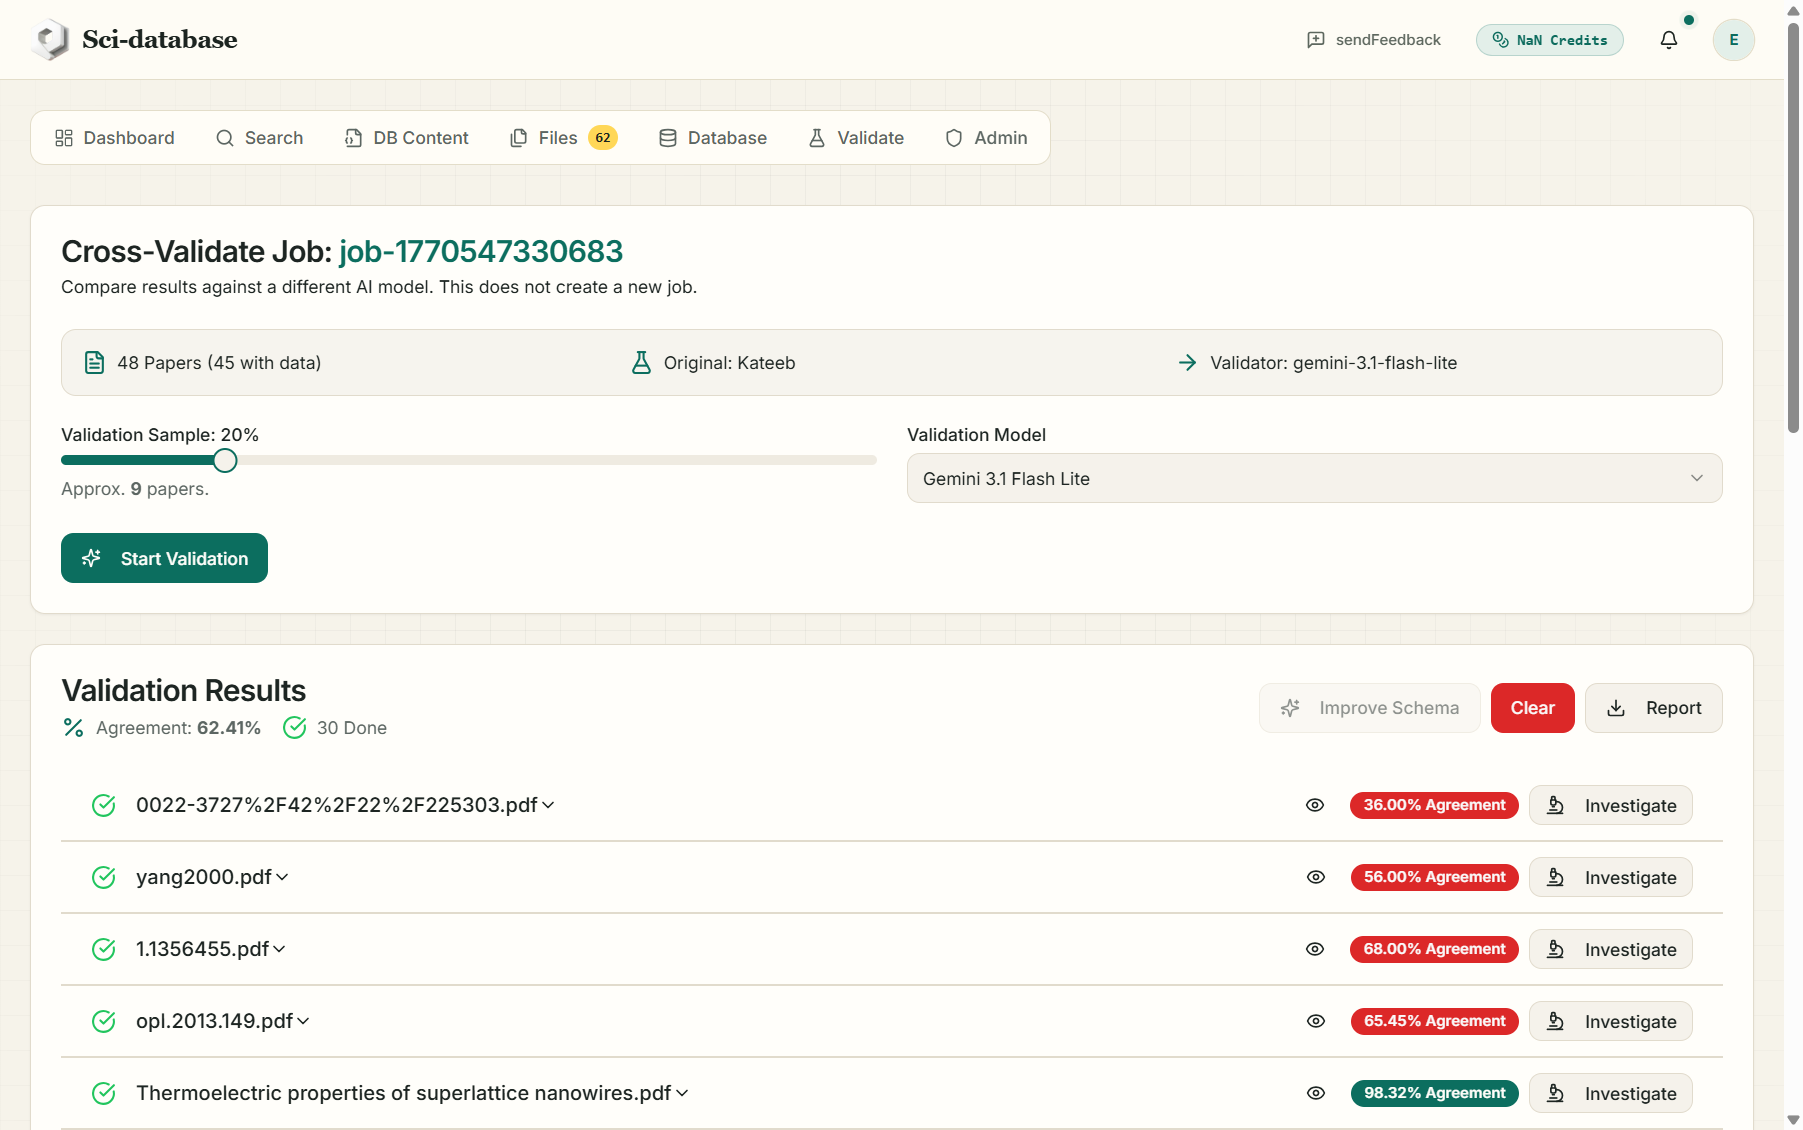
In der Kopfzeile wird der Gesamtübereinstimmungsprozentsatz für alle validierten Felder angezeigt, und jedes Papier erhält sein eigenes Zustimmungsabzeichen. Grüner Haken = volle Zustimmung; rotes Dreieck = Meinungsverschiedenheiten gefunden. Ein Feld gilt nur dann als Unstimmigkeit, wenn der Validator einen anderen nicht leeren Wert zurückgegeben hat – wenn der Validator nichts für ein Feld gefunden hat, wird das als neutral (ℹ) und nicht als Konflikt markiert.
Erweitern Sie ein beliebiges Papier, um die Tabelle Datensatzvergleich anzuzeigen:
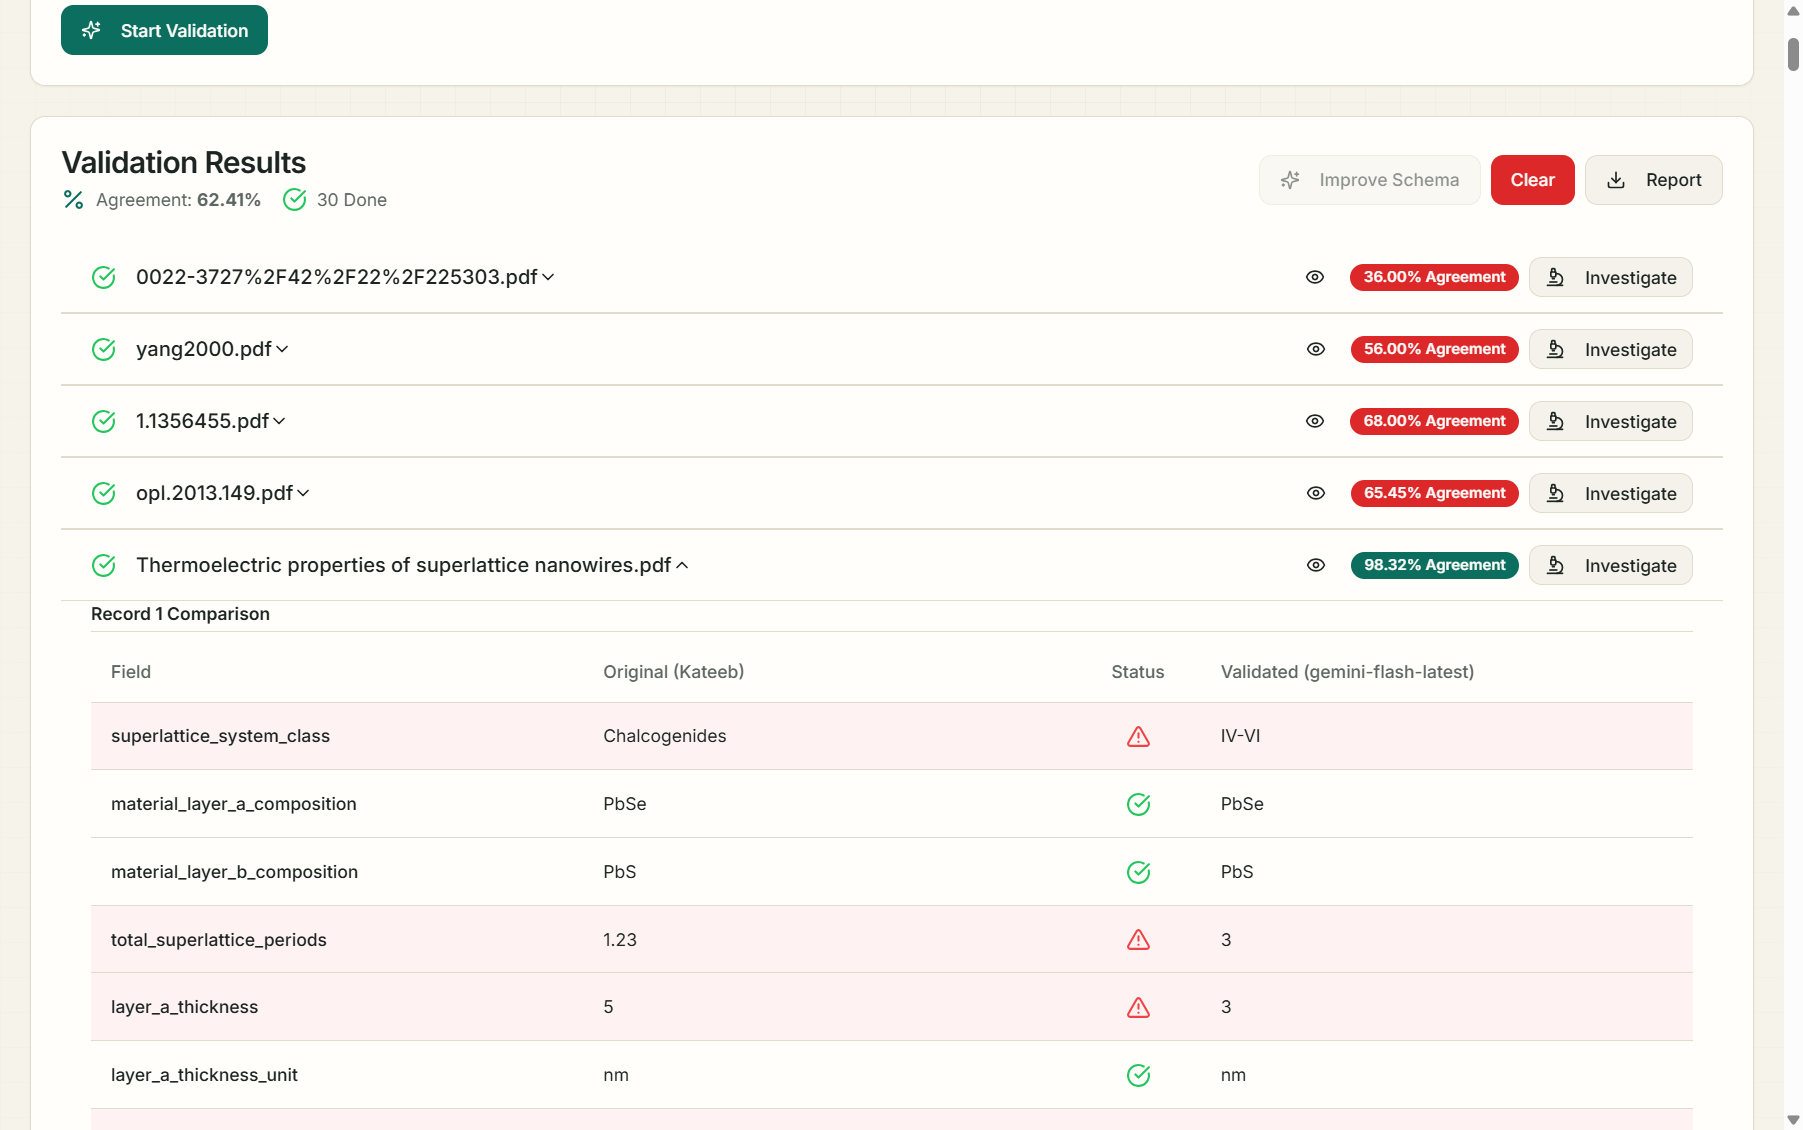
| Spalte | Inhalt |
|---|---|
| Feld | Ihr Schemafeld |
| Original (Kateeb) | Was bei der ersten Extraktion gefunden wurde |
| Status | ✅ Übereinstimmung · ⚠️ Nichtübereinstimmung (rot hervorgehobene Zeile) · ℹ️ Validator hat nichts gefunden |
| Validiert (Modell) | Was das zweite Modell gefunden hat |
Nichts wird ausgeblendet und nichts wird automatisch korrigiert: Jede rote Zeile ist eine Frage, die Ihnen die Plattform stellt.
Der KI-Richter: Untersuchung von Meinungsverschiedenheiten
Für alle Arbeiten mit weniger als 100 % Übereinstimmung klicken Sie auf Untersuchen (2 Credits pro Abweichung). Eine dritte KI fungiert als Experten-Schiedsrichter: Sie liest den vollständigen Papiertext für jedes umstrittene Feld erneut und muss entweder einen der beiden Kandidatenwerte zurückgeben, einen Wert, auf den sie direkt im Text verweisen kann, oder N/A – plus eine Begründung aus ein bis zwei Sätzen.
Das Ergebnis erscheint inline als Zeile Untersuchungsergebnis mit dem Endwert und der Begründung des Schiedsrichters. Von da an wird der vom Schiedsrichter aufgelöste Wert zur Referenz für dieses Feld: Die Übereinstimmungsbewertung wird anhand dieses Feldes neu berechnet.
Sie können den vollständigen Vergleich als Report herunterladen – ein CSV (validation_report_job_….csv) mit den Spalten Papiertitel, Datensatzindex, Feldname, Originalwert, validierter Wert, Übereinstimmung – bereit zum Anhängen an die ergänzenden Materialien eines Manuskripts.
Den Kreis schließen: Schema verbessern
Bei den meisten Meinungsverschiedenheiten handelt es sich nicht um Modellfehler, sondern um mehrdeutige Feldbeschreibungen („Effizienz“ – von was? ursprünglich oder stabilisiert? welche Einheit?). Klicken Sie auf Schema verbessern (5 Credits) und die KI analysiert die untersuchten Abweichungen und schlägt bessere Feldbeschreibungen**5⟧ vor (Namen und Typen werden nie berührt).
Jeder Vorschlag zeigt die Begründung, die alte Beschreibung (rot) und eine bearbeitbare vorgeschlagene Beschreibung (grün); Sie Akzeptieren und Bearbeiten oder Ablehnen pro Feld. Akzeptierte Änderungen landen in Ihrem Schema-Editor – speichern Sie das Schema und führen Sie dann die Extraktion erneut aus.
Konvergiert auf 90 %+
Dies ist die Vertrauensschleife, um die herum die Plattform entwickelt wurde:
  extract  →  validate (2nd model)  →  investigate (AI Judge)  →  improve schema  →  re-run
     ▲                                                                                │
     └────────────────────────────────────────────────────────────────────────────────┘
Ein typischer Verlauf über die Pässe: ~70 % Übereinstimmung beim ersten Rohlauf (Modelle sind sich bei Einheiten und mehrdeutigen Feldern nicht einig) → ~85 % nach der Verfeinerung des Schemas → 90 %+, die Vertrauensschwelle der Plattform, an diesem Punkt beschränkt sich die Meinungsverschiedenheit auf wirklich harte Urteile, über die Sie persönlich entschieden haben. Ihre Datenbank ist nun etwas, das Sie im Peer-Review verteidigen können – mit dem Validierungsbericht als Beweis.
Weiter: Ihre Datenbank und Exporte →
