What Sci-database is, who it's for, and the 4 academic trust principles.
1 · Einführung
Was ist Sci-database?
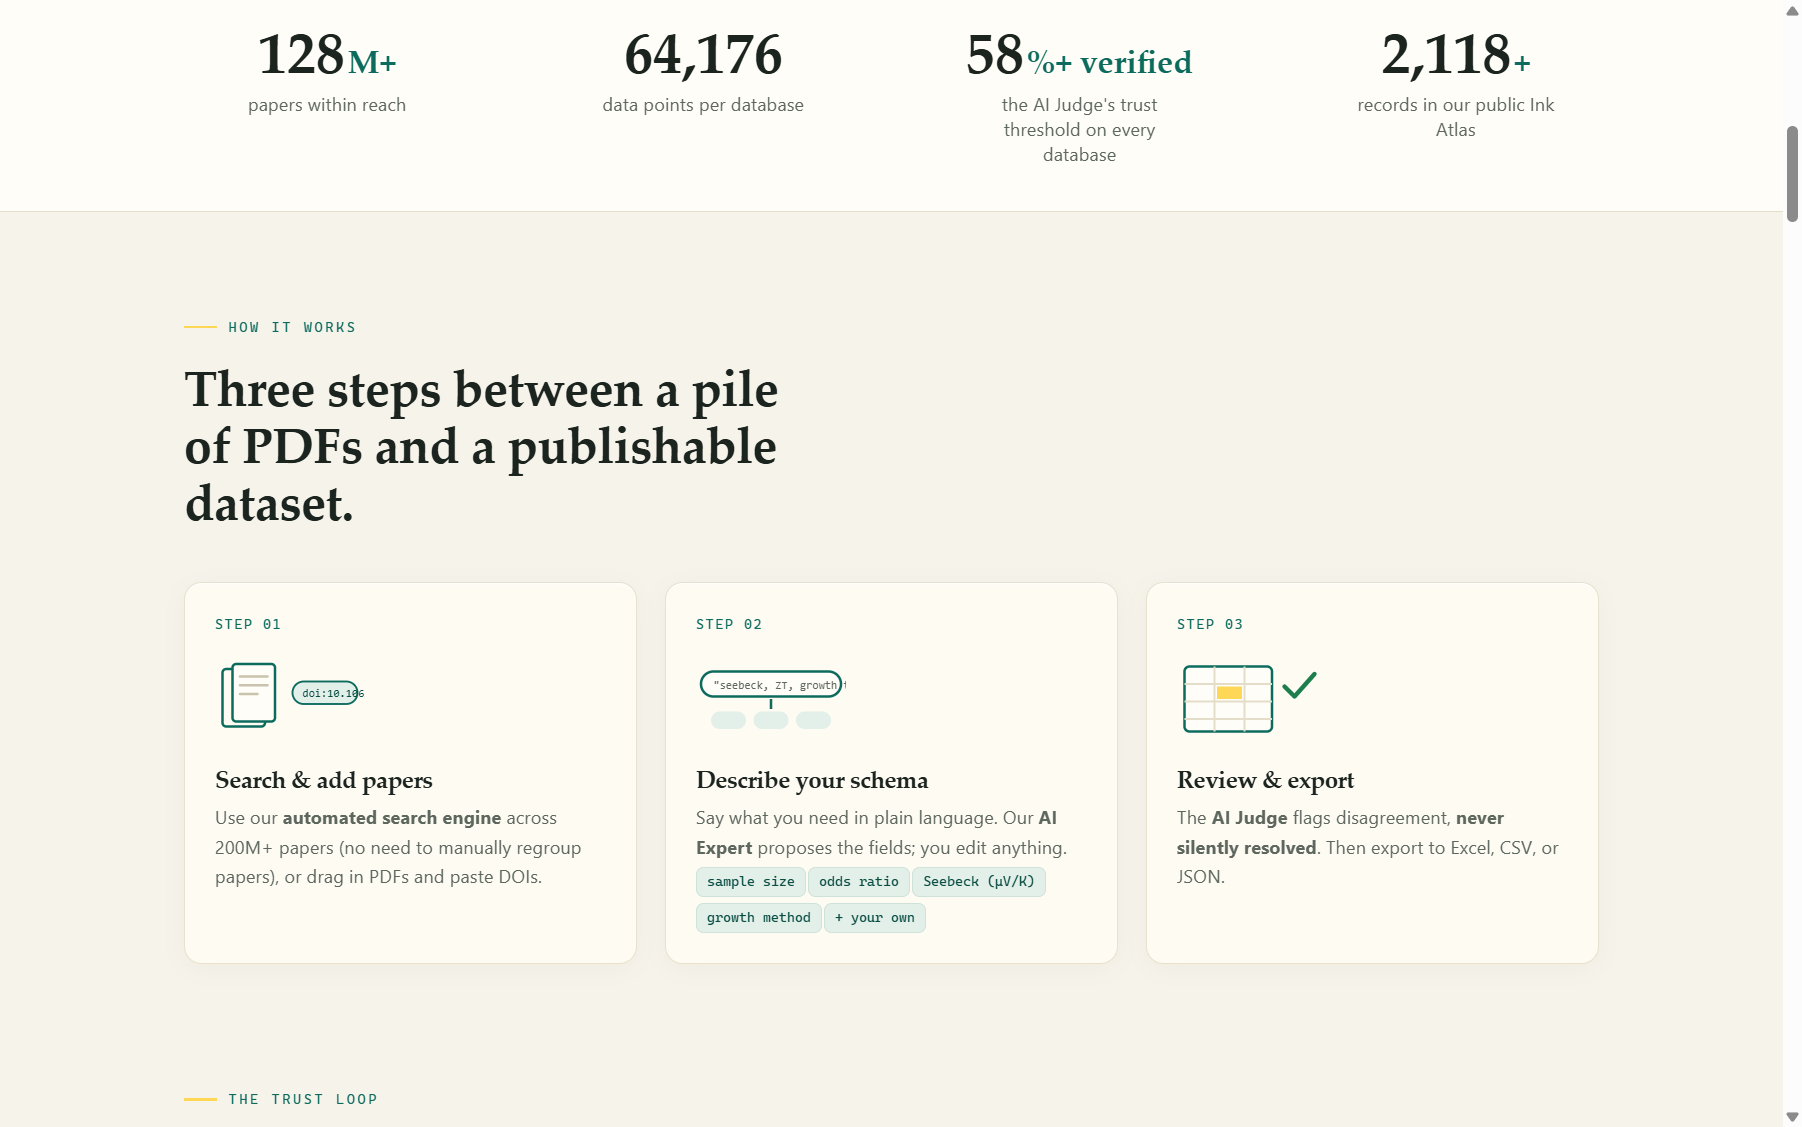
Sci-database verwandelt Stapel von Forschungs-PDFs in eine strukturierte, verifizierte Datenbank. Anstatt Monate damit zu verbringen, manuell Werte aus Hunderten von Dokumenten in eine Tabelle zu kopieren, können Sie:
- Durchsuchen Mehr als 200 Millionen wissenschaftliche Arbeiten in öffentlichen Repositories (OpenAlex, CORE, Semantic Scholar) oder laden Sie Ihre eigenen PDFs hoch.
- Beschreiben die Daten, die Sie benötigen, in einfachem Englisch – die KI schlägt ein strukturiertes Schema (die Spalten Ihrer zukünftigen Datenbank) vor, das Sie Feld für Feld bearbeiten können.
- Extract – die Kateeb-Engine liest jeden vollständigen Artikel und füllt Ihr Schema. Eine Arbeit kann mehrere Datensätze ergeben (z. B. eine Zeile pro Material oder pro Versuchsbedingung).
- Validieren – ein zweites, unabhängiges KI-Modell extrahiert eine Stichprobe Ihrer Arbeiten erneut und die Plattform zeigt einen Feld-für-Feld-Vergleich an. Meinungsverschiedenheiten werden gemeldet und niemals stillschweigend gelöst.
- Exportieren Sie Ihre Datenbank nach Excel-ready CSV oder JSON – oder teilen Sie sie öffentlich, um zur offenen Wissenschaft beizutragen.
Für wen ist es?
| Du bist… | Du verwendest Sci-database, um… |
|---|---|
| Ein systematischer Gutachter/Meta-Analyst | Extrahieren Sie Ergebnisse, Stichprobengrößen, Effektgrößen und Studienmerkmale aus Hunderten von Studien und füttern Sie dann R (meta), Stata oder RevMan |
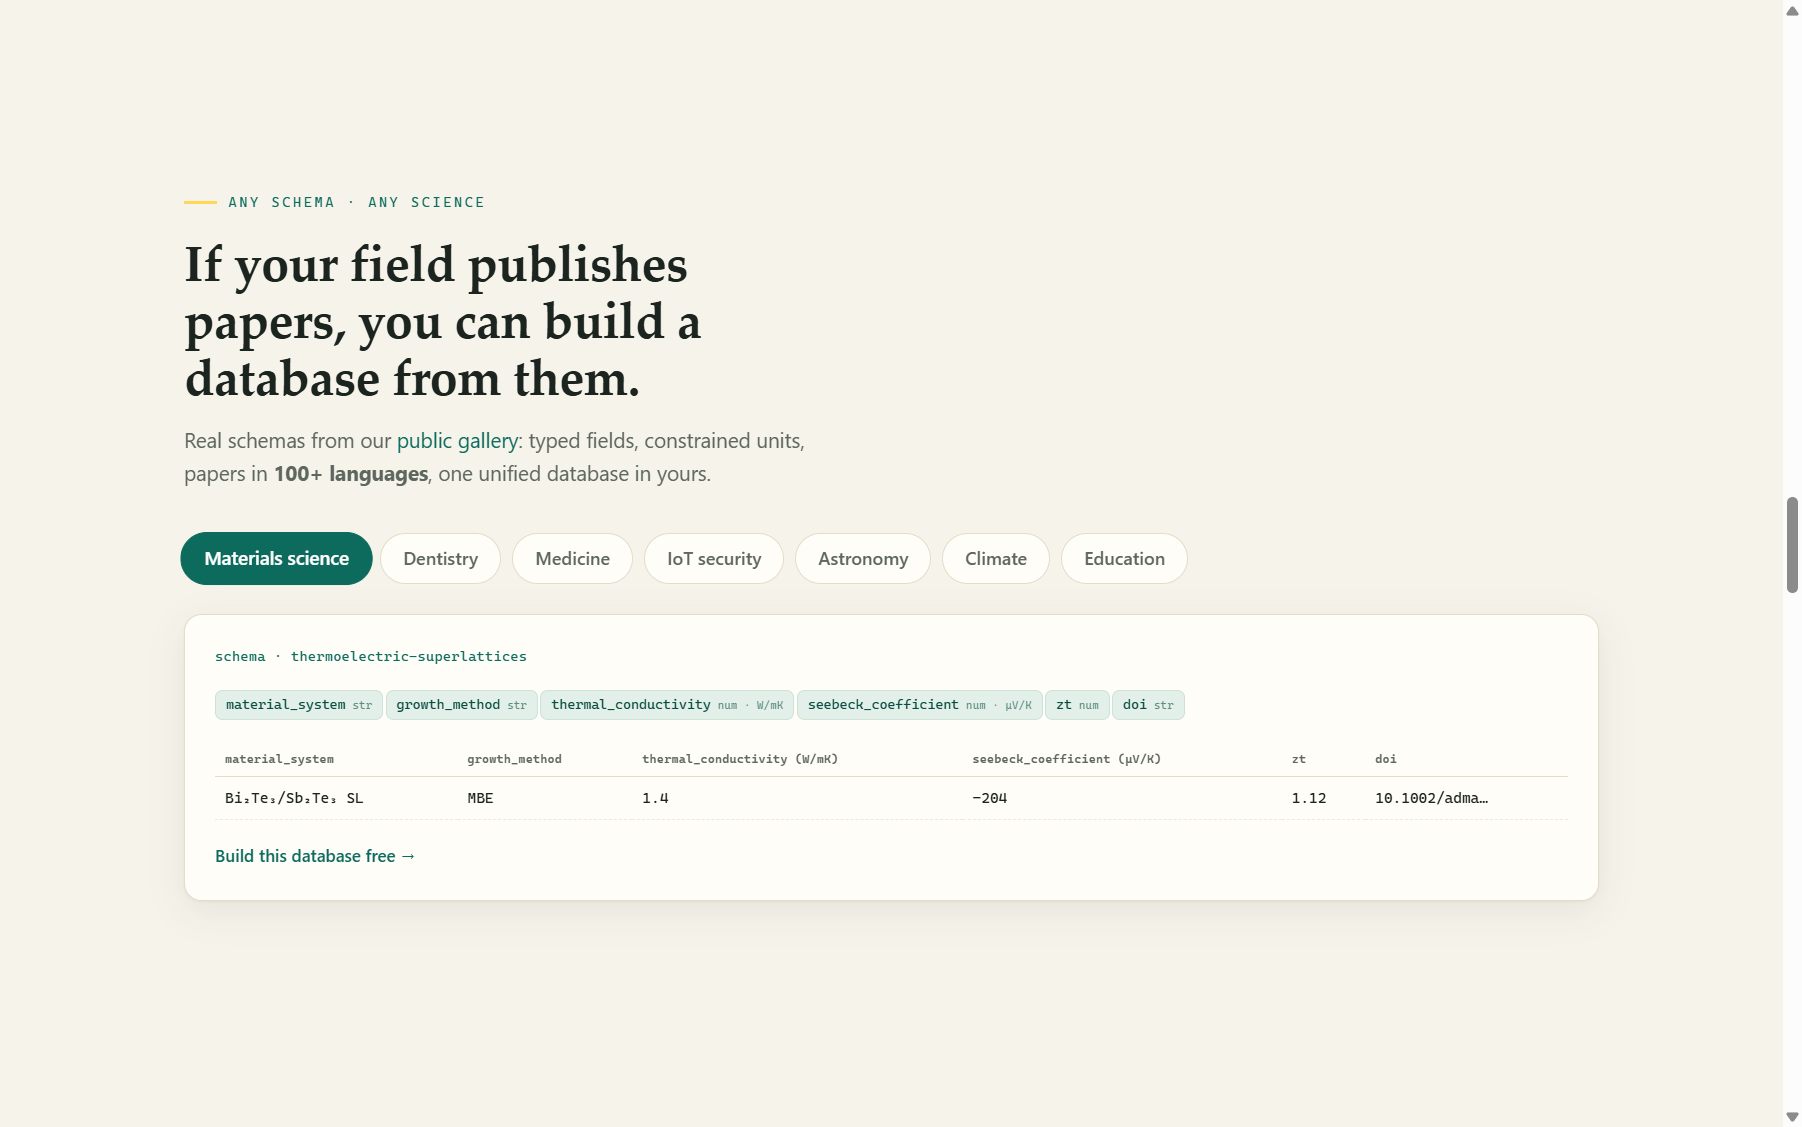
| Ein Materialwissenschaftler/Physiker/Chemiker | Erstellen Sie Eigenschaftsdatenbanken (z. B. Seebeck-Koeffizienten, ZT-Werte, Bandlücken, Synthesemethoden) für Übersichtsarbeiten |
| Ein ML-Forscher | Verwandeln Sie Literatur in beschriftete Trainingsdaten im großen Maßstab |
| Jeder Forscher, der eine Rezension schreibt | Ersetzen Sie monatelange manuelle Dateneingabe durch einen Nachmittag überwachter Datenextraktion |
Wenn Ihr Fachgebiet Aufsätze veröffentlicht, können Sie daraus eine Datenbank erstellen – die Plattform ist domänenunabhängig. Es gibt bereits öffentliche Schemata für Thermoelektrik, Dentalkomposite, Hypertonie-RCTs, IoT-Sicherheit, Supernova-Beobachtungen, Klimaprojektionen und mehr.
Die Vertrauensprinzipien
Sci-database wurde für den akademischen Gebrauch entwickelt, bei dem eine falsche Zahl in einer Metaanalyse schlimmer ist als eine fehlende. Vier Prinzipien ziehen sich durch das gesamte Produkt:
1. Keine synthetischen Daten
Das Extraktionsmodell arbeitet nach einer strengen Anweisung: Wenn ein Wert im Papier fehlt oder das Modell nicht sehr sicher ist, muss es genau N/A zurückgeben – niemals eine Vermutung, niemals eine plausibel klingende Erfindung.
2. Nichts wird stillschweigend gelöst
Wenn das Validatormodell mit der ursprünglichen Extraktion nicht übereinstimmt, wird Ihnen die Nichtübereinstimmung in einer rot hervorgehobenen Vergleichszeile angezeigt. Sie (optional mit Unterstützung eines dritten KI-Schiedsrichters) entscheiden, was die Wahrheit ist.
3. Konvergieren Sie, hoffen Sie nicht
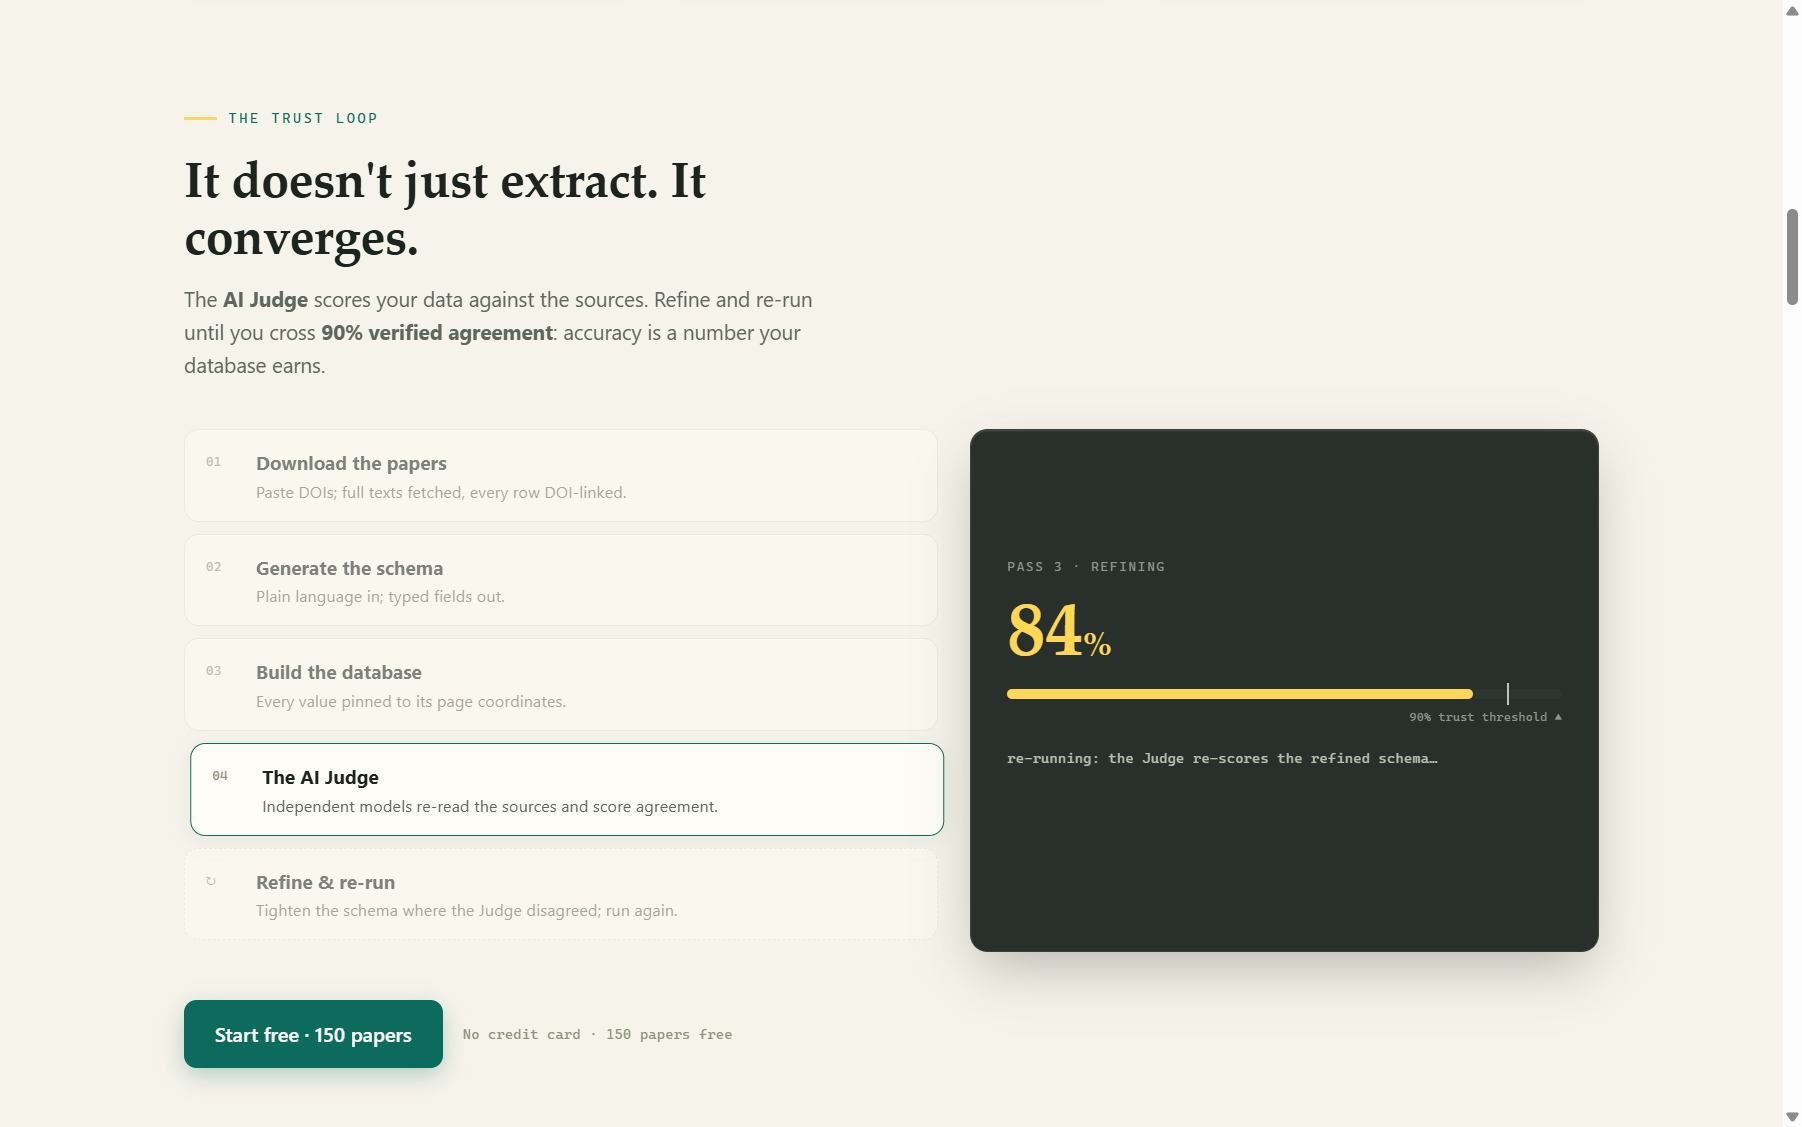
Die Extraktion ist kein einmaliger Versuch. Die beabsichtigte Schleife ist: Extrahieren → Validieren anhand eines zweiten Modells → Unstimmigkeiten untersuchen → Lassen Sie die KI die Feldbeschreibungen Ihres Schemas verbessern → Erneut ausführen. Jeder Durchgang erhöht die modellübergreifende Übereinstimmung; Der Vertrauensschwellenwert der Plattform liegt bei 90 %+ Zustimmung, bevor eine Datenbank als „vertrauenswürdig“ gilt.
4. Ihre Daten bleiben Ihr Eigentum
- Ihre Papiere und extrahierten Daten sind standardmäßig privat für Ihr Konto.
- Ihr Schema (nur die Felddefinitionen – keine Daten) kann in der öffentlichen Galerie geteilt werden, um anderen Forschern zu helfen; Dies ist in den Bedingungen angegeben, die Sie bei der Anmeldung akzeptieren.
- Uploads werden nie zum Trainieren von Modellen verwendet.
- Sie können Ihre Dateien, Jobs und Datenbanken jederzeit löschen.
Die Kateeb-Engine
Die Extraktionsmaschine trägt die Marke Kateeb (كاتب, Arabisch für „Schreiber“). In Validierungsansichten ist die ursprüngliche Extraktionsspalte immer mit „Original (Kateeb)“ beschriftet, sodass Sie auf einen Blick erkennen können, welches Modell welchen Wert erzeugt hat. Sci-database wurde an der Hamad Bin Khalifa University (Doha, Katar) entwickelt und ist zum Patent angemeldet (QF Ref: 2024-066).
Weiter: Erste Schritte →
