Every error message, why it happens, and step-by-step resolution guides.
12 · 故障排除
您可能遇到的每条值得注意的消息、其含义以及该怎么做。
搜索
“服务器繁忙或没有结果 - 请使用 API 密钥进行更可靠的搜索,或稍后重试。”
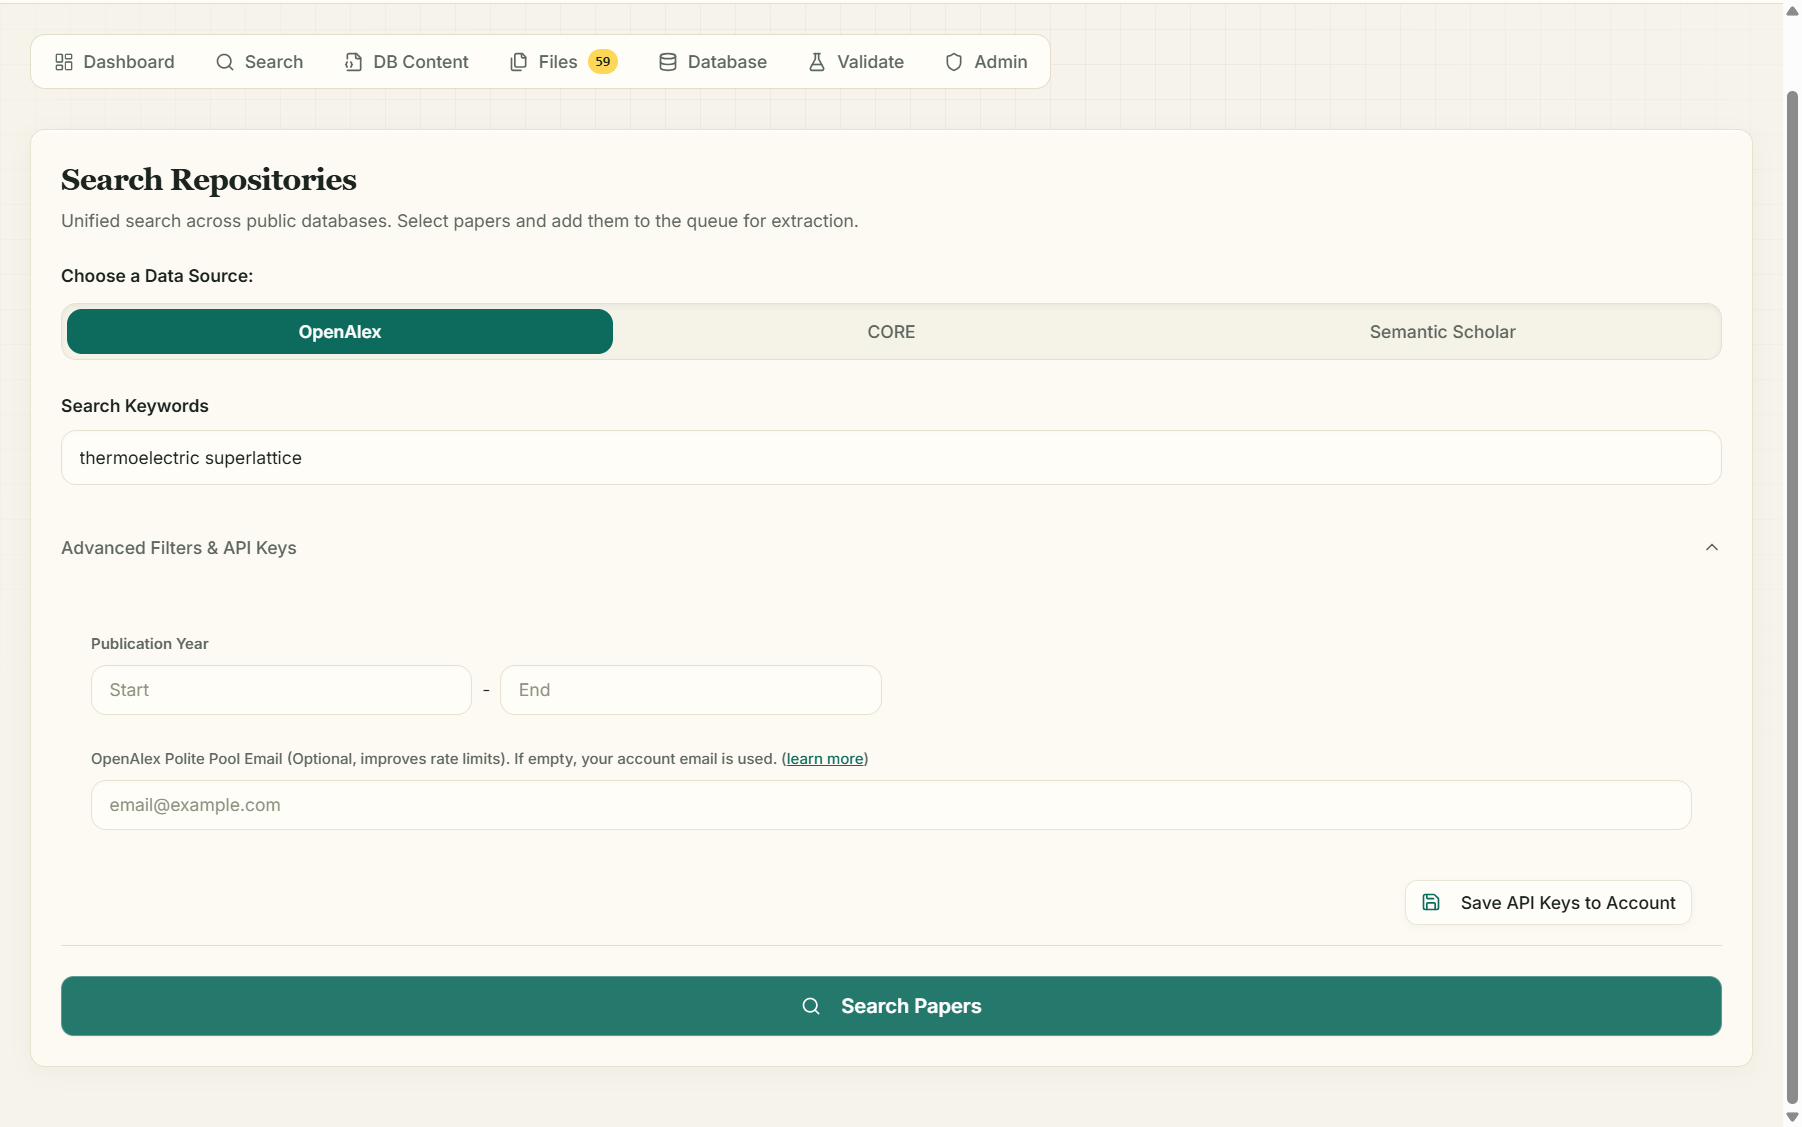
公共存储库 (OpenAlex / CORE / Semantic Scholar) 限制了请求或返回任何可用的内容。按有效性排序:
- 稍等一下并重试 — 存储库速率限制通常是临时的(OpenAlex有时会在峰值负载期间限制所有匿名搜索)。
- 在高级过滤器和 API 密钥中添加您的(免费)API 密钥 — 密钥请求绕过共享匿名池。对于 OpenAlex,将您的电子邮件添加为礼貌池地址。
- 尝试另一个来源 — 三个存储库索引不同的语料库并独立失败。
- 请记住,仅显示具有开放获取 PDF 的论文 - 对付费文献的非常狭窄的查询可以合法地返回零。
“查询仅限 5 个关键字。请使用关键字,而不是完整的句子。”
将查询缩短为其基本术语:perovskite stability humidity,而不是“关于钙钛矿太阳能电池在湿度下稳定性的论文”。
文件和验证
标记为 ❌ 的纸张失败/“某些文件未验证!”
服务器无法获取 PDF(付费专区、机器人拦截、死链接)或文件小于 15 KB(通常是错误页面)。 **修复:**点击👁自行打开PDF,下载它,将其拖到“文件”选项卡放置区中,删除失败的行。仅处理经过验证的文件 - 跳过失败的行,永远不会猜测。
“文件大小太小 (…KB)”/“PDF 解析生成的文本最少。该文件可能基于图像或已损坏。”
第一个是验证失败(见上文)。第二种情况发生在处理过程中,此时 PDF 不包含可提取的文本——通常是扫描的纸张。对文件运行 OCR(例如在 Adobe Acrobat 中)并重新上传,或查找原生数字版本。
上传被拒绝
仅接受大小不超过 20 MB 的 PDF 文件。
架构
“请在处理文件之前保存您的架构。”
转到数据库内容 → 保存架构。处理始终针对已保存的模式运行,因此您的作业快照是明确的。
“AI 无法识别此请求的相关参数。”
您的描述无法被识别为科学数据库。具体说明:命名领域和数量种类 — “高血压 RCT 结果数据库:样本量、干预、收缩压/舒张压变化”。
“建议失败”(服务器错误)
AI 调用发生暂时性服务器端故障。一分钟后重试;如果它仍然存在,请在标题中使用发送反馈 - 包括它发生的时间。
制作人员
“学分不足”/“学分不足。必需:X,可用:Y”
该操作的成本超过了您的余额。赚取免费积分(个人资料+50,社交分享+50)或查看积分和定价。拒绝操作时不会收取任何费用。
处理中
作业卡在“处理中”
一次严格处理一篇论文,每个大型 PDF 可能需要一段时间。数据库选项卡会自动刷新。如果您认为它确实停滞了,请按停止,然后按恢复——只有未完成的论文才会重新收费。崩溃的工作人员放弃的工作大约 5 分钟后就会被新工作人员自动窃取,因此重新启动后可以干净地恢复。
个别论文“处理失败”
打开论文的 View 工作表以读取存储的错误(下载失败、无法解析 PDF,...)。修复底层文件(通常:手动下载+上传)并恢复作业。
验证
“超出验证限制”
单次验证运行最多采样 20 篇论文。降低样本滑块 — 从统计角度来看,随机 10-20% 的样本足以估计准确性。
验证期间“跳过 N 篇论文”
验证器重新下载每个 PDF;自提取后链接已失效的论文将被跳过,而不是默默地失败。
“修改架构后才能重新调查。”
AI Judge 已经对本文的差异做出了裁决。在要求重新调查之前更改某些内容(通常:接受架构改进并保存)。
分享
“此数据库小于 10KB,无法公开共享。”
免费共享至少需要 10 KB 的提取数据 - 首先处理更多论文。
“要列出待售数据库,它必须包含超过 50 篇带有提取数据的论文,并且大于 50KB。”
市场上优质数据库的质量标准。继续提取。
仍然卡住?单击仪表板标题中的发送反馈——消息直接发送给开发团队——或发送电子邮件至ebentria@hbku.edu.qa。
返回: 文档主页
