What Sci-database is, who it's for, and the 4 academic trust principles.
1 · 简介
Sci-database是什么?
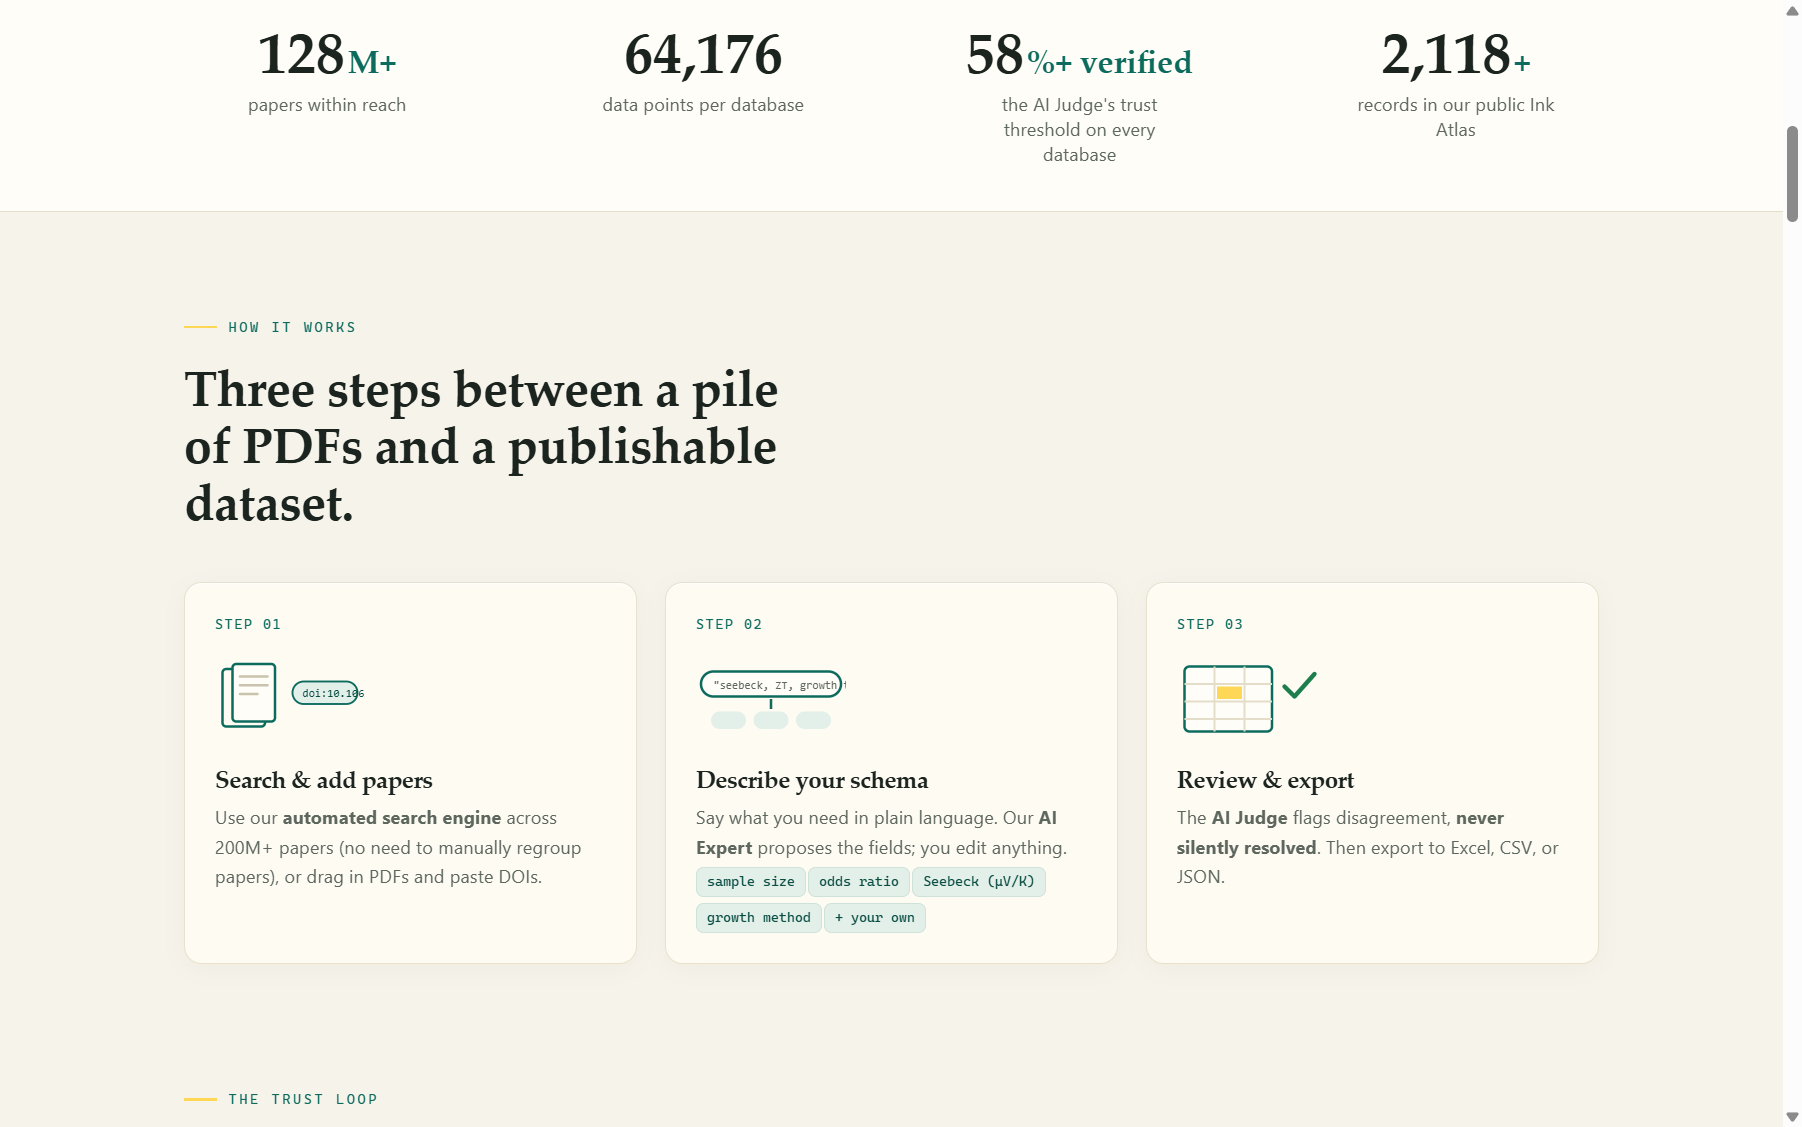
Sci-database 将一堆研究 PDF 转换为一个结构化、经过验证的数据库。您无需花费数月时间手动将数百篇论文中的值复制到电子表格中,您可以:
通过公共存储库(OpenAlex、CORE、Semantic Scholar)搜索1. 搜索 200M+ 科学论文,或上传您自己的 PDF。
2. 用简单的英语描述您需要的数据——人工智能提出了一个结构化模式(未来数据库的列),您可以逐个字段进行编辑。
3. Extract — Kateeb 引擎读取每篇全文并填充您的架构。一篇论文可以产生多条记录(例如,每种材料或每个实验条件一行)。
4. 验证——第二个独立的人工智能模型重新提取论文样本,平台显示逐个领域的比较。分歧会被标记出来,但永远不会默默解决。
5. 将将您的数据库导出到Excel就绪的CSV或JSON — 或公开分享以为开放科学做出贡献。
适合谁?
| 你是… | 你用Sci-database 来… |
|---|---|
| 系统评审员/荟萃分析师 | 从数百项试验中提取结果、样本量、效应量和研究特征,然后输入 R (meta)、Stata 或 RevMan |
| 材料科学家/物理学家/化学家 | 为评论论文建立性能数据库(例如塞贝克系数、ZT 值、带隙、合成方法) |
| 机器学习研究人员 | 将文献转化为大规模标记训练数据 |
| 任何撰写评论的研究人员 | 用一个下午的监督提取代替数月的手动数据输入 |
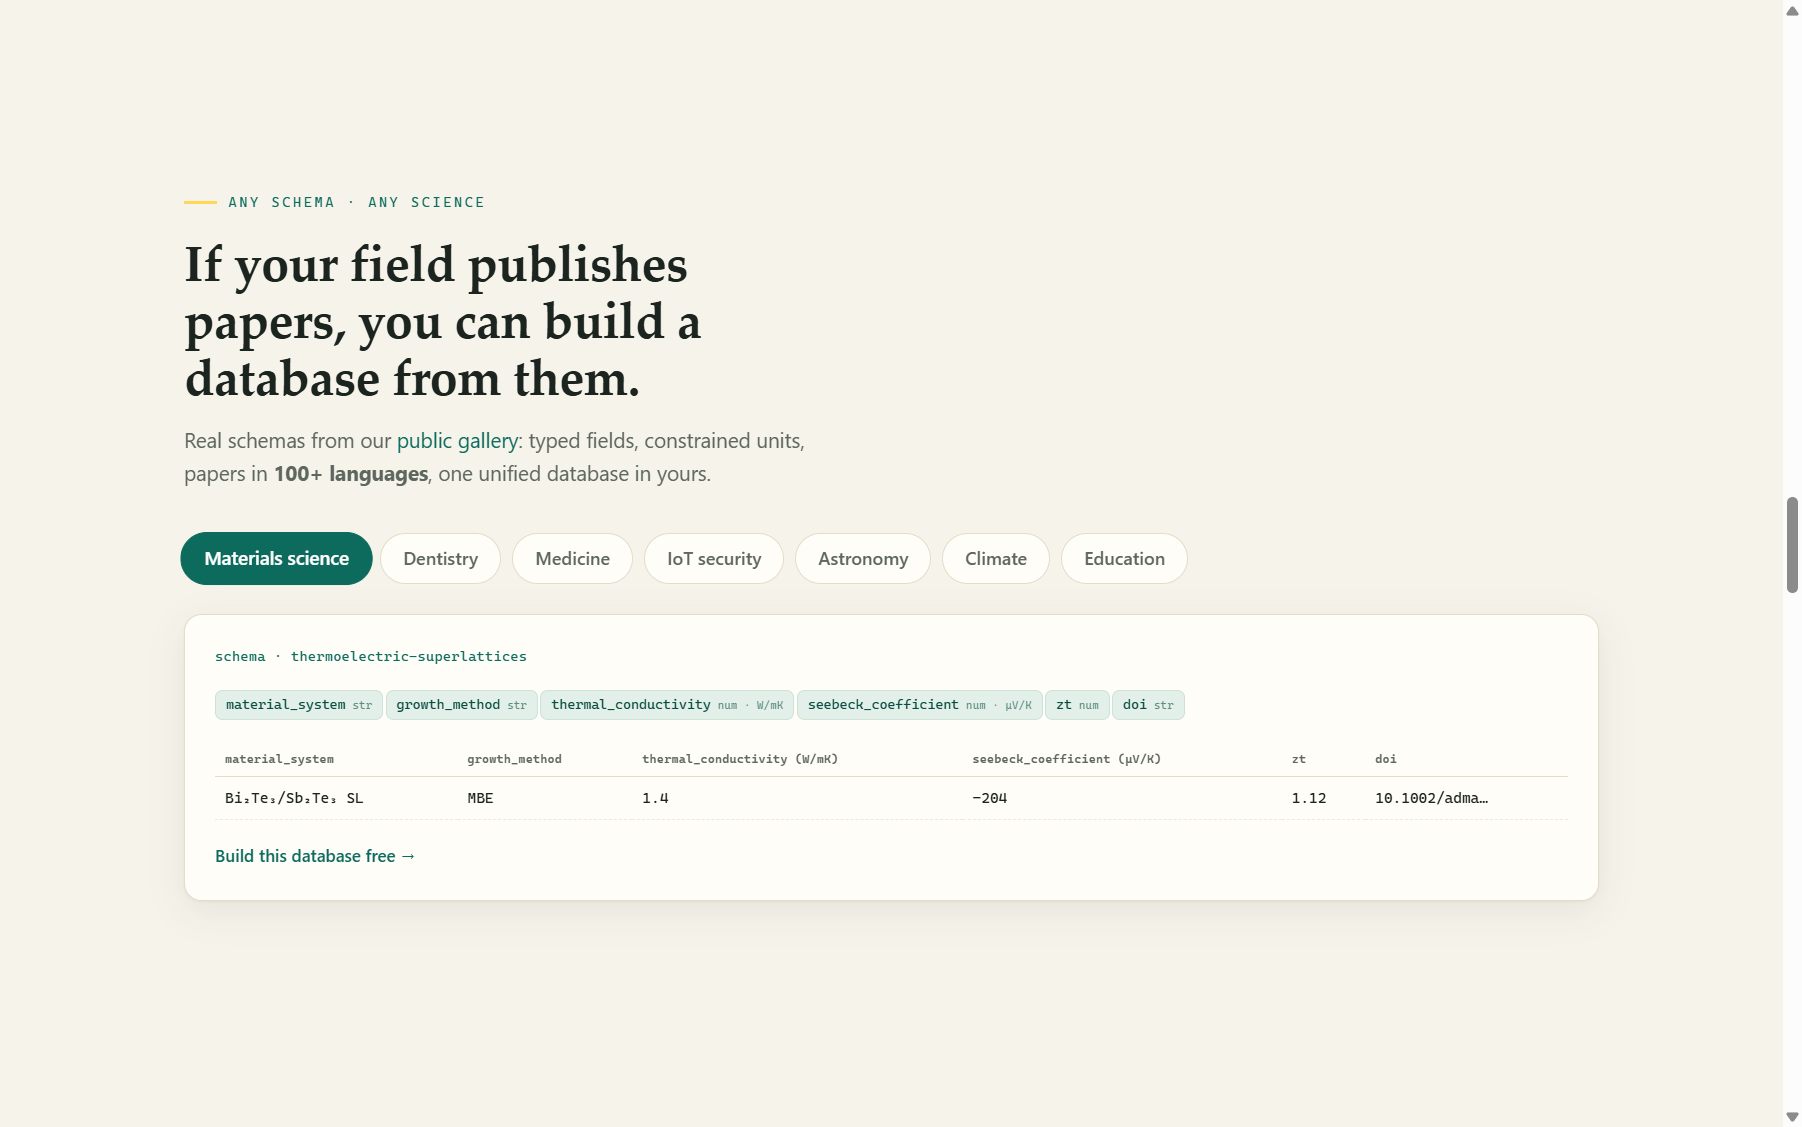
如果您的领域发表论文,您可以从中构建数据库 - 该平台与领域无关。热电、牙科复合材料、高血压随机对照试验、物联网安全、超新星观测、气候预测等领域已经存在公共模式。
信任原则
Sci-database 是为学术用途而构建的,荟萃分析中错误的数字比缺失的数字更糟糕。四个原则贯穿整个产品:
1。零合成数据
提取模型在严格的指令下运行:如果论文中缺少某个值,或者模型的置信度不高,则它必须准确地返回N/A——绝不是猜测,绝不是听起来合理的捏造。
2。没有什么是默默解决的
当验证器模型与原始提取不一致时,分歧会在红色突出显示的比较行中向您显示。你(可选地由第三个人工智能仲裁者帮助)决定真相是什么。
3。融合,别抱希望
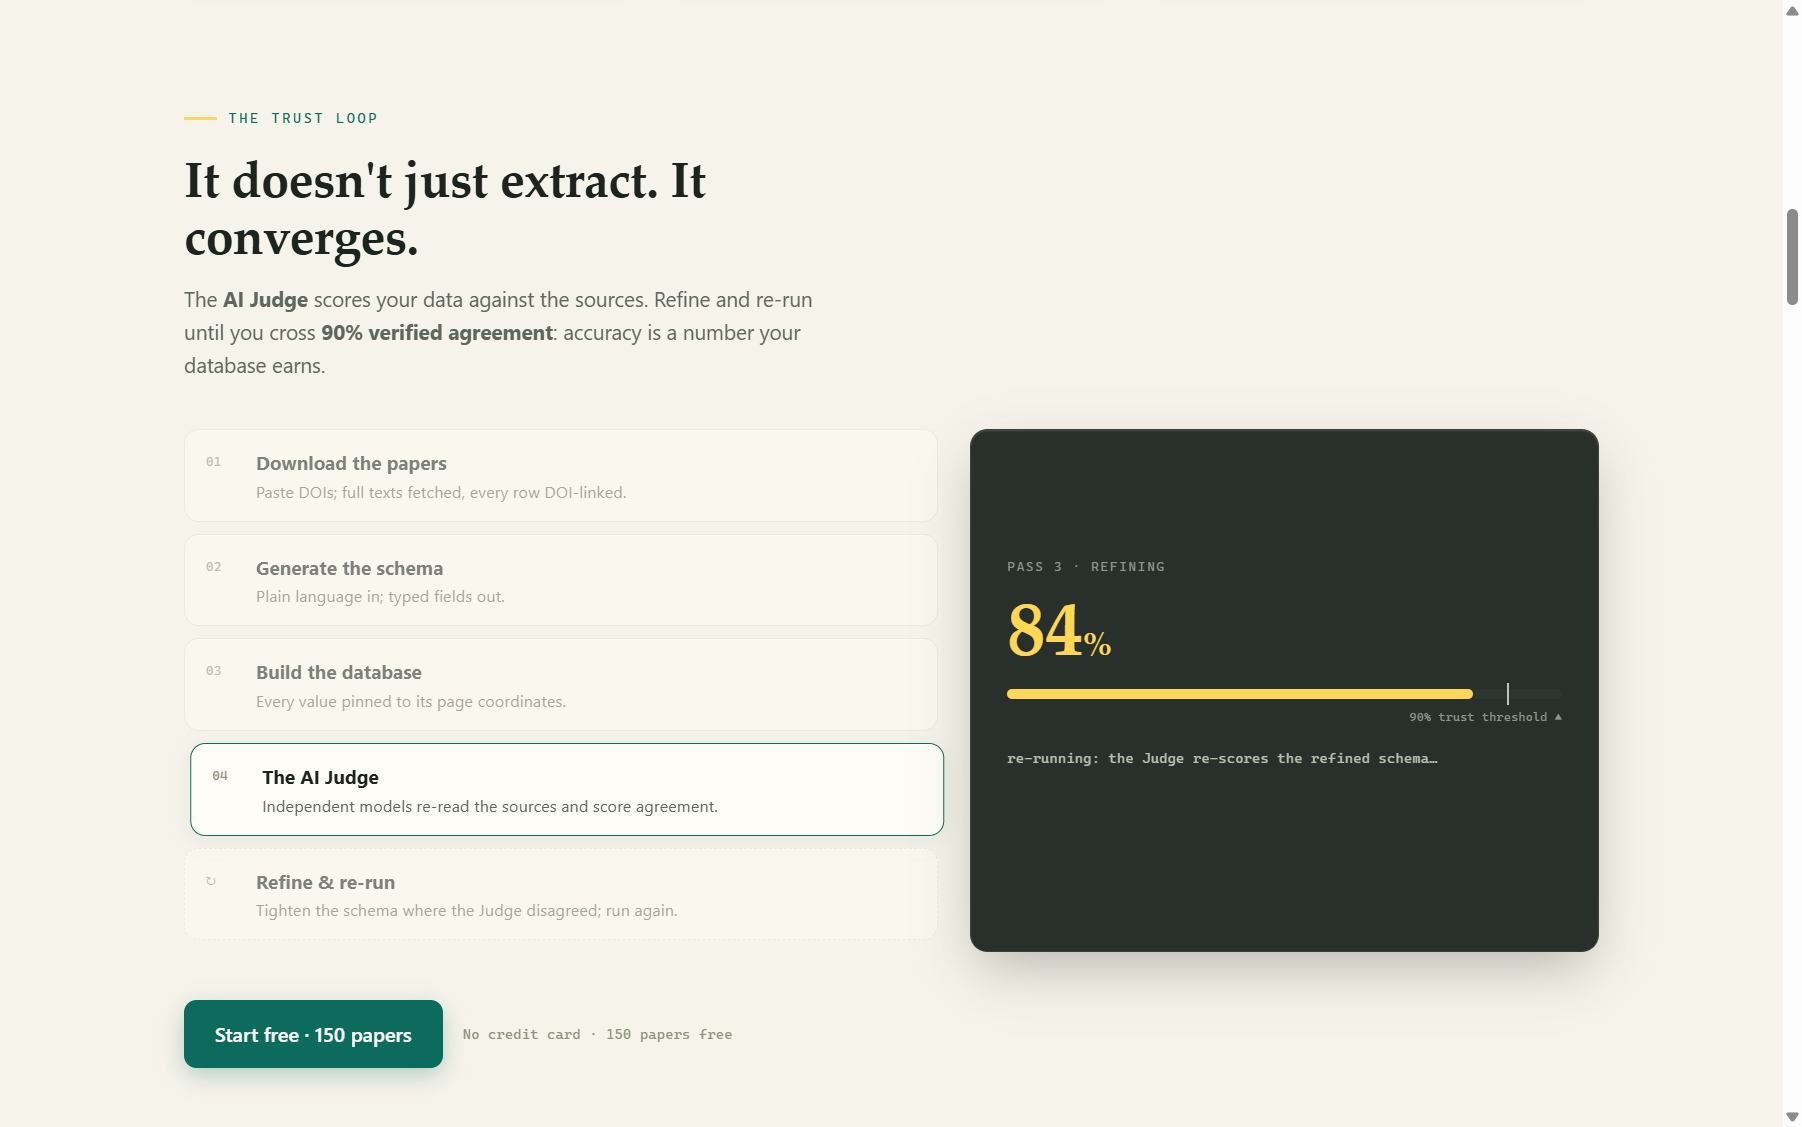
提取不是一击即中。预期的循环是:提取→针对第二个模型进行验证→调查分歧→让人工智能改进模式的字段描述→重新运行。每一次传递都会引发跨模型协议;在数据库被视为“可信”之前,平台的信任阈值是90%+一致。
4。您的数据归您所有
默认情况下,- 您的论文和提取的数据对于您的帐户来说是私有的。
- 您的架构(仅字段定义 - 无数据)可以在公共图库中共享,以帮助其他研究人员;这是您在注册时接受的条款中规定的。
- 上传从未用于训练模型。
- 您可以随时删除您的文件、作业和数据库。
Kateeb引擎
提取引擎的品牌为 Kateeb(كâты,阿拉伯语“抄写员”*)。在验证视图中,原始提取列始终标记为 “原始 (Kateeb)”,因此您可以一眼看出哪个模型产生哪个值。 Sci-database 由哈马德·本·哈利法大学(卡塔尔多哈)开发,并已注册专利(QF 参考号:2024-066)。
下一个: 开始使用 →
