第 5 章5 分钟阅读·官方手册 · 2026 版本
AI-assisted parameter generation, controlled vocabularies, and unit pairing.
5 · 构建你的模式
您的 schema 是未来数据库的结构:列(字段)、它们的类型,以及最重要的是告诉人工智能要提取什么内容的描述。您可以在 DB Content 选项卡中构建它。
让 AI 起草它:AI 驱动的架构生成
在顶部卡片中用简单的英语描述您的数据库,然后单击 建议参数:
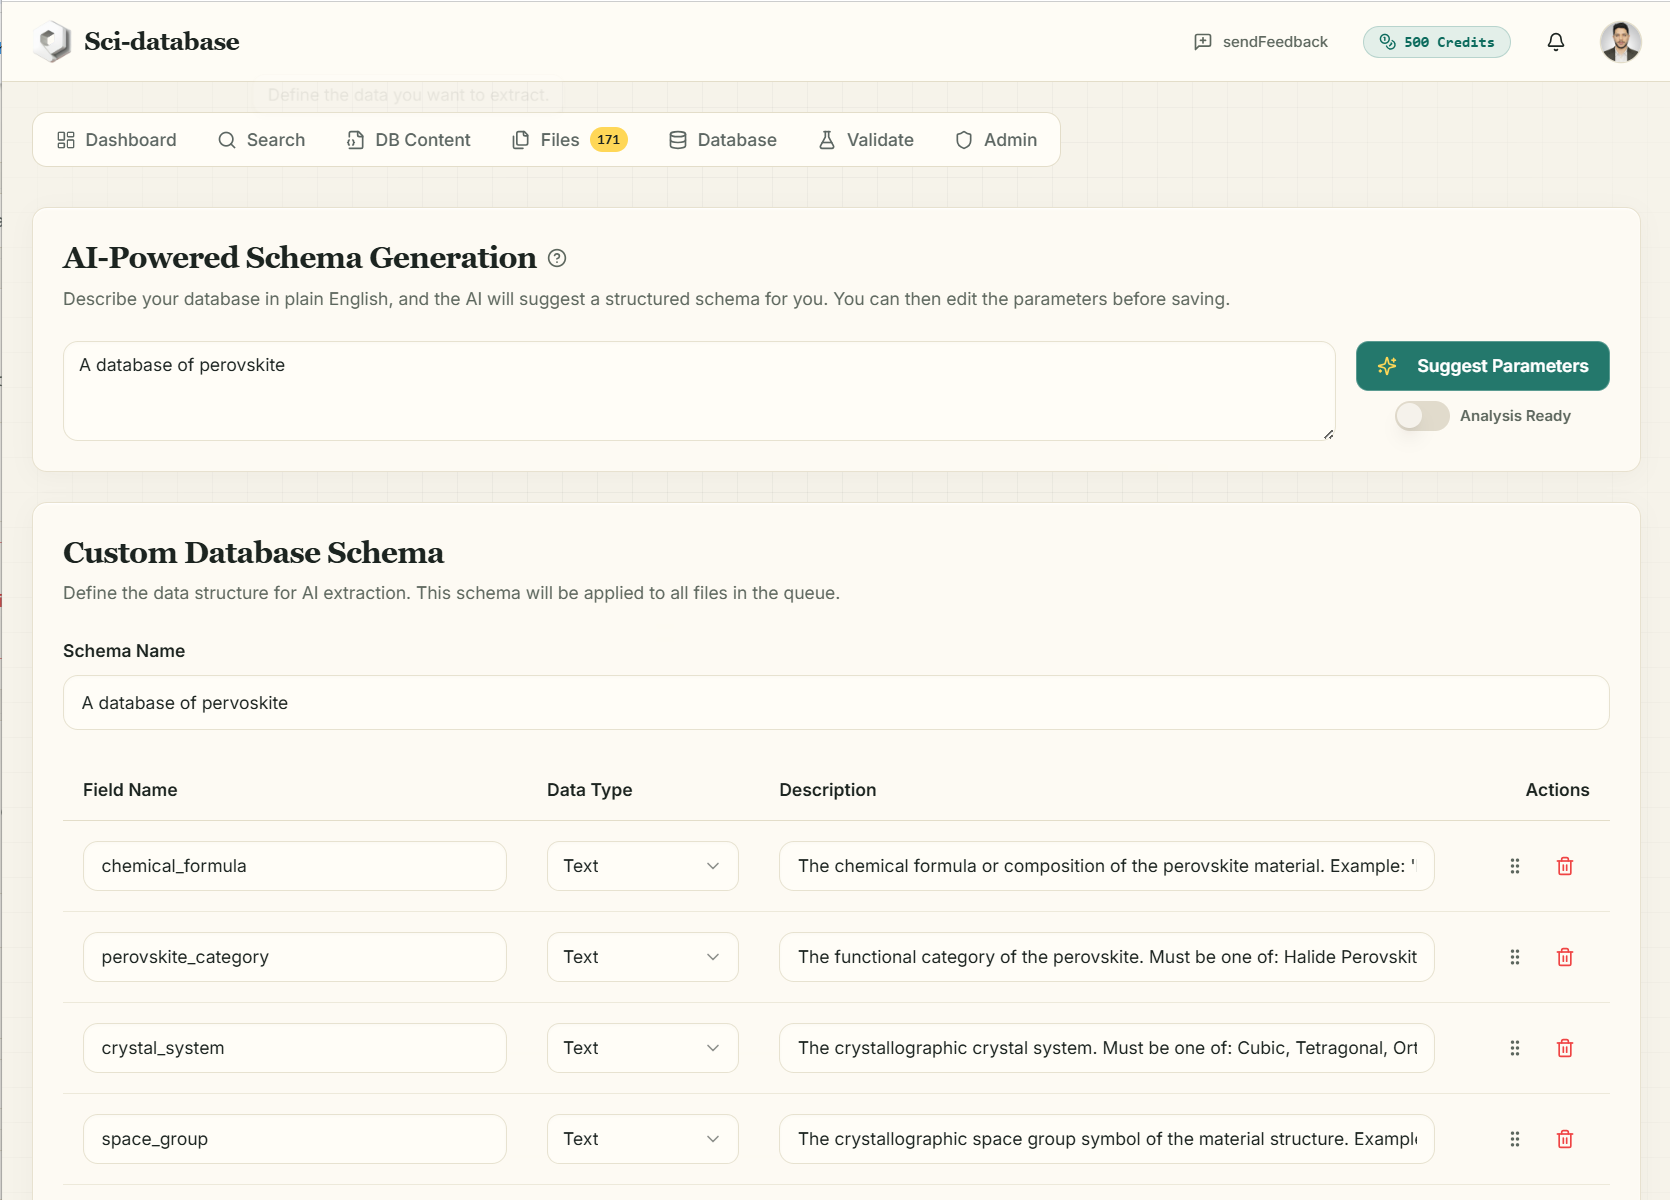
好的提示示例:
- “钙钛矿太阳能电池效率和稳定性数据库”
- “高血压随机对照试验数据库:样本量、干预、血压结果”
- “热电超晶格测量数据库:塞贝克系数、热导率、ZT”
AI(成本 2 学分)按照严格的约定返回完整的草稿模式,使提取一致且可分析:
snake_case(chemical_formula,sample_size) 中的字段名称。- 类型仅限于文本、数字、日期、布尔值。
- 每个数字字段都与
…_unit文本字段 (seebeck_coefficient+seebeck_coefficient_unit) 配对,因此单位永远不会丢失或混合。 - 分类字段在描述中带有受控词汇 — 例如*“必须是以下之一:立方晶系、四方晶系、正交晶系、六方晶系、三方晶系、单斜晶系、三斜晶系”*——这迫使数百篇论文的值保持一致。
- A
doi/ 参考字段始终位于最后,因此数据库中的每一行都可以追溯到其源论文。
分析就绪开关告诉 AI 更喜欢数字、布尔值和单字分类字段(并避免长自由文本字段)——当数据库用于统计分析或 ML 训练而不是叙述性审查时使用它。
如果您的提示无法识别为科学数据库请求,则 AI 会拒绝而不是发明某些内容:“AI 无法识别此请求的相关参数。请尝试更具体的科学描述。”
编辑所有内容:自定义数据库架构编辑器
AI 的草稿是一个起点 - 您可以完全控制下面的编辑器:
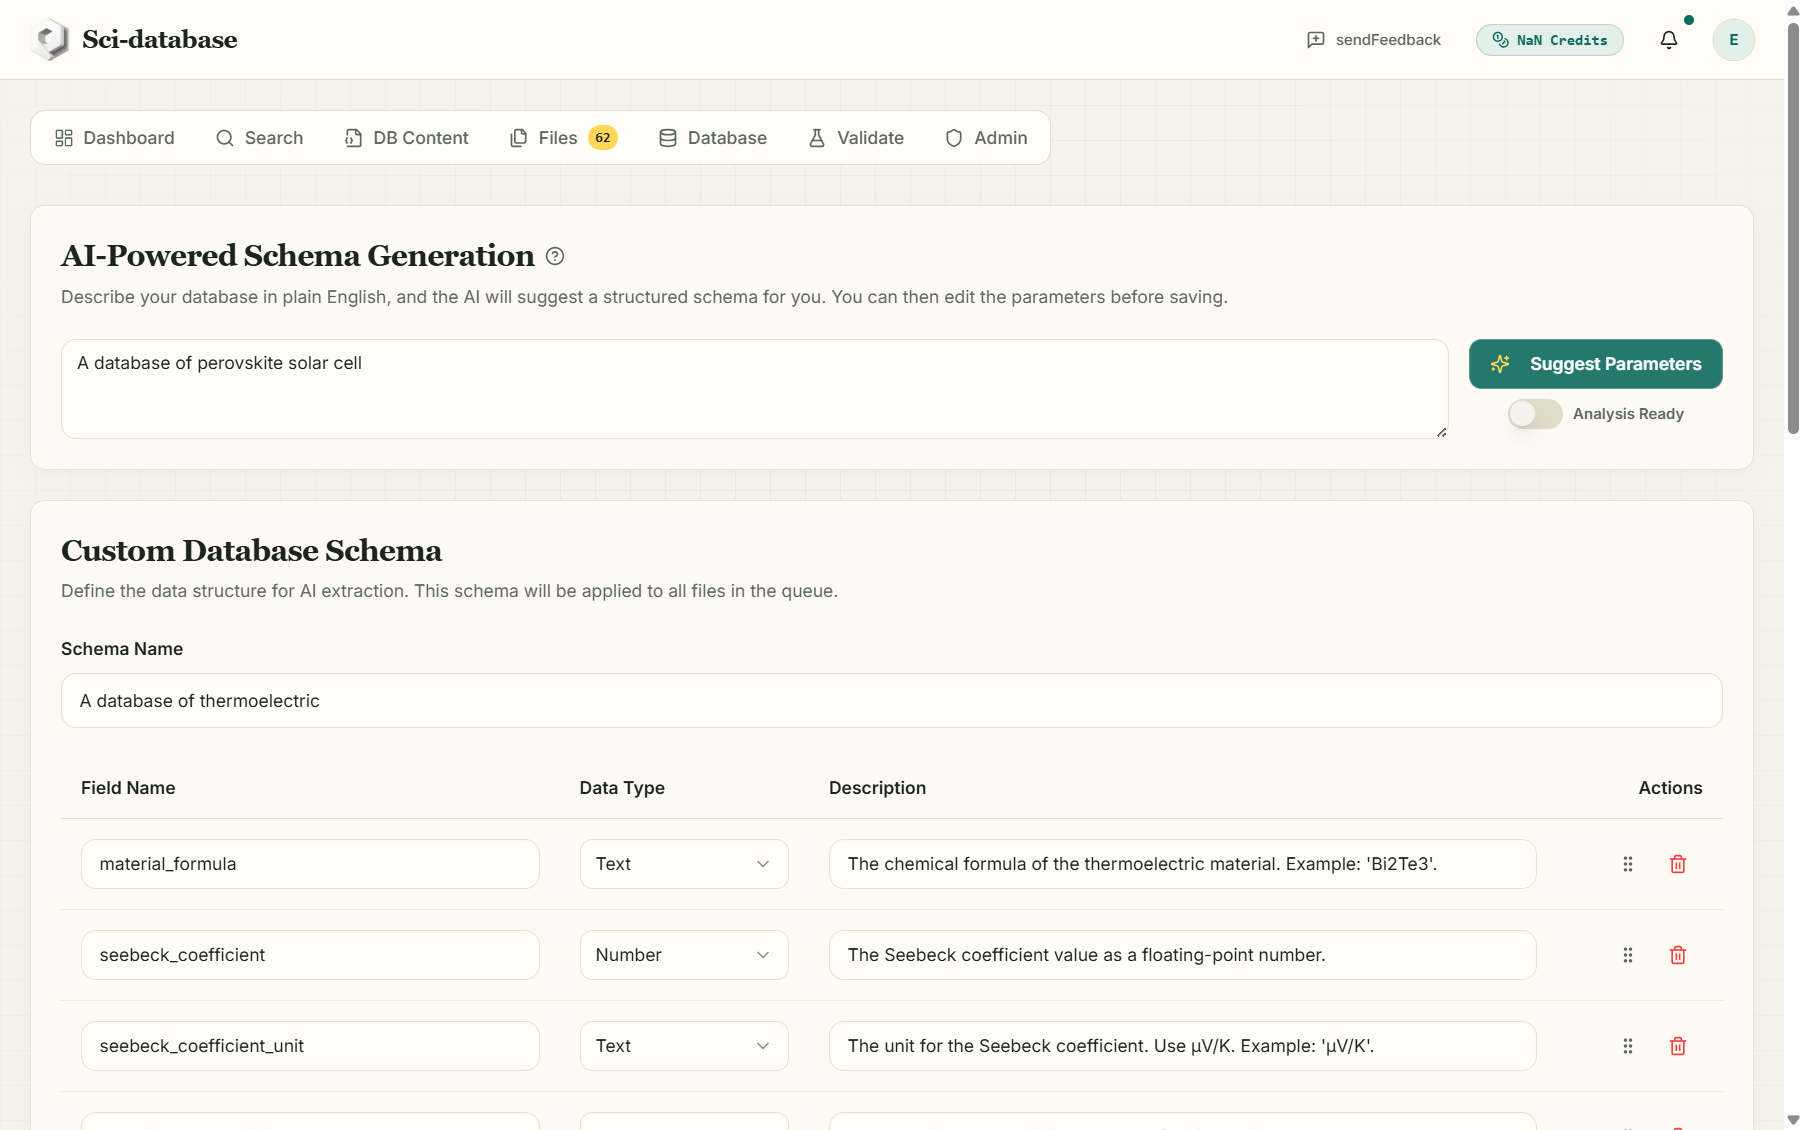
- 架构名称 — 为您的数据库命名。
- 每个字段:字段名称、数据类型(文本/数字/日期/布尔)和描述。
- 拖动行以重新排序,垃圾桶图标以删除字段,添加字段以追加字段。
- 适合数据分析开关将模式标记为分析就绪。
撰写提取良好的描述
描述是提取模型实际遵循的指令 - 对其进行投资:
| 弱描述 | 强描述 |
|---|---|
| “效率” | “设备的冠军电源转换效率 (PCE),以浮点数表示。提取精确值,不要舍入。” |
| “方法” | “沉积方法。必须是以下之一:旋涂、气相沉积、刮涂、喷涂、喷墨印刷。” |
| “温度” | “测量属性时的温度,以数字形式表示。其单位为测量温度单位(K 或 °C)。” |
包括有用的示例值(“示例:'Bi2Te3'”)。如果稍后的验证显示某个字段存在系统性分歧,改进架构功能将为您重写这些描述(第 7 章)。
保存
单击 保存架构 — 您将看到 “架构已保存 — 您的架构已保存到您的帐户。” 处理文件之前需要保存。
关于保存需要了解的两件事:
- 模式在设计上是公开的。 字段定义(绝不是您的数据)会发布到 公共模式库,以便其他研究人员可以重复使用精心设计的模板。您的论文和提取的值保持私密。
- **保存会就地更新架构。**如果编辑并重新保存现有架构,您将更新相同的架构记录 - 先前的字段定义将被替换。然而,每个作业都会存储其运行的模式的永久快照,因此过去的结果始终保持其原始结构。
架构历史
仪表板的模式历史卡链接到一个页面,该页面列出了您在作业中实际使用的每个唯一模式,最近的在前,每个模式都有完整的字段表。使用它来恢复您修改后的架构。
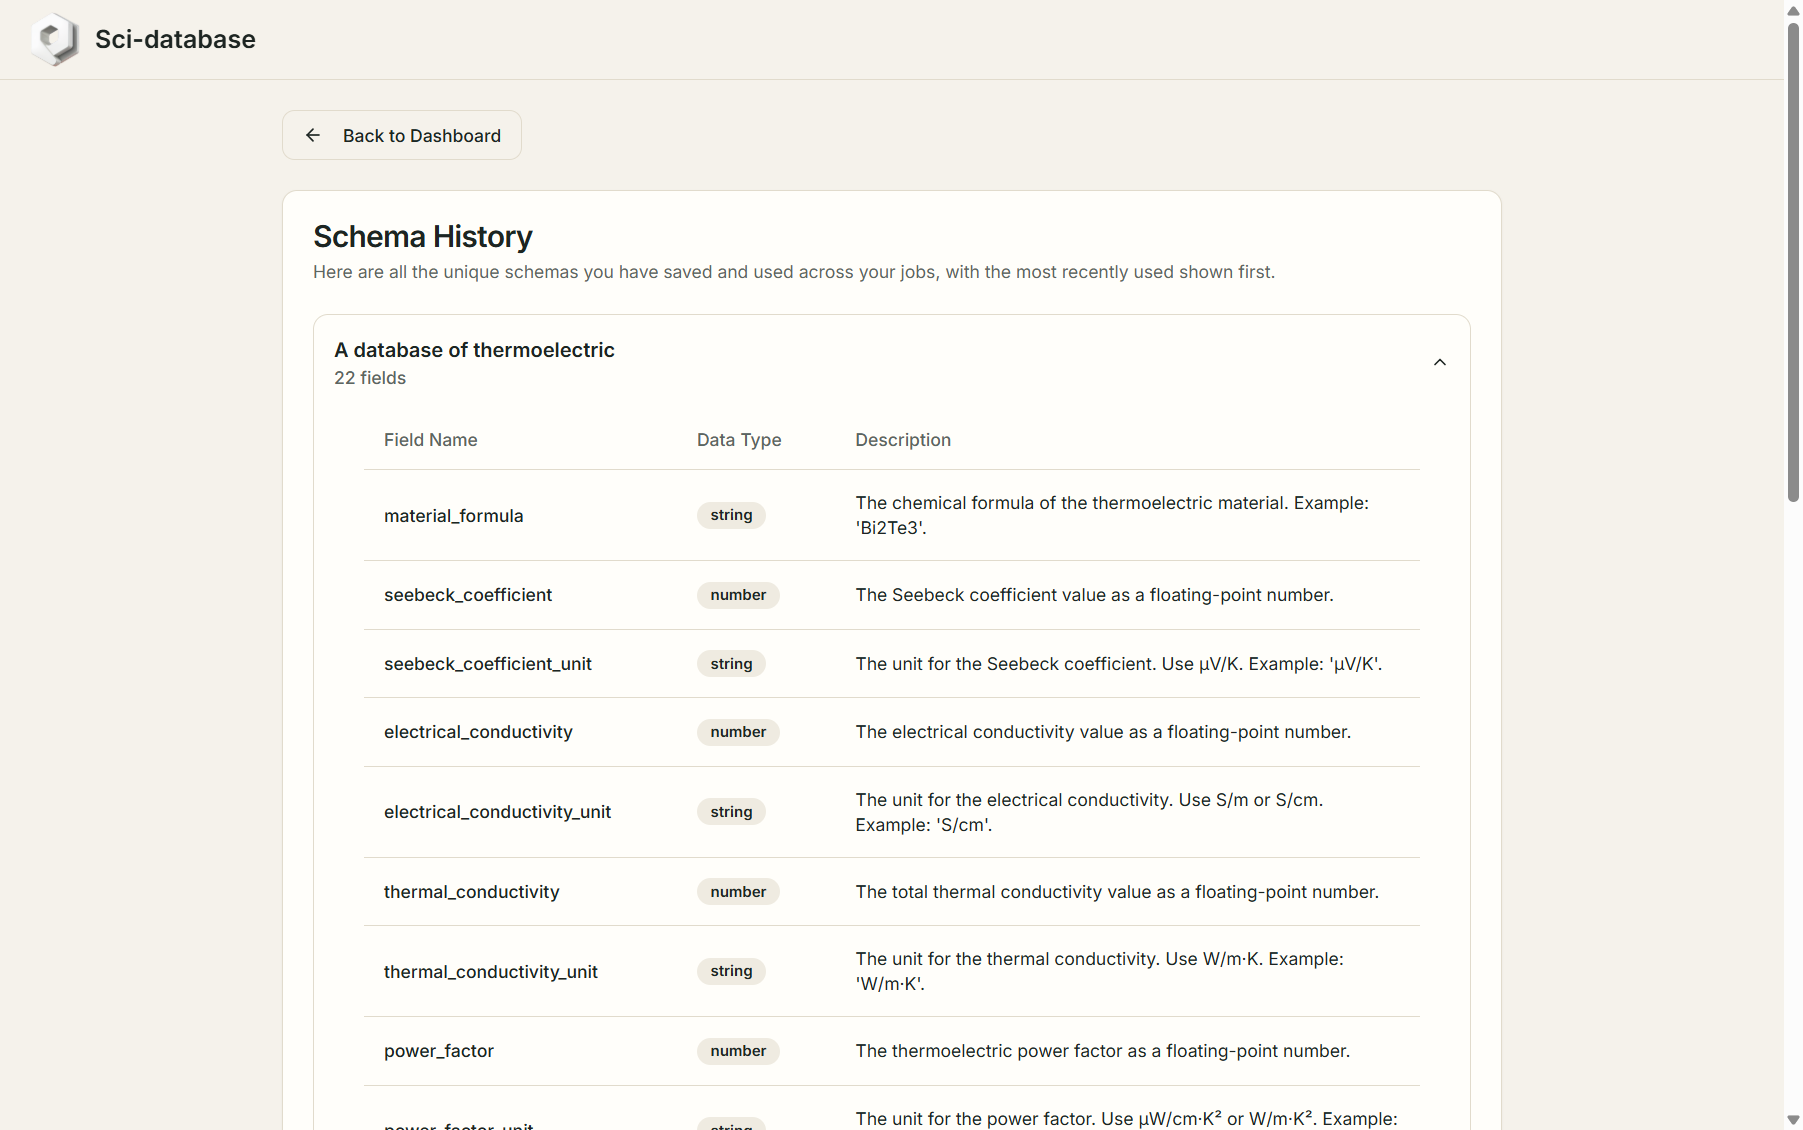
从公共模式开始
在公共图库 中找到模板?在任何架构页面上单击**“免费构建此数据库”** - 登录后,它会克隆到您的编辑器中(“架构已加载”),可供使用或调整。
下一个: 运行提取 →
需要帮助?请查看常见问题或故障排除指南。
