Cross-model validation, investigating disagreements, and converging above 90% agreement.
7 · Validation et juge IA
L’extraction seule n’est pas une question de confiance. La réponse de Sci-database à "Comment puis-je savoir si ma base de données est exacte ?" est validation inter-modèles : un modèle d'IA indépendant réextrait un échantillon de vos articles à partir de zéro, et la plateforme vous montre exactement où les deux modèles sont d'accord et en désaccord - champ par champ, enregistrement par enregistrement. Cela reflète la pratique de double extraction des revues systématiques de type Cochrane, avec des modèles au lieu d'étudiants diplômés.
Démarrage d'une validation
Dans l'onglet Base de données, cliquez sur Valider sur n'importe quelle tâche terminée. L'onglet Validate s'ouvre avec les commandes de configuration :
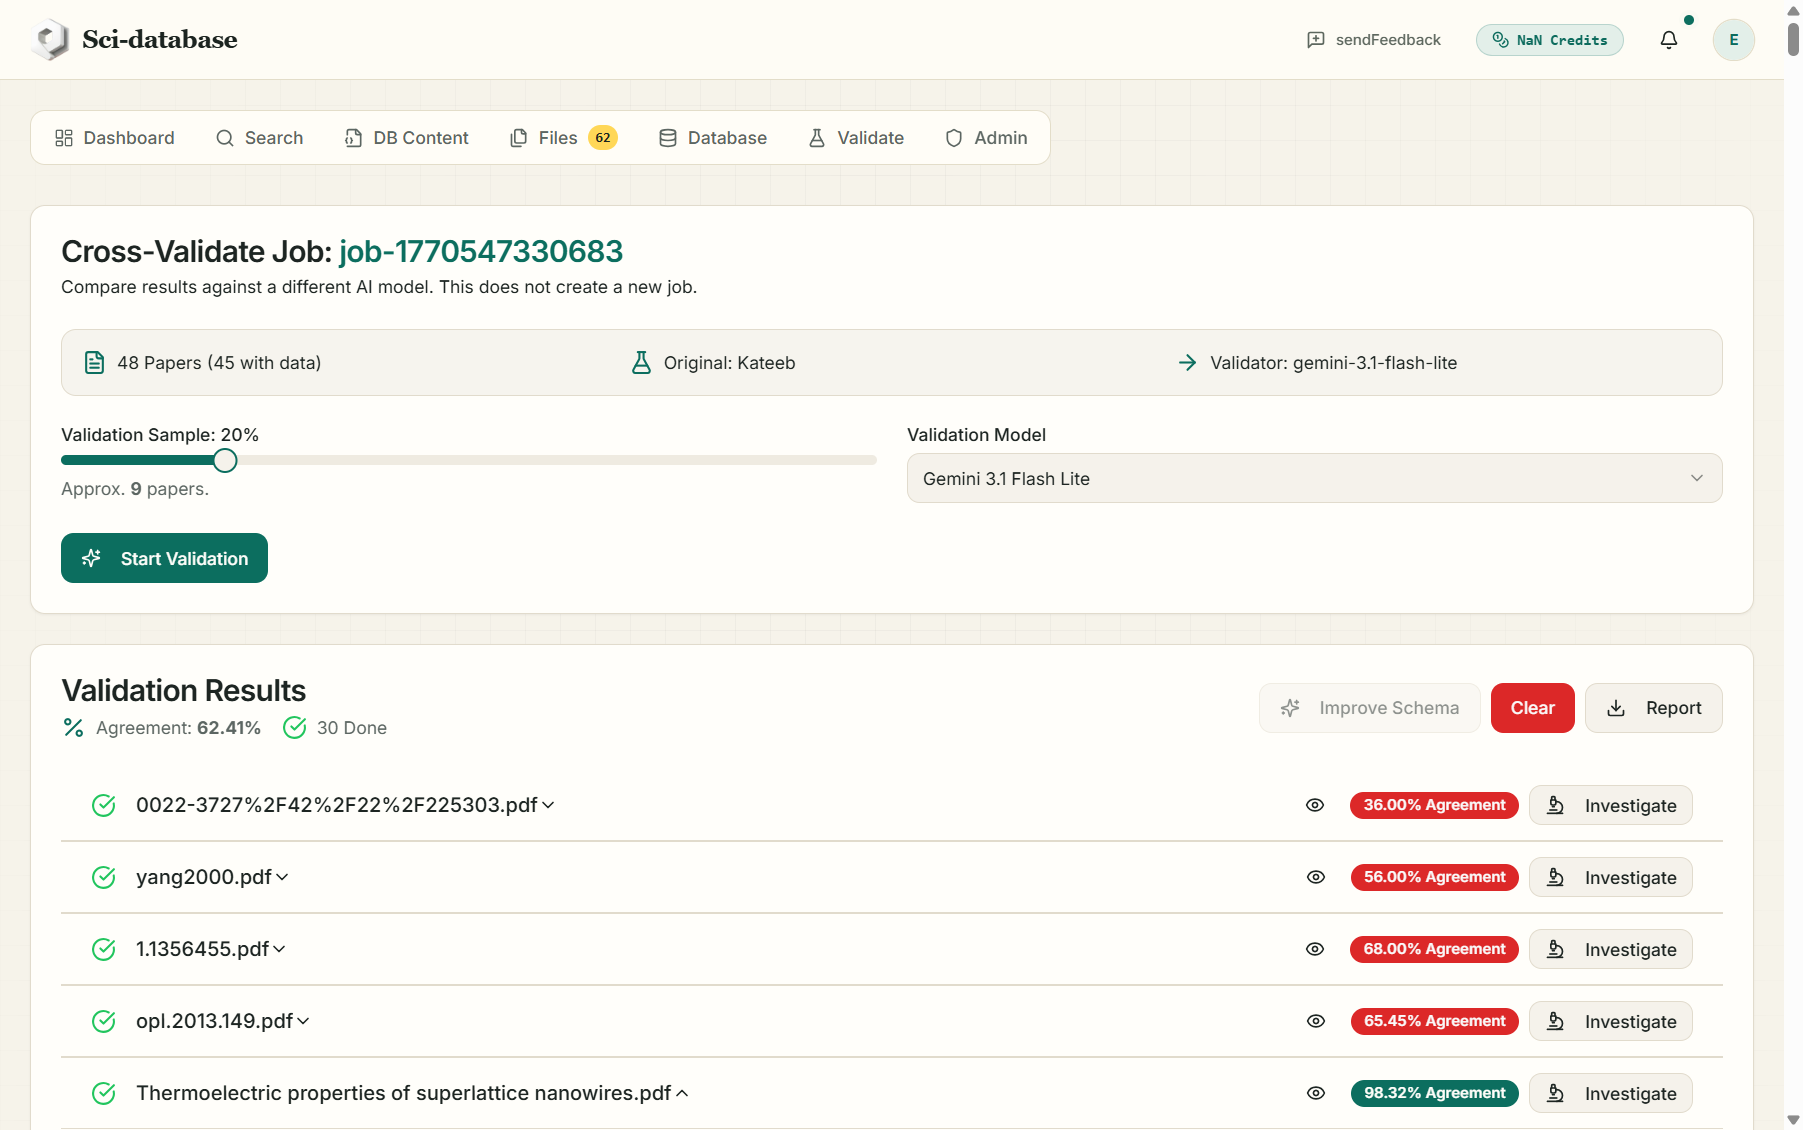
- Échantillon de validation — un curseur de 1 à 100 % (20 % par défaut) des articles qui ont produit des données. Vous n'avez pas besoin de tout valider pour connaître votre exactitude : c'est grâce à un échantillon aléatoire que fonctionne l'audit.
- Modèle de validation — choisissez le deuxième lecteur :
- Gemini 3.1 Flash Lite (par défaut) ou Gemini 3.1 Pro
- GPT-4o-mini (OpenAI) — apportez votre propre clé API
- Claude 3.5 Sonnet (Anthropic) — apportez votre propre clé API
Pour les modèles OpenAI/Anthropic, une boîte de dialogue vous demande votre clé API et indique : "Cette clé ne sera utilisée que pour cette session de validation et ne sera pas stockée."
- Démarrer la validation — coûte 2 crédits par papier échantillonné. La progression s'affiche sous la forme "Validating i/N".
Le modèle de validation reçoit le même texte complet et votre même schéma, mais avec ses propres instructions encore plus strictes (analyser le document complet, ne jamais se fier uniquement au résumé ; pas d'abréviations ; spécificité maximale ; précision numérique exacte ; N/A en cas d'absence).
Lecture des résultats
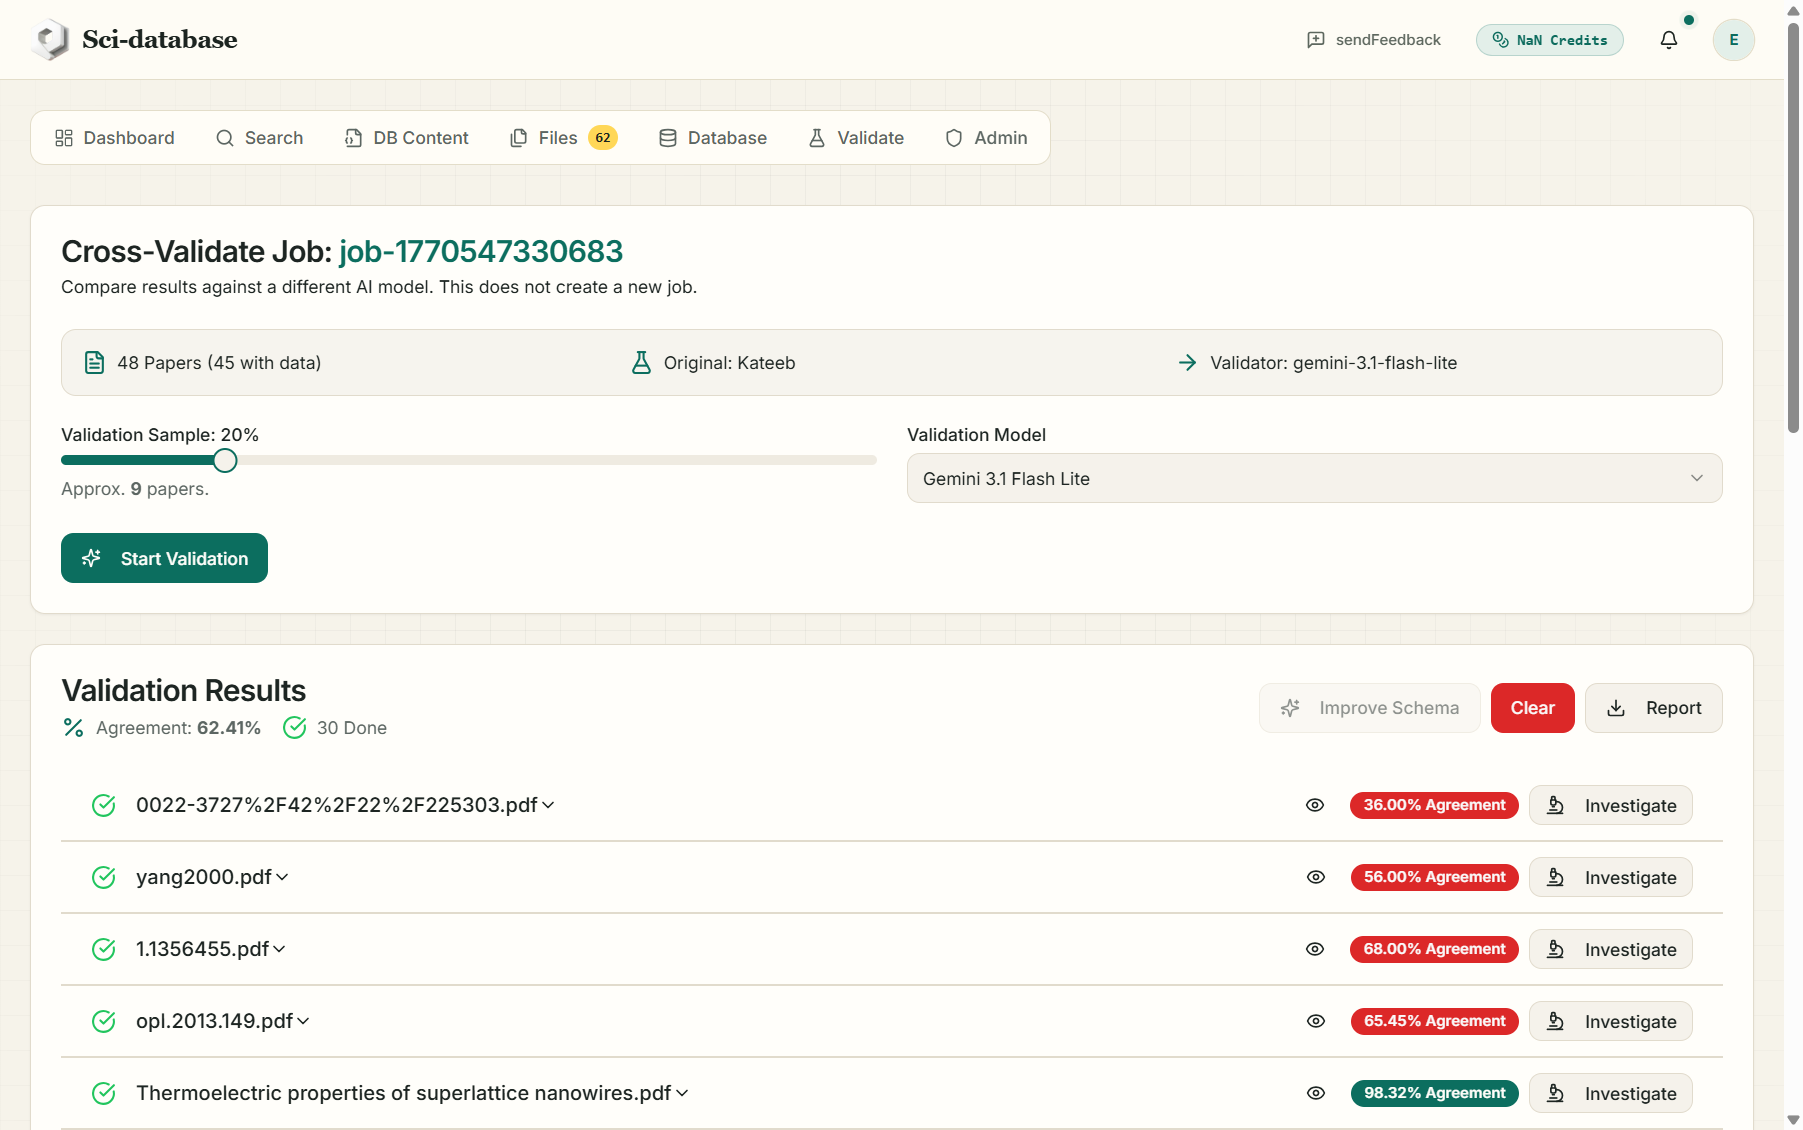
L'en-tête affiche le « 0⟧pourcentage global d'accord** dans tous les champs validés, et chaque article reçoit son propre badge d'accord. Chèque vert = plein accord ; triangle rouge = désaccords trouvés. Un champ compte comme un désaccord uniquement lorsque le validateur a renvoyé une valeur non vide différente — si le validateur n'a rien trouvé pour un champ, cela est marqué neutre (ℹ), pas un conflit.
Développez n'importe quel article pour voir le tableau Record Comparison :
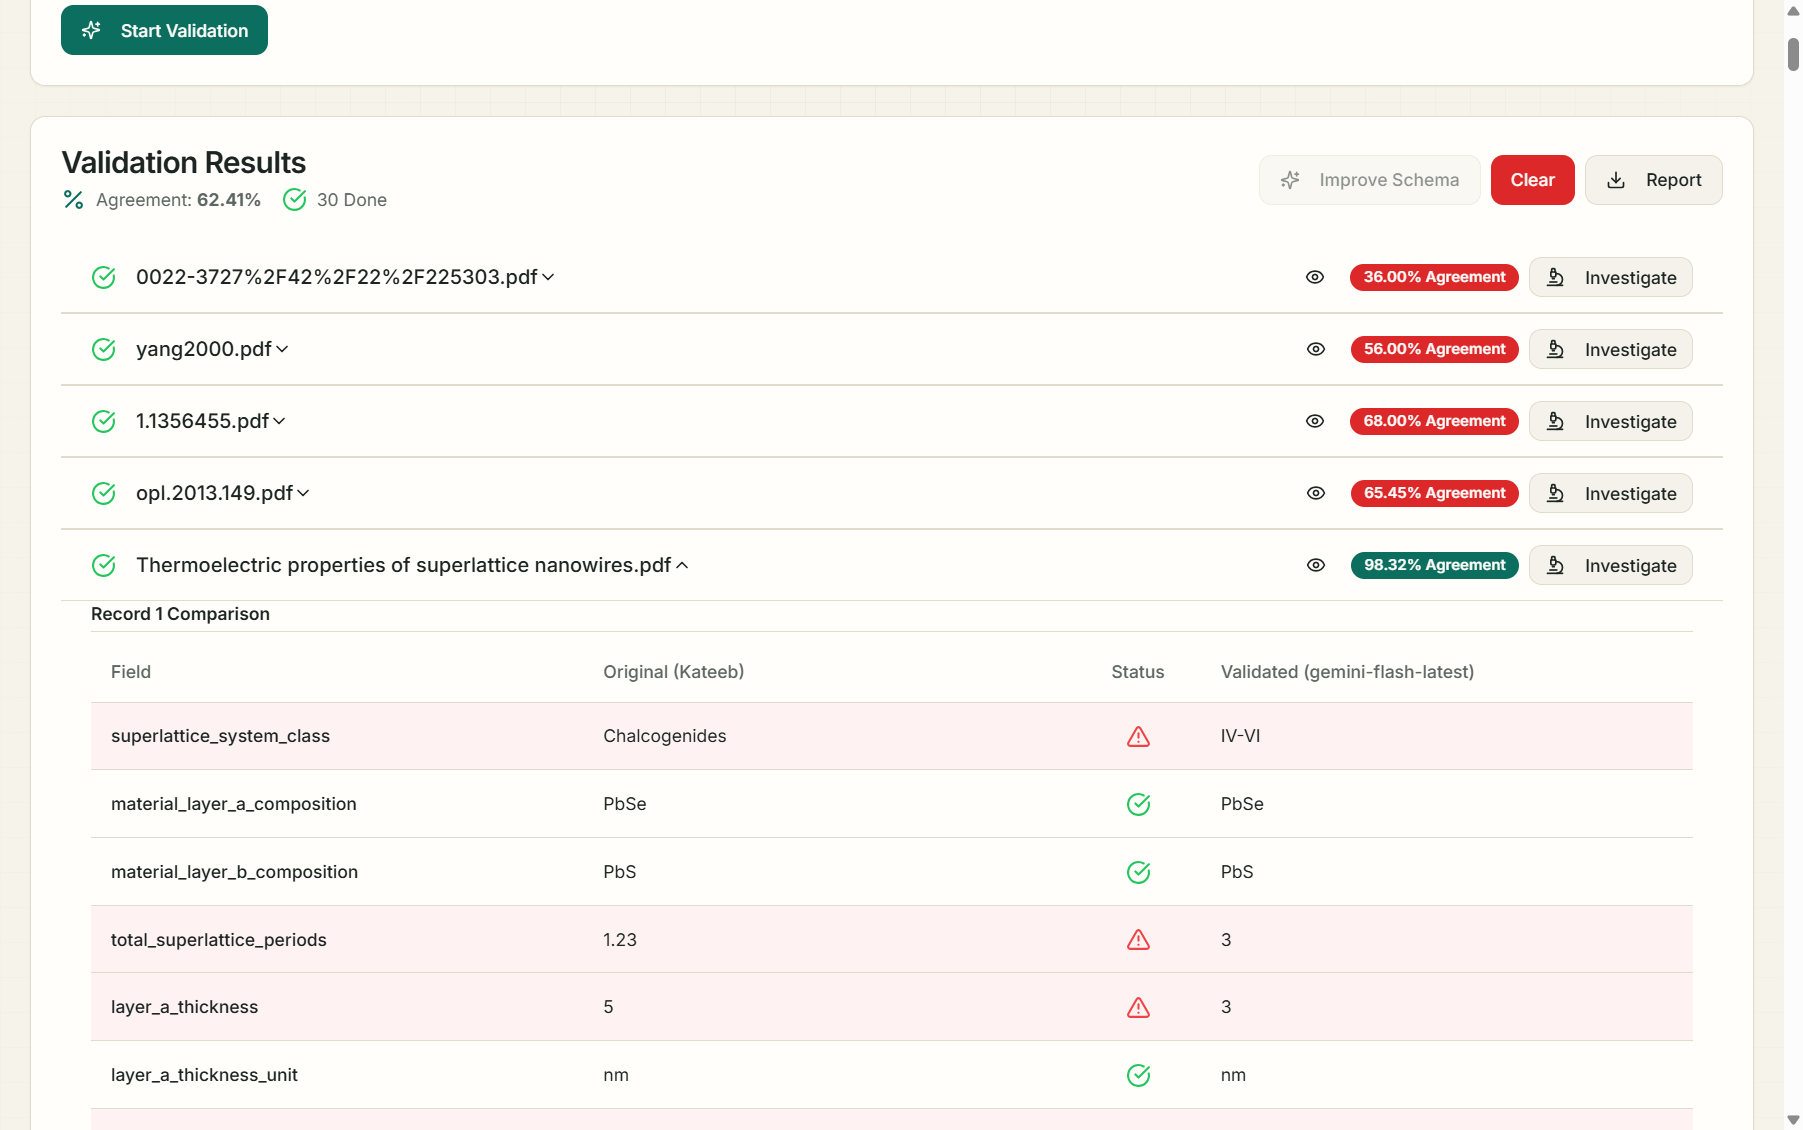
| Colonne | Contenu |
|---|---|
| Field | Votre champ de schéma |
| Original (Kateeb) | Ce que la première extraction a trouvé |
| Statut | ✅ correspondance · ⚠️ incompatibilité (ligne surlignée en rouge) · ℹ️ le validateur n'a rien trouvé |
| Validé (modèle) | Ce que le deuxième modèle a trouvé |
Rien n'est caché et rien n'est auto-corrigé : chaque ligne rouge est une question que la plateforme vous pose.
Le juge IA : enquêter sur les désaccords
Pour tout article en dessous d'un accord à 100 %, cliquez sur Enquêter (2 crédits par écart). Une troisième IA agit comme un arbitre expert : elle relit le texte intégral pour chaque champ contesté et doit renvoyer soit l'une des deux valeurs candidates, une valeur vers laquelle elle peut pointer directement dans le texte, soit N/A — plus un raisonnement d'une à deux phrases.
Le résultat apparaît en ligne sous la forme d'une ligne Investigation Result avec la valeur finale et le raisonnement de l'arbitre. Dès lors, la valeur résolue de l'arbitre ** devient la référence ** pour ce champ : le score d'accord est recalculé par rapport à elle.
Vous pouvez télécharger la comparaison complète sous la forme Report — un CSV (validation_report_job_….csv) avec des colonnes Titre du papier, Index de l'enregistrement, Nom du champ, Valeur originale, Valeur validée, Correspondance — prêt à être joint aux documents supplémentaires d'un manuscrit.
Fermer la boucle : améliorer le schéma
La plupart des désaccords ne sont pas des échecs de modèle — ce sont des descriptions de champs ambiguës (« efficacité » — de quoi ? initiale ou stabilisée ? quelle unité ?). Cliquez sur Améliorer le schéma (5 crédits) et l'IA analyse les écarts étudiés et propose de meilleurs champs descriptions (les noms et les types ne sont jamais touchés).
Chaque suggestion affiche le raisonnement, la ancienne description (rouge) et une description suggérée modifiable (vert) ; vous Accepter et modifier ou Rejeter par champ. Les modifications acceptées atterrissent dans votre éditeur de schéma : enregistrez le schéma, puis ** réexécutez l'extraction**.
Convergence vers 90 %+
Il s'agit de la boucle de confiance autour de laquelle la plateforme est conçue :
  extract  →  validate (2nd model)  →  investigate (AI Judge)  →  improve schema  →  re-run
     ▲                                                                                │
     └────────────────────────────────────────────────────────────────────────────────┘
Une trajectoire typique au fil des passes : ~70 % d'accord lors de la première exécution brute (les modèles ne sont pas d'accord sur les unités et les champs ambigus) → ~85 % après avoir affiné le schéma → 90%+, le seuil de confiance de la plateforme, auquel cas le désaccord se limite à des jugements véritablement difficiles que vous avez personnellement jugés. Votre base de données est désormais quelque chose que vous pouvez défendre lors d’un examen par les pairs – avec le rapport de validation pour le prouver.
Suivant : Votre base de données & exports →
