What Sci-database is, who it's for, and the 4 academic trust principles.
1 · Introduction
Qu'est-ce que Sci-database ?
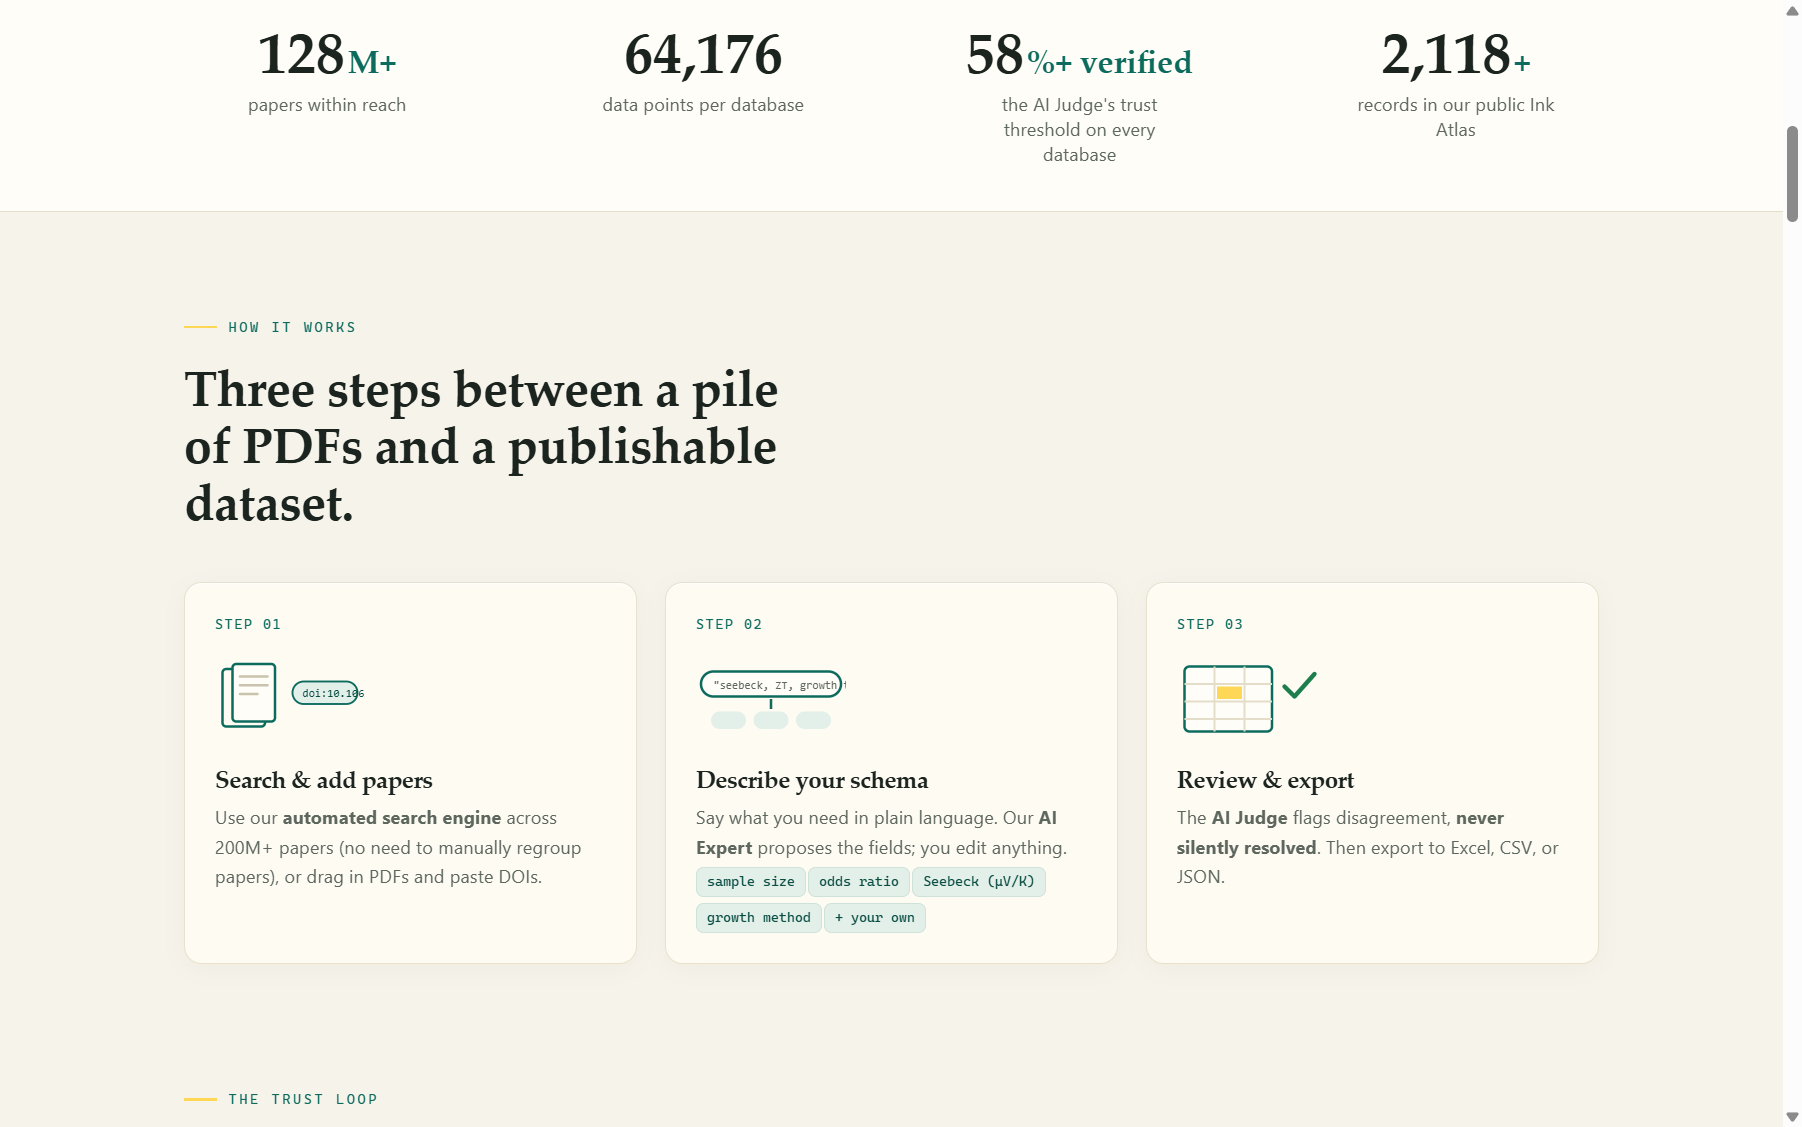
Sci-database transforme des piles de fichiers PDF de recherche en une base de données structurée et vérifiée. Au lieu de passer des mois à copier manuellement les valeurs de centaines de documents dans une feuille de calcul, vous :
- Recherchez Plus de 200 millions d'articles scientifiques via des référentiels publics (OpenAlex, CORE, Semantic Scholar), ou téléchargez vos propres PDF.
- Décrivez les données dont vous avez besoin dans un anglais simple — l'IA propose un schéma structuré (les colonnes de votre future base de données), que vous pouvez éditer champ par champ.
- Extract — le moteur Kateeb lit chaque article complet et remplit votre schéma. Un article peut produire plusieurs enregistrements (par exemple, une ligne par matériau ou par condition expérimentale).
- Validate — un deuxième modèle d'IA indépendant réextrait un échantillon de vos articles et la plateforme affiche une comparaison champ par champ. Les désaccords sont signalés, jamais résolus en silence.
- Exportez votre base de données vers Excel-ready CSV ou JSON — ou partagez-la publiquement pour contribuer à la science ouverte.
Pour qui ?
| Vous êtes… | Vous utilisez Sci-database pour… |
|---|---|
| Un examinateur systématique/méta-analyste | Extraire les résultats, la taille des échantillons, la taille des effets et les caractéristiques des études à partir de centaines d'essais, puis alimenter R (meta), Stata ou RevMan |
| Un scientifique des matériaux/physicien/chimiste | Construire des bases de données de propriétés (par exemple, coefficients Seebeck, valeurs ZT, bandes interdites, méthodes de synthèse) pour les articles de synthèse |
| Un chercheur en ML | Transformer la littérature en données de formation étiquetées à grande échelle |
| Tout chercheur rédigeant une revue | Remplacez des mois de saisie manuelle de données par un après-midi d'extraction supervisée |
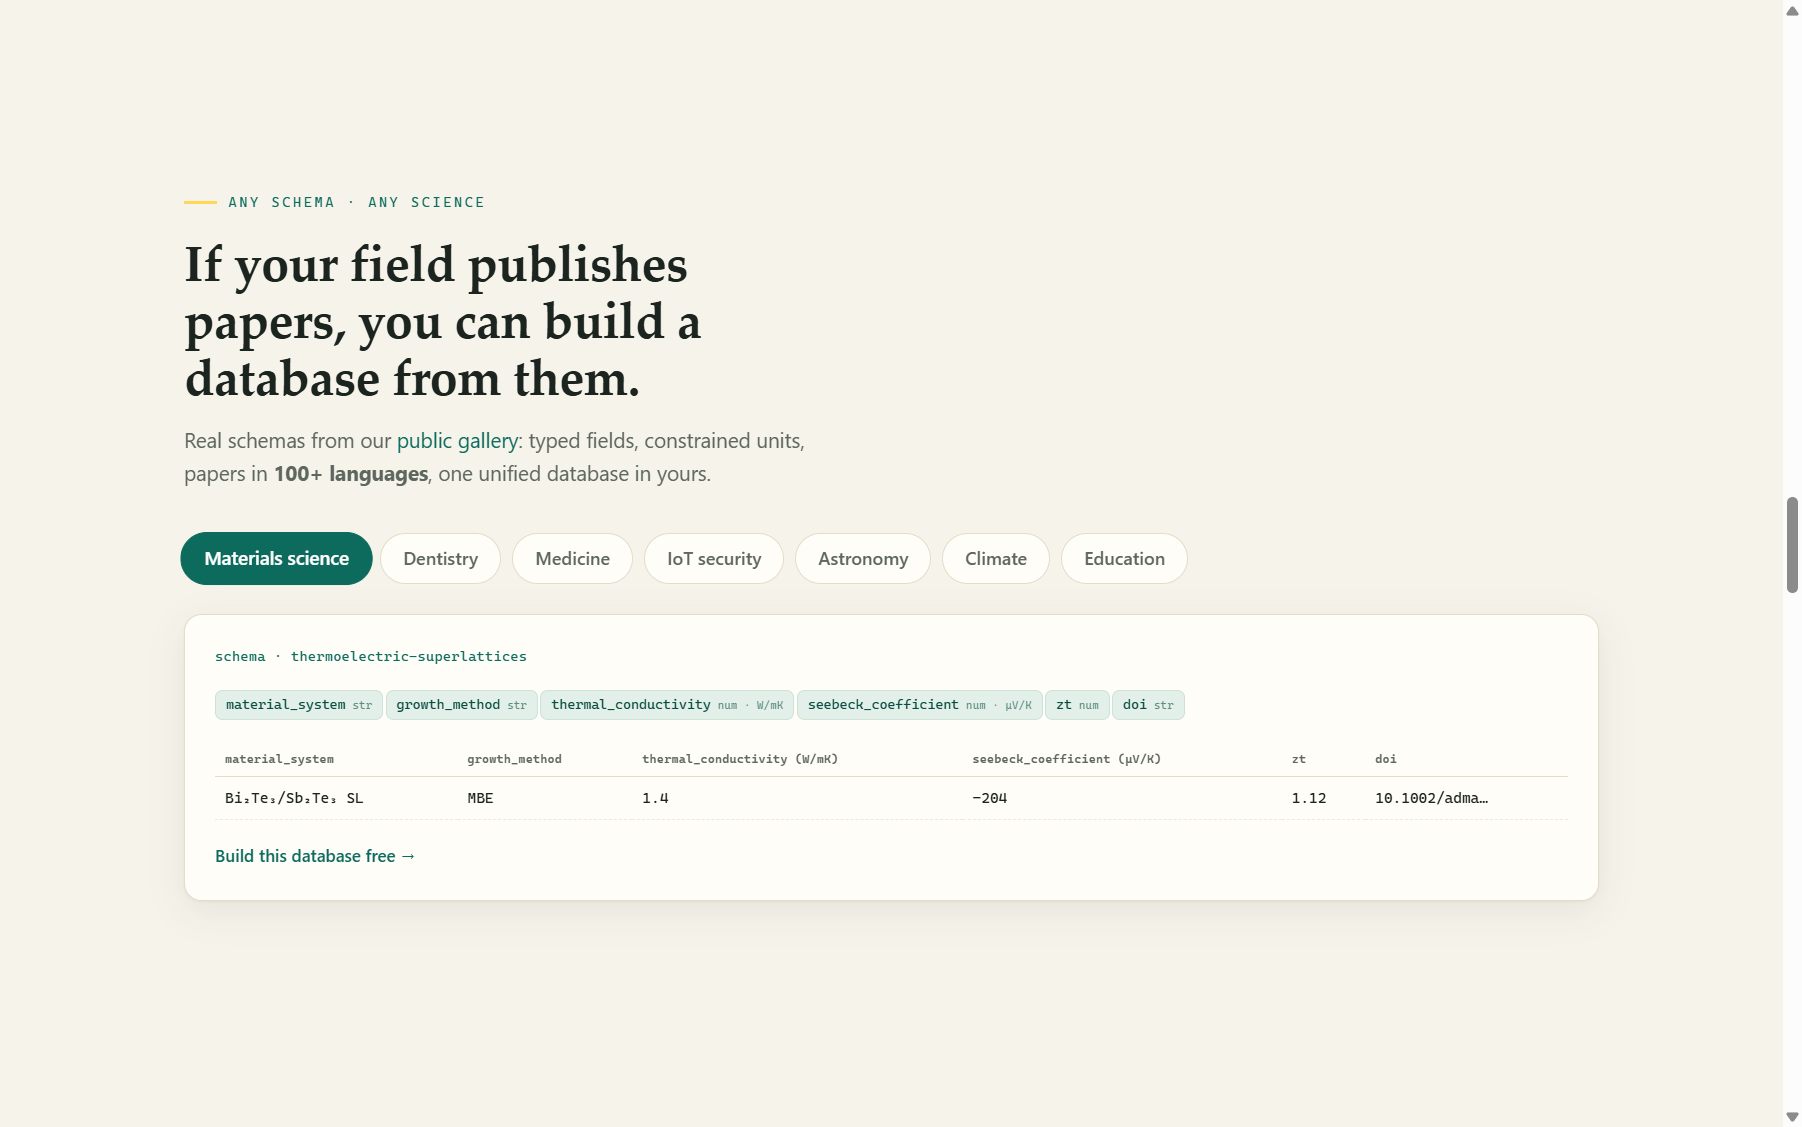
Si votre domaine publie des articles, vous pouvez créer une base de données à partir d'eux : la plate-forme est indépendante du domaine. Des schémas publics existent déjà pour la thermoélectrique, les composites dentaires, les ECR sur l'hypertension, la sécurité de l'IoT, les observations de supernova, les projections climatiques, etc.
Les principes de confiance
Sci-database est conçu pour un usage académique, où un nombre erroné dans une méta-analyse est pire qu'un nombre manquant. Quatre principes imprègnent l'ensemble du produit :
1. Zéro donnée synthétique
Le modèle d'extraction fonctionne selon une instruction stricte : si une valeur manque dans l'article, ou si le modèle n'est pas très fiable, il doit renvoyer exactement N/A — jamais une supposition, jamais une fabrication qui semble plausible.
2. Rien n'est résolu en silence
Lorsque le modèle du validateur n'est pas d'accord avec l'extraction d'origine, le désaccord vous est montré dans une ligne de comparaison surlignée en rouge. Vous (éventuellement aidé par un troisième arbitre IA) décidez quelle est la vérité.
3. Convergez, n'espérez pas
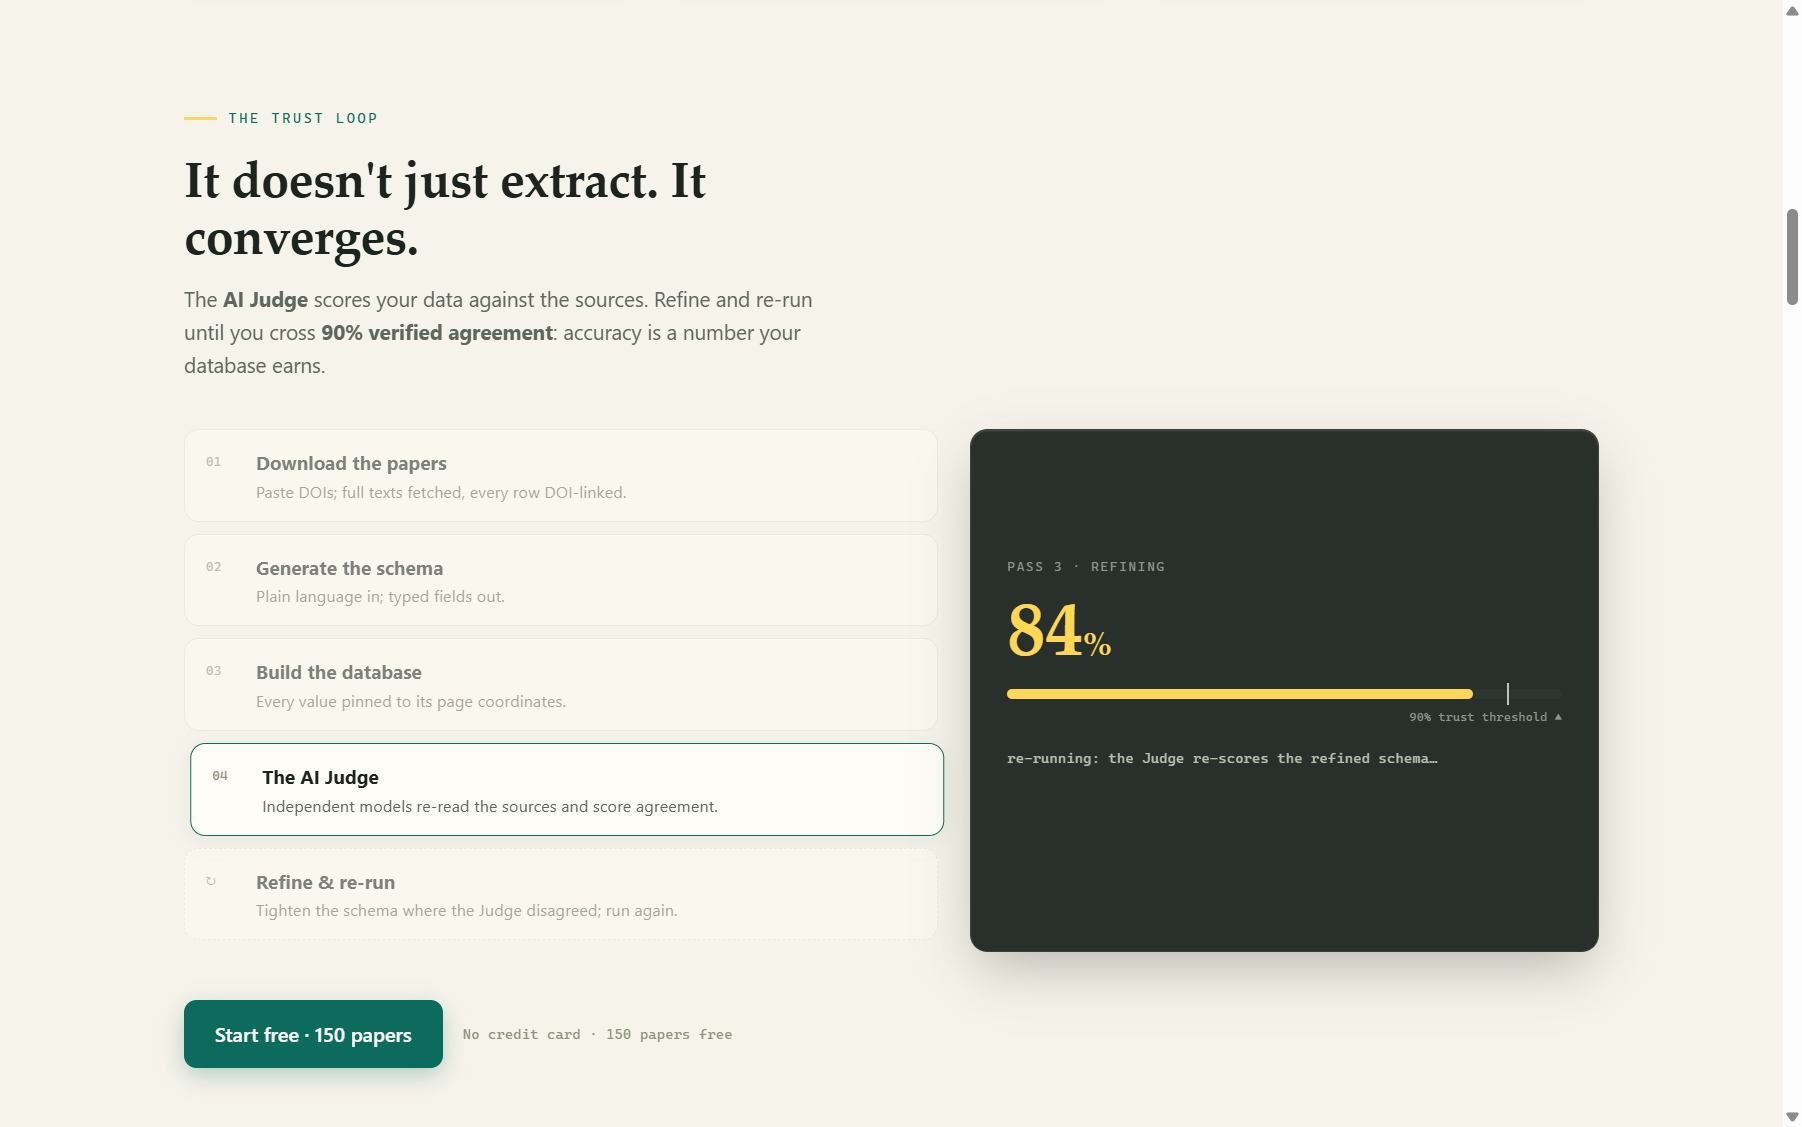
L’extraction n’est pas une opération unique. La boucle prévue est la suivante : extraire → valider par rapport à un deuxième modèle → enquêter sur les désaccords → laisser l'IA améliorer les descriptions de champs de votre schéma → réexécuter. Chaque passe soulève l'accord inter-modèles ; le seuil de confiance de la plateforme est de 90%+ accord avant qu'une base de données ne soit considérée comme « fiable ».
4. Vos données restent les vôtres
- Vos papiers et données extraites sont privés de votre compte par défaut.
- Votre schéma (les définitions de champs uniquement — aucune donnée) peut être partagé dans la galerie publique pour aider d'autres chercheurs ; ceci est indiqué dans les conditions que vous acceptez lors de votre inscription.
- Les téléchargements ne sont jamais utilisés pour entraîner des modèles.
- Vous pouvez supprimer vos fichiers, tâches et bases de données à tout moment.
Le moteur Kateeb
Le moteur d'extraction porte la marque Kateeb (كاتب, arabe pour "scribe"). Dans les vues de validation, la colonne d'extraction d'origine est toujours étiquetée "Original (Kateeb)" afin que vous puissiez savoir en un coup d'œil quel modèle a produit quelle valeur. Sci-database a été développé à l'Université Hamad Bin Khalifa (Doha, Qatar) et est breveté (Réf QF : 2024-066).
Suivant : Mise en route →
