Cross-model validation, investigating disagreements, and converging above 90% agreement.
7 · 검증 및 AI 심사위원
추출만으로는 신뢰가 되지 않습니다. *"내 데이터베이스가 정확한지 어떻게 알 수 있나요?"*에 대한 Sci-database의 답변은 모델 간 검증입니다. 독립적인 AI 모델이 논문 샘플을 처음부터 다시 추출하고 플랫폼은 두 모델이 일치하는 부분과 일치하지 않는 부분을 필드별로, 기록별로 정확하게 보여줍니다. 이는 대학원생 대신 모델을 사용하는 Cochrane 스타일의 체계적인 검토의 이중 추출 실행을 반영합니다.
인증 시작
Database 탭에서 완료된 작업에 대해 Validate를 클릭합니다. Validate 탭이 설정 컨트롤과 함께 열립니다.
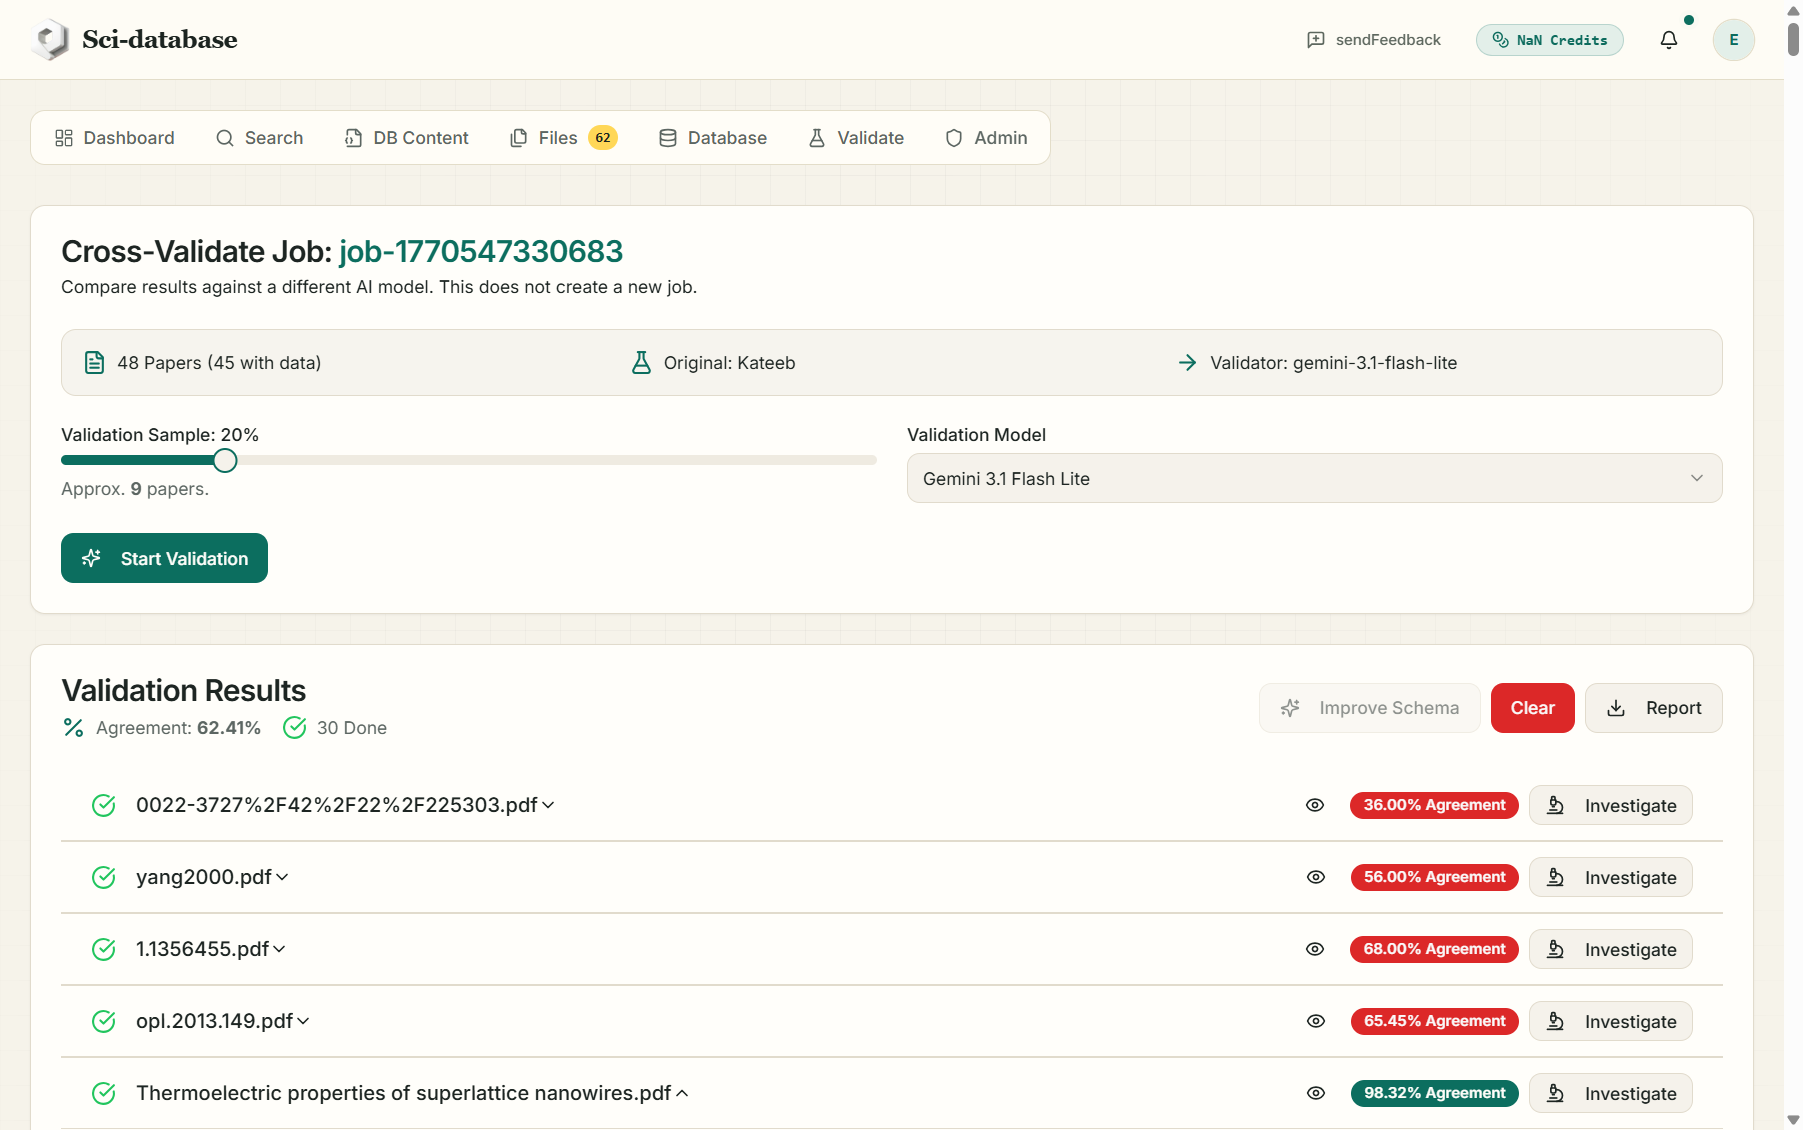
- 검증 샘플 — 데이터를 생성한 논문의 1~100%(기본값 20%) 슬라이더입니다. 정확성을 알기 위해 모든 것을 검증할 필요는 없습니다. 감사가 작동하는 방식은 무작위 샘플입니다.
- 검증 모델 — 두 번째 리더 선택:
- Gemini 3.1 Flash Lite(기본값) 또는 Gemini 3.1 Pro
- GPT-4o-mini (OpenAI) — 자체 API 키 가져오기
- Claude 3.5 Sonnet (Anthropic) — 자신만의 API 키 가져오기
OpenAI/Anthropic 모델의 경우 대화 상자에서 API 키를 묻고 다음과 같이 표시됩니다. "이 키는 이 검증 세션에만 사용되며 저장되지 않습니다."
- 검증 시작 — 비용은 샘플 용지당 2크레딧입니다. 진행 상황은 *"i/N 유효성 검사 중"*으로 표시됩니다.
유효성 검사기 모델은 동일한 전체 문서 텍스트와 동일한 스키마를 받지만 자체적으로 훨씬 더 엄격한 지침을 받습니다(전체 문서를 분석하고 초록에만 의존하지 마십시오. 약어 없음, 최대 특이성, 정확한 수치 정밀도, 부재 시 N/A).
결과 읽기
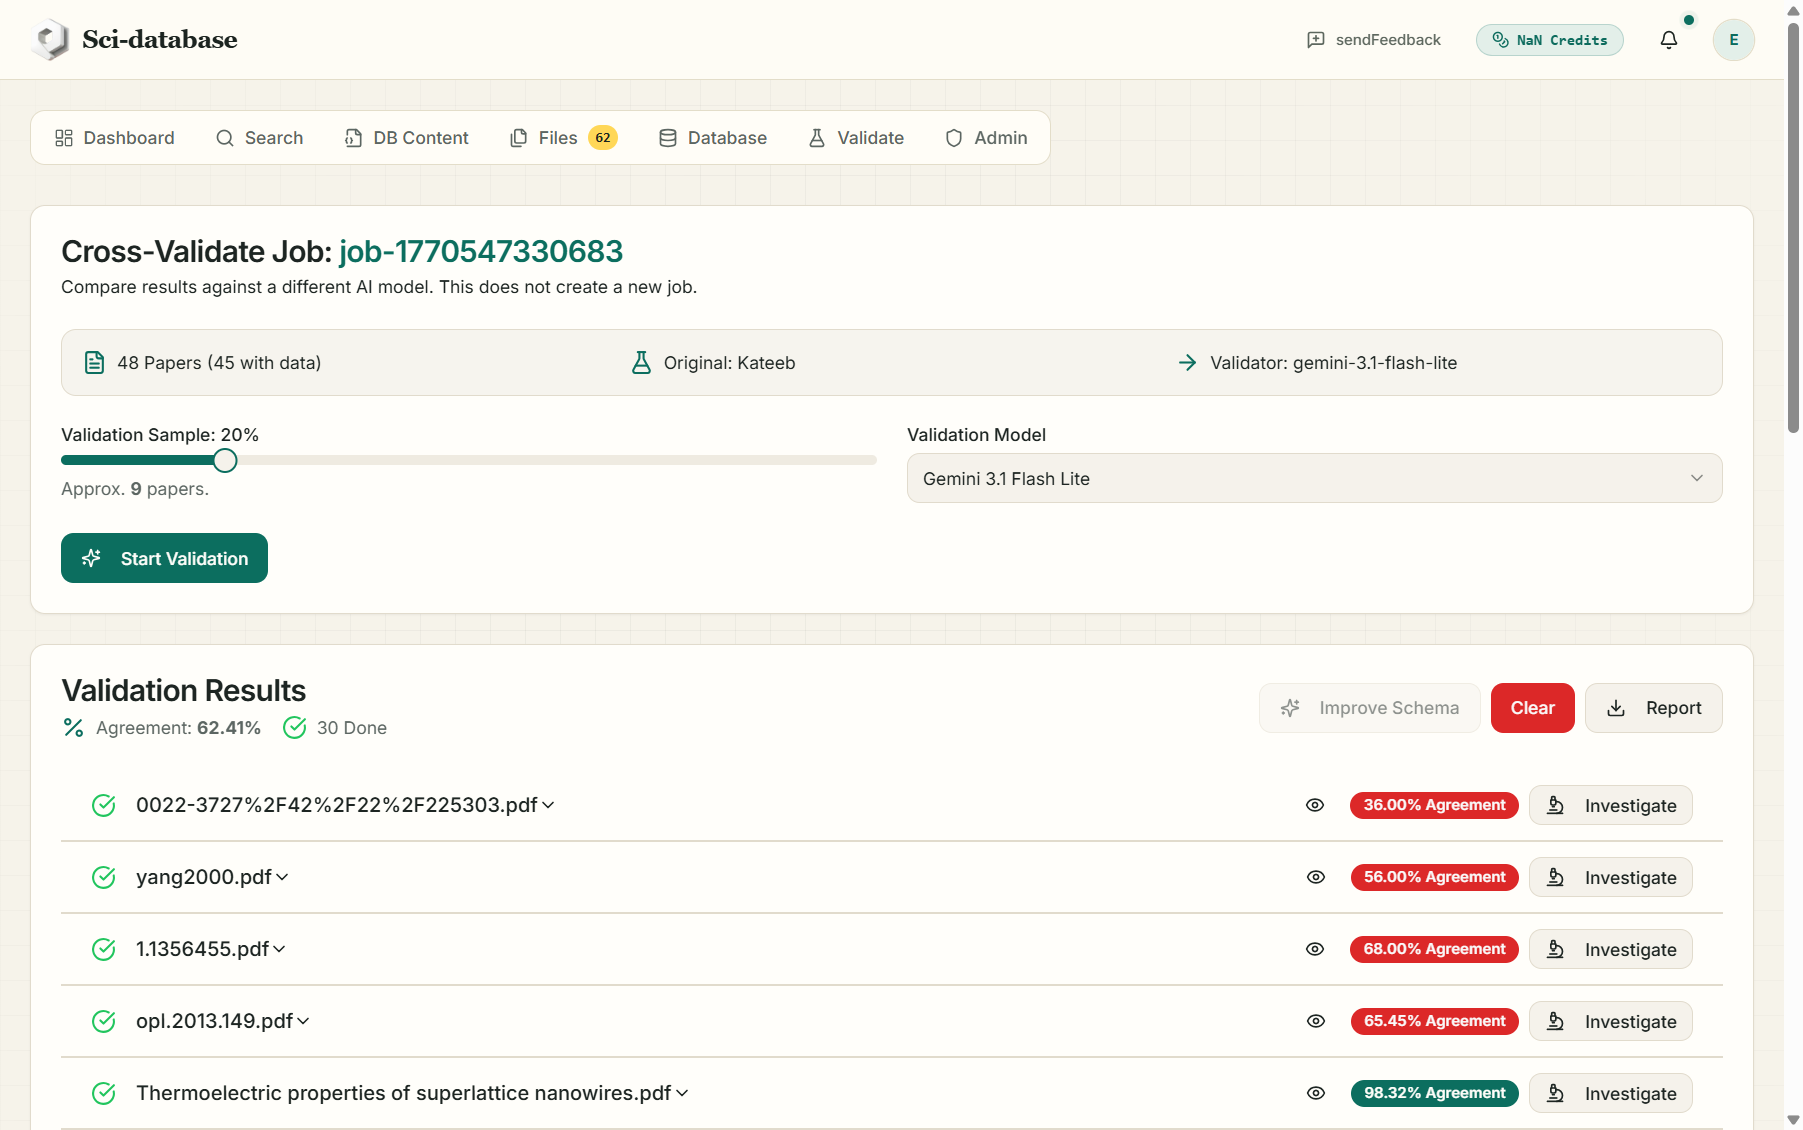
헤더에는 검증된 모든 필드의 전체 동의율이 표시되며, 각 논문에는 자체 동의 배지가 표시됩니다. 녹색 체크 = 전체 동의; 빨간색 삼각형 = 불일치가 발견되었습니다. 필드는 유효성 검사기가 비어 있지 않은 다른 값을 반환한 경우에만 동의하지 않음으로 간주됩니다. 유효성 검사기가 필드에 대해 아무것도 찾지 못한 경우 충돌이 아닌 중립(ℹ)으로 표시됩니다.
종이를 펼치면 기록 비교 표를 볼 수 있습니다.
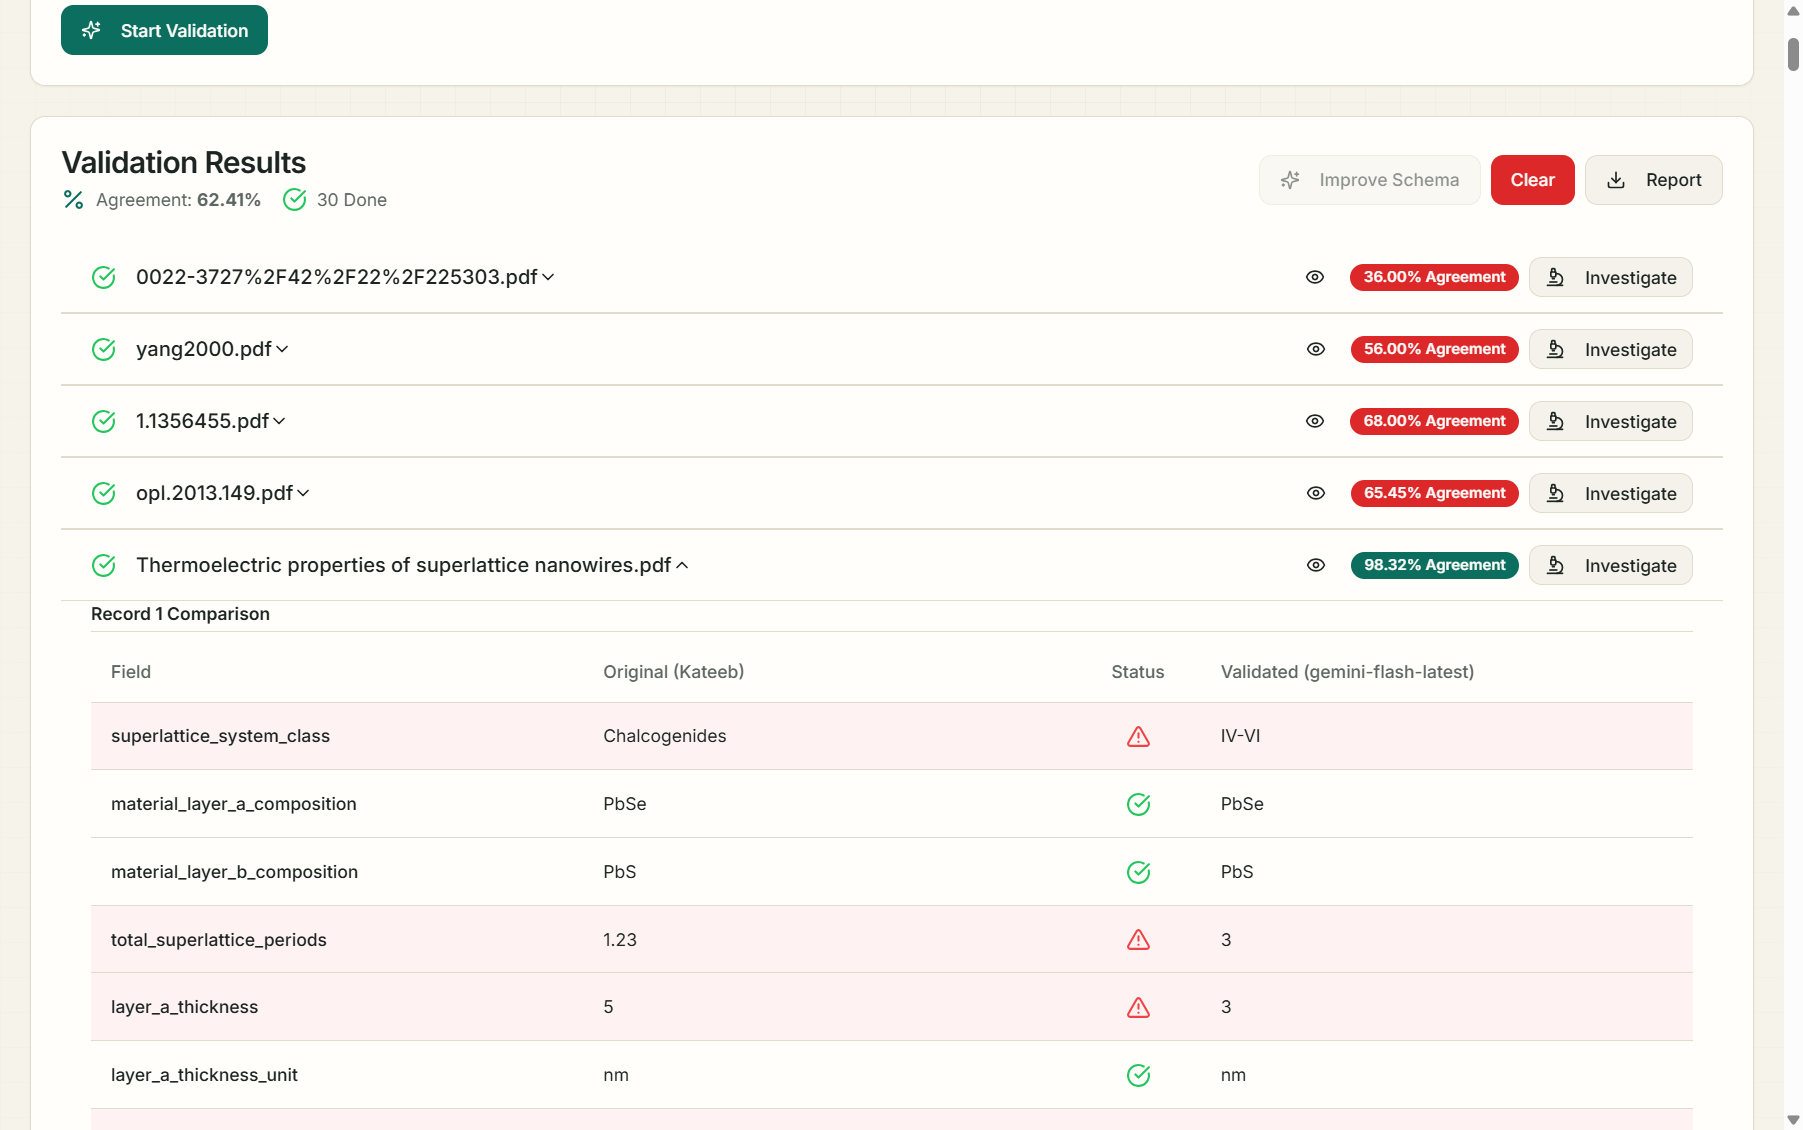
| 칼럼 | 내용 |
|---|---|
| 필드 | 스키마 필드 |
| 원본(Kateeb) | 첫 번째 추출에서 발견한 것 |
| 상태 | ✅ 일치 · ⚠️ 불일치(행이 빨간색으로 강조 표시됨) · ℹ️ 검사기에서 아무것도 발견하지 못함 |
| 검증됨(모델) | 두 번째 모델이 발견한 내용 |
숨겨진 것은 없으며 자동으로 수정되는 것도 없습니다. 모든 빨간색 행은 플랫폼이 사용자에게 던지는 질문입니다.
AI 심사위원: 불일치 조사
100% 일치하지 않는 논문의 경우 조사(불일치당 2크레딧)를 클릭하세요. 세 번째 AI는 전문 심사관 역할을 합니다. 이 인공지능은 논쟁이 되는 각 분야에 대한 전체 논문 텍스트를 다시 읽고 두 가지 후보 값 중 하나, 텍스트에서 직접 가리킬 수 있는 값 또는 N/A와 1대 2 문장 추론 중 하나를 반환해야 합니다.
결과는 최종 값과 중재자의 추론이 포함된 조사 결과 행으로 인라인으로 표시됩니다. 그때부터 중재자의 해결 값이 해당 필드에 대한 참조가 됩니다. 이에 대해 합의 점수가 다시 계산됩니다.
논문 제목, 기록 색인, 필드 이름, 원래 값, 검증된 값, 일치 여부 열이 포함된 보고서 — a CSV (validation_report_job_….csv)로 전체 비교를 다운로드할 수 있으며 원고의 보충 자료에 첨부할 준비가 되어 있습니다.
루프 닫기: 스키마 개선
대부분의 불일치는 모델 실패가 아닙니다. 모호한 필드 설명('효율성' - 초기 또는 안정화, 어떤 단위?)입니다. Improve Schema(5학점)을 클릭하면 AI가 조사된 불일치를 분석하고 더 나은 필드 설명를 제안합니다(이름과 유형은 절대 건드리지 않습니다).
각 제안에는 추론, 이전 설명(빨간색) 및 편집 가능한 제안 설명(녹색)이 표시됩니다. 필드당 수락 및 수정 또는 거부를 수행할 수 있습니다. 허용된 변경 사항은 스키마 편집기에 저장됩니다. 스키마를 저장한 다음 추출을 다시 실행하세요.
90% 이상으로 수렴
이는 플랫폼이 설계된 신뢰 루프입니다.
  extract  →  validate (2nd model)  →  investigate (AI Judge)  →  improve schema  →  re-run
     ▲                                                                                │
     └────────────────────────────────────────────────────────────────────────────────┘
패스에 대한 일반적인 궤적: 첫 번째 원시 실행에서 ~70% 동의(모델은 단위 및 모호한 필드에 동의하지 않음) → 스키마 개선 후 ~85% → 플랫폼의 신뢰 임계값인 90%+, 이 시점에서 불일치는 귀하가 개인적으로 판결한 실제로 엄격한 판단에 국한됩니다. 이제 귀하의 데이터베이스는 동료 검토를 통해 방어할 수 있습니다. 검증 보고서를 통해 이를 입증하세요.
다음: 데이터베이스 및 내보내기 →
