Cross-model validation, investigating disagreements, and converging above 90% agreement.
7 · Validación y juez de IA
La extracción por sí sola no es confianza. La respuesta de Sci-database a "¿cómo sé que mi base de datos es precisa?" es validación entre modelos: un modelo de IA independiente vuelve a extraer una muestra de sus artículos desde cero, y la plataforma le muestra exactamente dónde coinciden y no coinciden los dos modelos: campo por campo, registro por registro. Esto refleja la práctica de extracción dual de las revisiones sistemáticas de estilo Cochrane, con modelos en lugar de estudiantes de posgrado.
Iniciando una validación
En la pestaña Base de datos, haga clic en Validar en cualquier trabajo completado. Se abre la pestaña Validar con los controles de configuración:
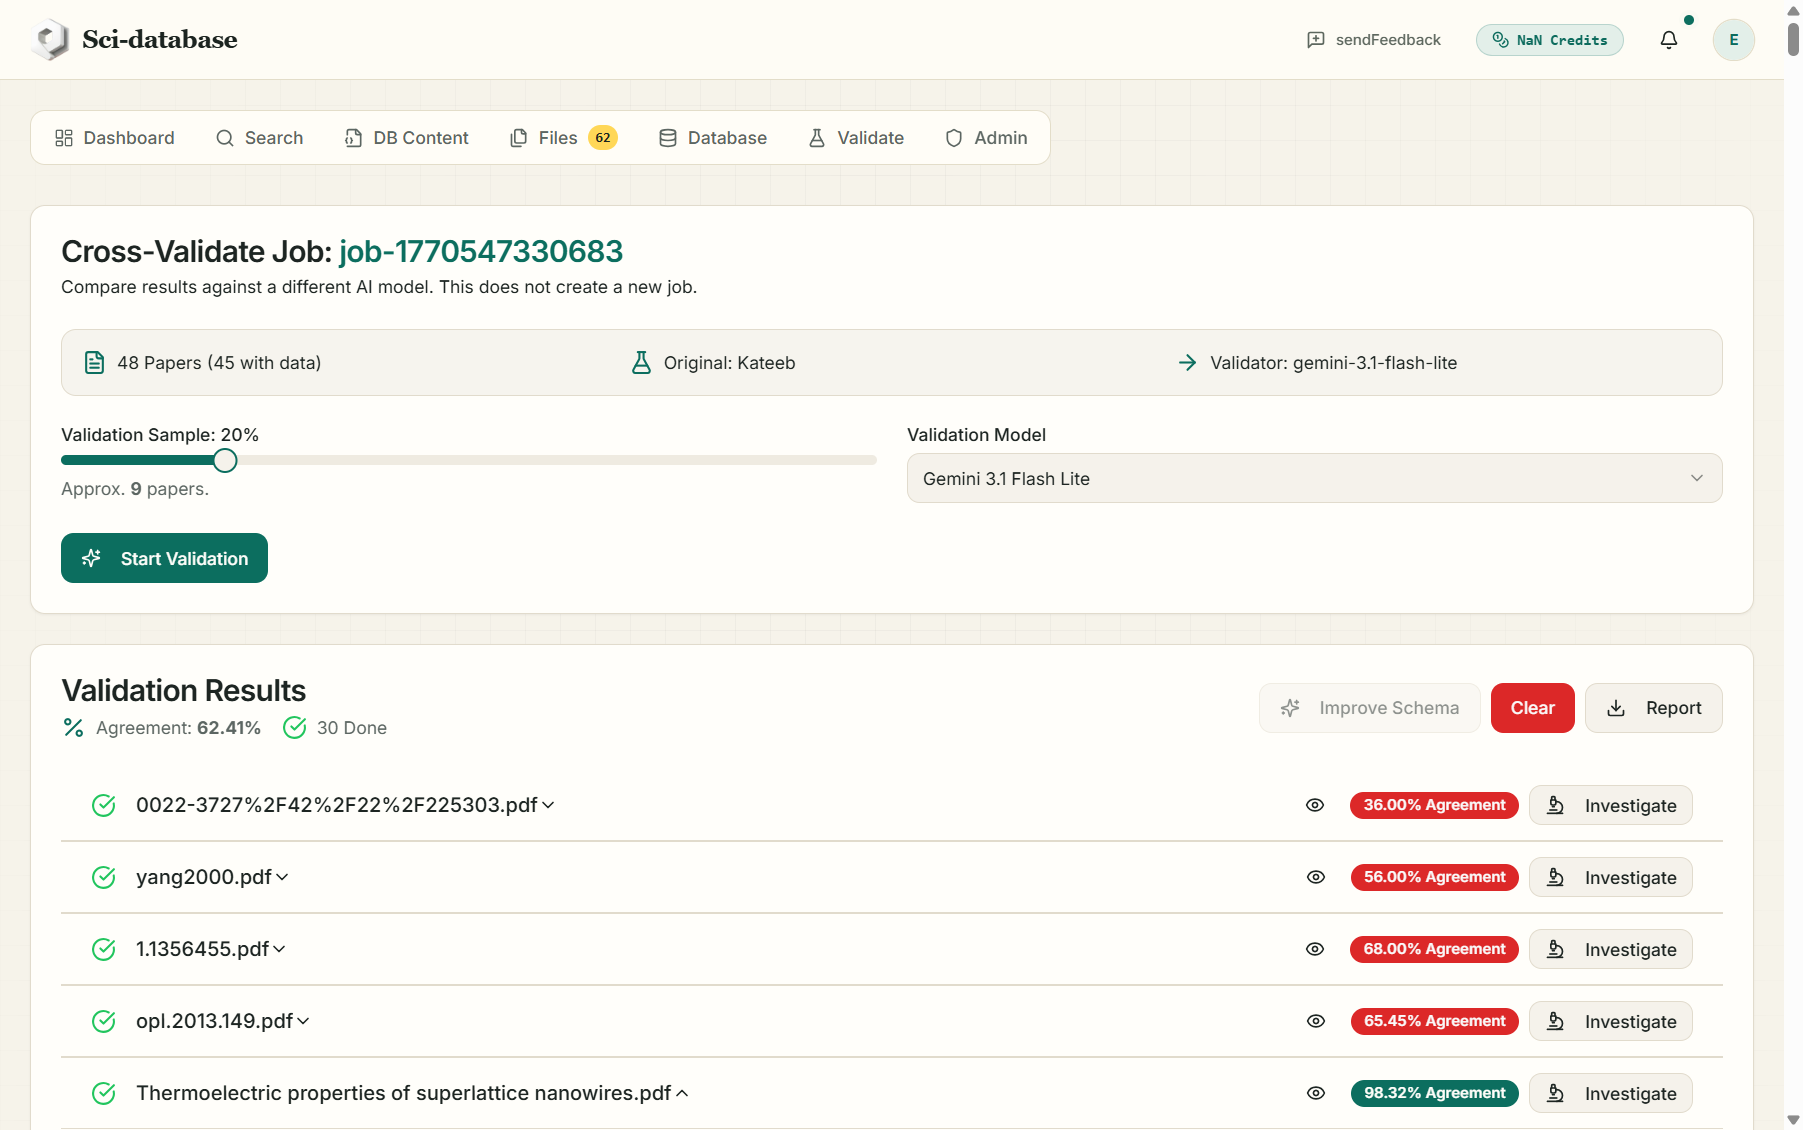
- Muestra de validación: un control deslizante del 1 al 100 % (predeterminado, 20 %) de los artículos que produjeron datos. No es necesario validar todo para conocer su precisión: una muestra aleatoria es cómo funciona la auditoría.
- Modelo de validación - elija el segundo lector:
- Gemini 3.1 Flash Lite (predeterminado) o Gemini 3.1 Pro
- GPT-4o-mini (OpenAI): traiga su propia clave API
- Claude 3.5 Sonnet (Antrópico): traiga su propia clave API
Para los modelos OpenAI/Anthropic, un cuadro de diálogo solicita su clave API y dice: "Esta clave solo se usará para esta sesión de validación y no se almacenará".
- Iniciar validación: cuesta 2 créditos por artículo de muestra. El progreso se muestra como "Validando i/N".
El modelo de validador recibe el mismo texto completo en papel y su mismo esquema, pero con sus propias instrucciones aún más estrictas (analice el documento completo, nunca confíe únicamente en el resumen; sin abreviaturas; máxima especificidad; precisión numérica exacta; N/A cuando está ausente).
Leyendo los resultados
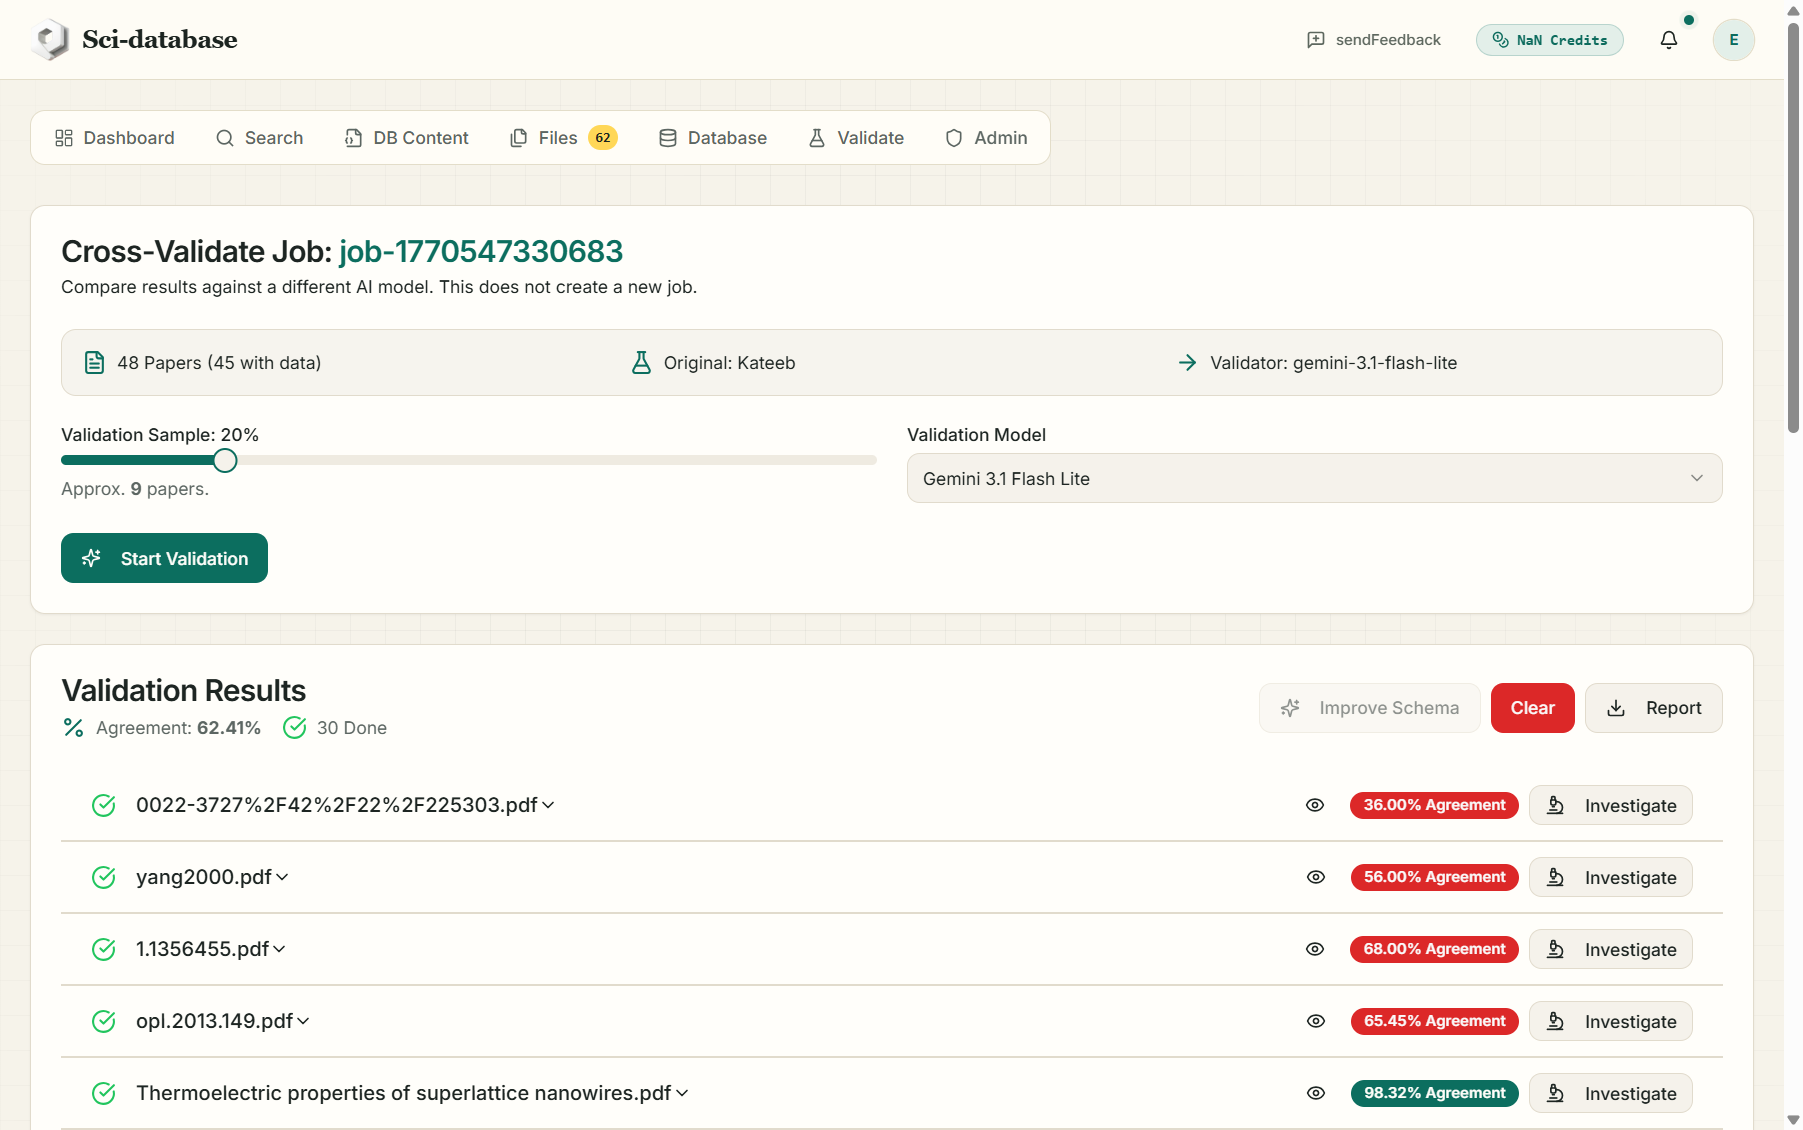
El encabezado muestra el porcentaje de acuerdo general en todos los campos validados y cada documento obtiene su propia insignia de acuerdo. Cheque verde = acuerdo total; triángulo rojo = desacuerdos encontrados. Un campo cuenta como desacuerdo solo cuando el validador devolvió un valor diferente no vacío; si el validador no encontró nada para un campo, se marca como neutral (ℹ), no como conflicto.
Expanda cualquier documento para ver la tabla Comparación de registros:
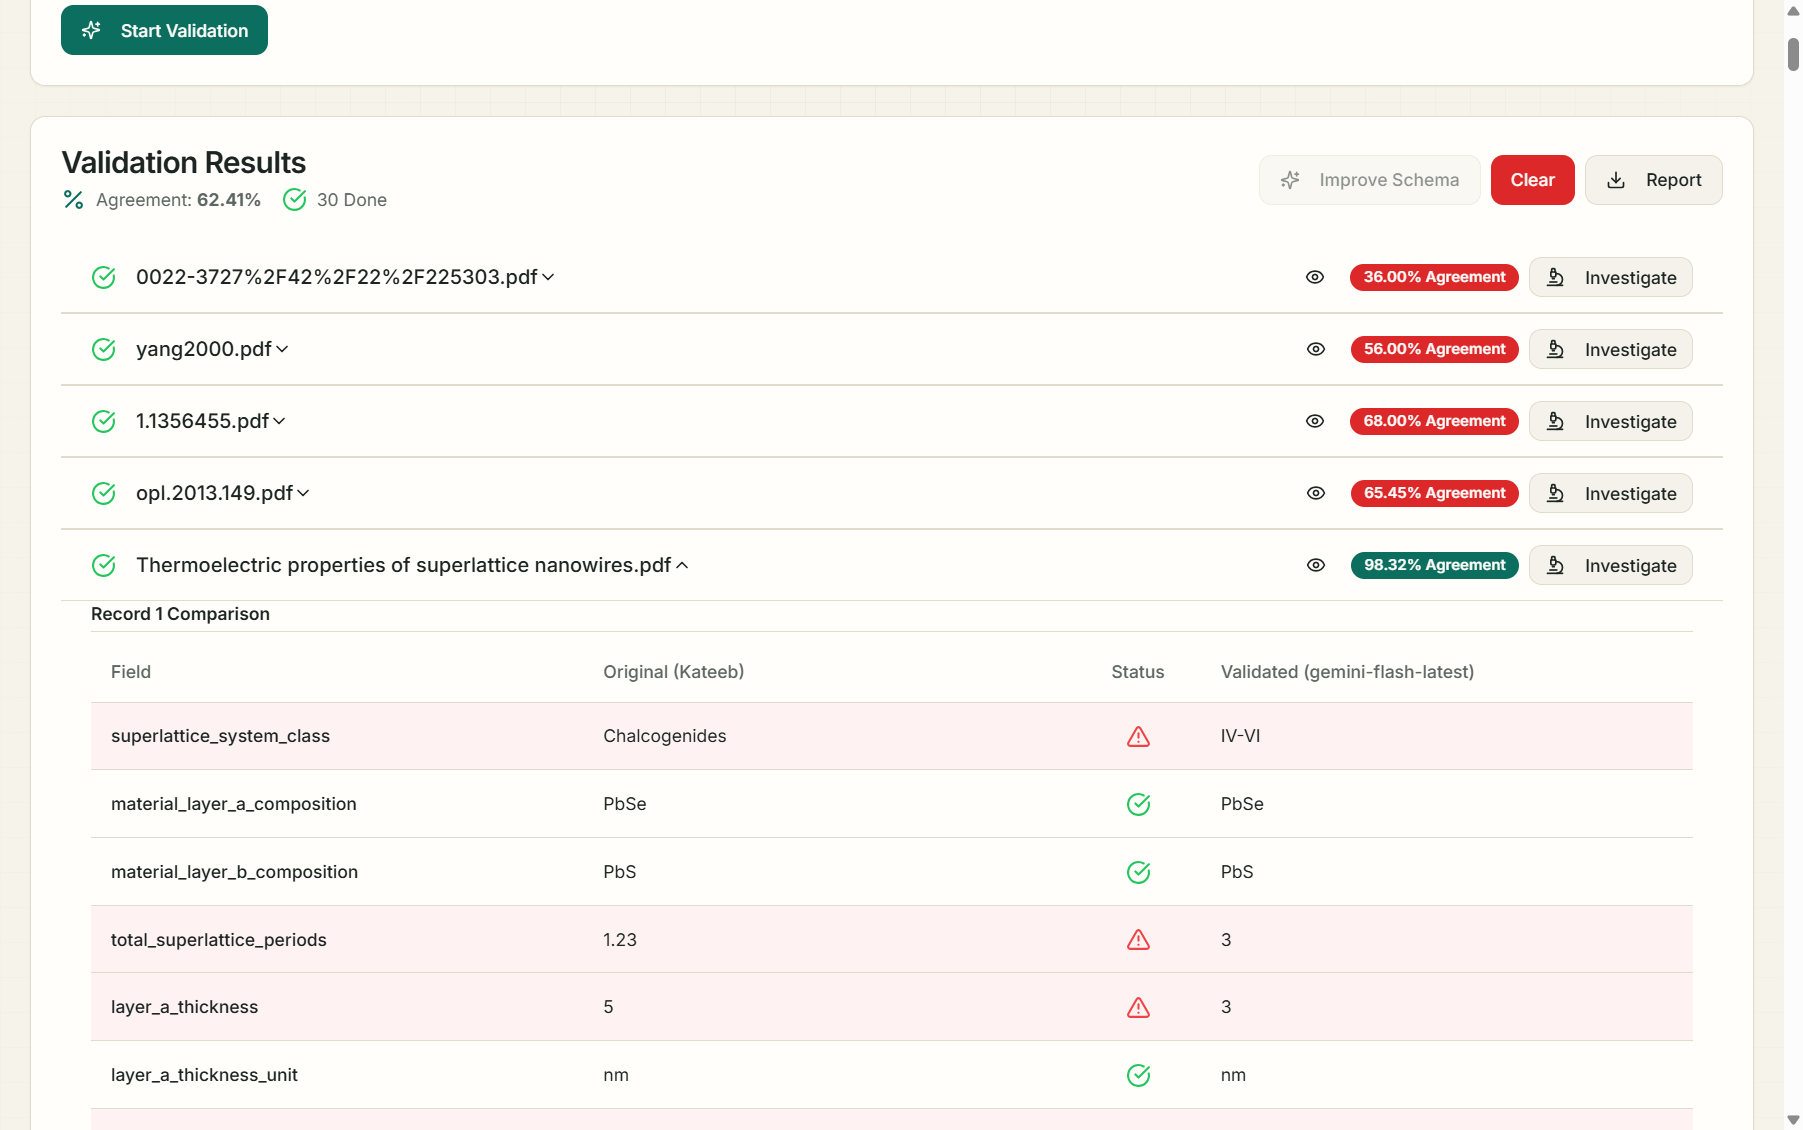
| Columna | Contenido |
|---|---|
| Campo | Su campo de esquema |
| Original (Kateeb) | Lo que encontró la primera extracción |
| Estado | ✅ coincidencia · ⚠️ falta de coincidencia (fila resaltada en rojo) · ℹ️ el validador no encontró nada |
| Validado (modelo) | Lo que encontró el segundo modelo |
Nada está oculto y nada se corrige automáticamente: cada fila roja es una pregunta que la plataforma le hace.
El juez AI: investigando desacuerdos
Para cualquier trabajo que esté por debajo del 100% de acuerdo, haga clic en Investigar (2 créditos por discrepancia). Una tercera IA actúa como un adjudicador experto: relee el texto completo del artículo para cada campo en disputa y debe devolver cualquiera de los dos valores candidatos, un valor al que puede señalar directamente en el texto, o N/A, más un razonamiento de una a dos oraciones.
El resultado aparece en línea como una fila Resultado de la investigación con el valor final y el razonamiento del árbitro. A partir de ese momento, el valor resuelto del árbitro se convierte en la referencia para ese campo: la puntuación del acuerdo se vuelve a calcular en función de él.
Puede descargar la comparación completa como Informe: un CSV (validation_report_job_….csv) con columnas Título del artículo, Índice de registro, Nombre de campo, Valor original, Valor validado, Coincidencia, lista para adjuntar a los materiales complementarios de un manuscrito.
Cerrando el ciclo: Mejorar esquema
La mayoría de los desacuerdos no son fallas del modelo: son descripciones de campo ambiguas ("eficiencia": ¿de qué? ¿inicial o estabilizada? ¿qué unidad?). Haga clic en Mejorar esquema (5 créditos) y la IA analiza las discrepancias investigadas y propone mejores campos descripciones (los nombres y tipos nunca se tocan).
Cada sugerencia muestra el razonamiento, la descripción anterior (rojo) y una descripción sugerida editable (verde); usted Aceptar y Editar o Rechazar por campo. Los cambios aceptados llegan a su editor de esquemas: guarde el esquema y luego vuelva a ejecutar la extracción.
Convergiendo a 90%+
Este es el bucle de confianza en torno al cual está diseñada la plataforma:
  extract  →  validate (2nd model)  →  investigate (AI Judge)  →  improve schema  →  re-run
     ▲                                                                                │
     └────────────────────────────────────────────────────────────────────────────────┘
Una trayectoria típica en las pasadas: ~70% de acuerdo en la primera ejecución sin procesar (los modelos no están de acuerdo en unidades y campos ambiguos) → ~85% después de refinar el esquema → 90%+, el umbral de confianza de la plataforma, en cuyo punto el desacuerdo se limita a decisiones de juicio genuinamente duras que usted ha adjudicado personalmente. Su base de datos ahora es algo que puede defender en una revisión por pares, con el informe de validación para demostrarlo.
Siguiente: Su base de datos y exportaciones →
