What Sci-database is, who it's for, and the 4 academic trust principles.
1 · Introducción
¿Qué es Sci-database?
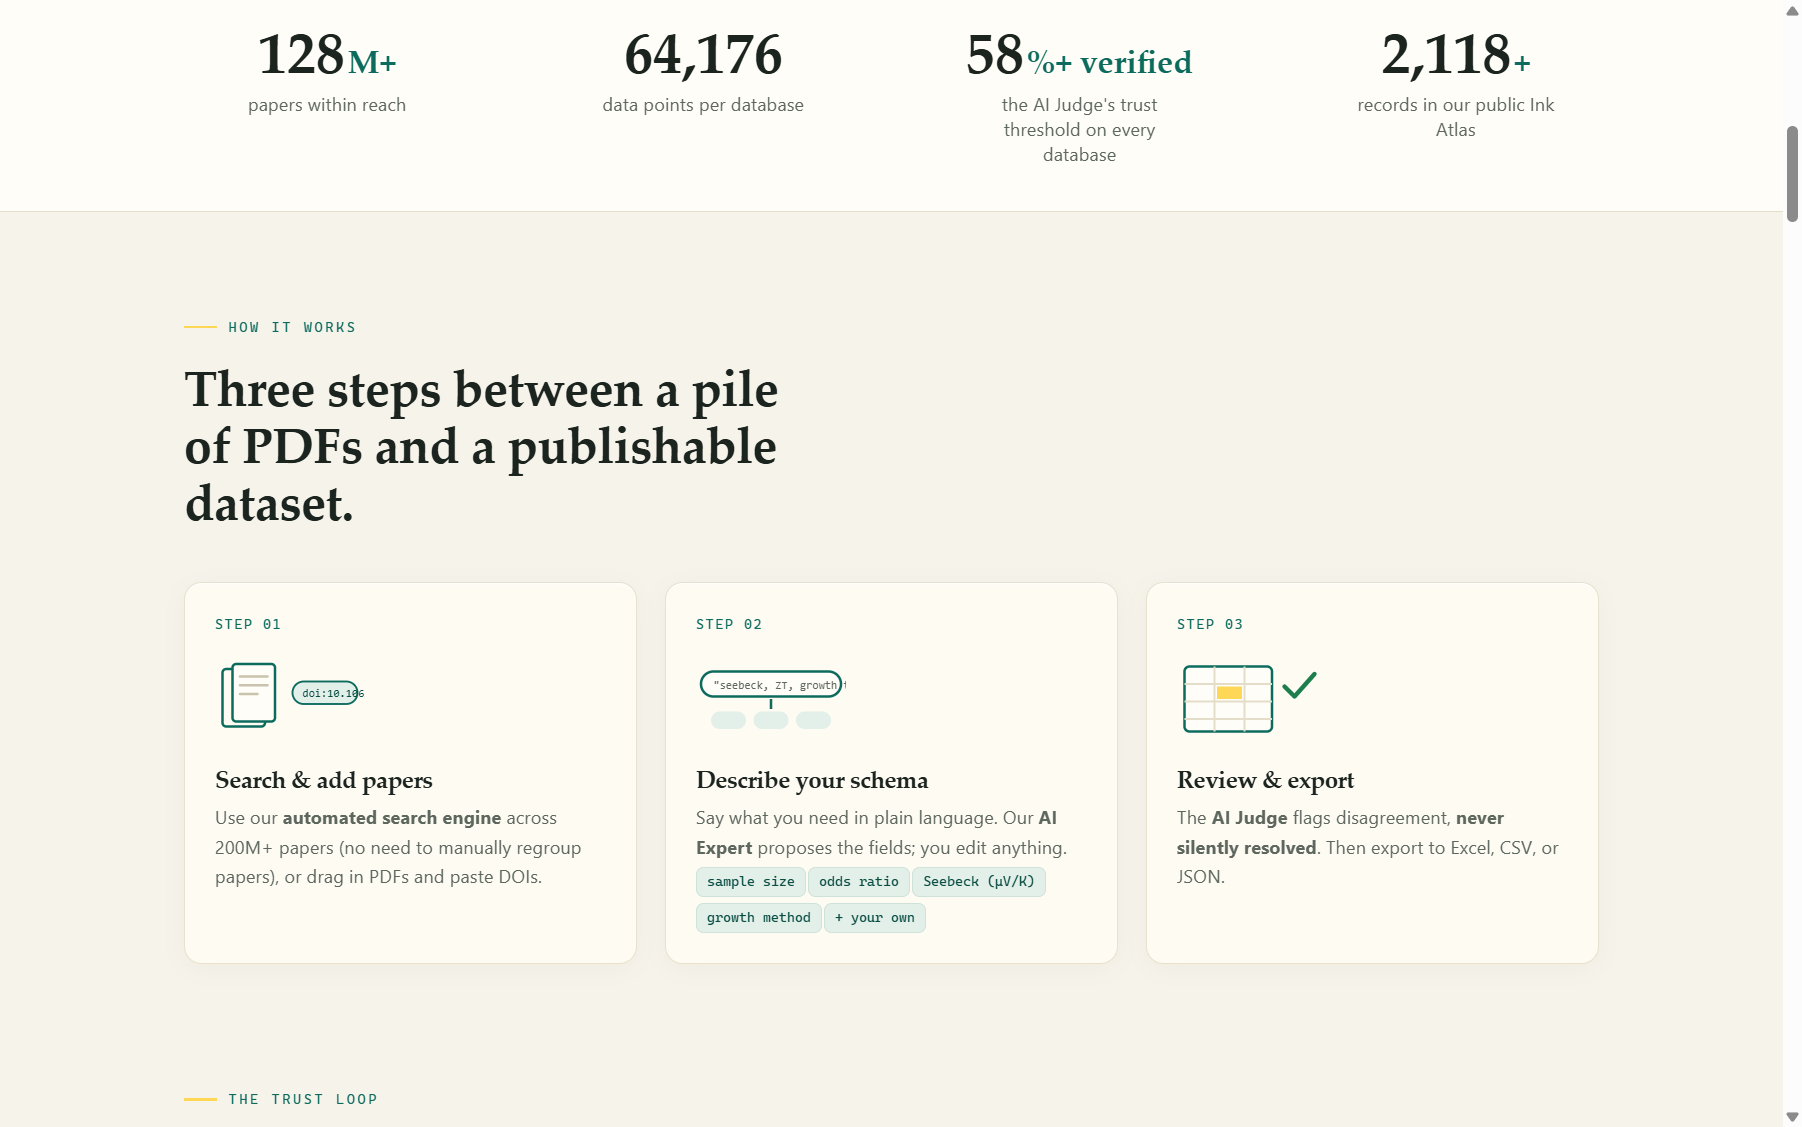
Sci-database convierte montones de archivos PDF de investigación en una base de datos estructurada y verificada. En lugar de pasar meses copiando manualmente valores de cientos de documentos en una hoja de cálculo, usted:
- Busque más de 200 millones de artículos científicos a través de repositorios públicos (OpenAlex, CORE, Semantic Scholar) o cargue sus propios archivos PDF.
- Describe los datos que necesitas en un lenguaje sencillo: la IA propone un esquema estructurado (las columnas de tu futura base de datos), que puedes editar campo por campo.
- Extracto: el motor Kateeb lee cada artículo completo y completa su esquema. Un artículo puede producir varios registros (por ejemplo, una fila por material o por condición experimental).
- Validar: un segundo modelo de IA independiente vuelve a extraer una muestra de sus artículos y la plataforma muestra una comparación campo por campo. Los desacuerdos se señalan, pero nunca se resuelven silenciosamente.
- Exporta tu base de datos a Excel lista para CSV o JSON, o compártela públicamente para contribuir a la ciencia abierta.
¿Para quién es?
| Eres… | Usas Sci-database para… |
|---|---|
| Un revisor sistemático/metaanalista | Extrae resultados, tamaños de muestras, tamaños de efectos y características de estudios de cientos de ensayos, luego alimenta a R (meta), Stata o RevMan |
| Un científico/físico/químico de materiales | Crear bases de datos de propiedades (por ejemplo, coeficientes de Seebeck, valores ZT, bandas prohibidas, métodos de síntesis) para artículos de revisión |
| Un investigador de ML | Convierta la literatura en datos de entrenamiento etiquetados a escala |
| Cualquier investigador que escriba una reseña | Reemplace meses de entrada manual de datos con una tarde de extracción supervisada |
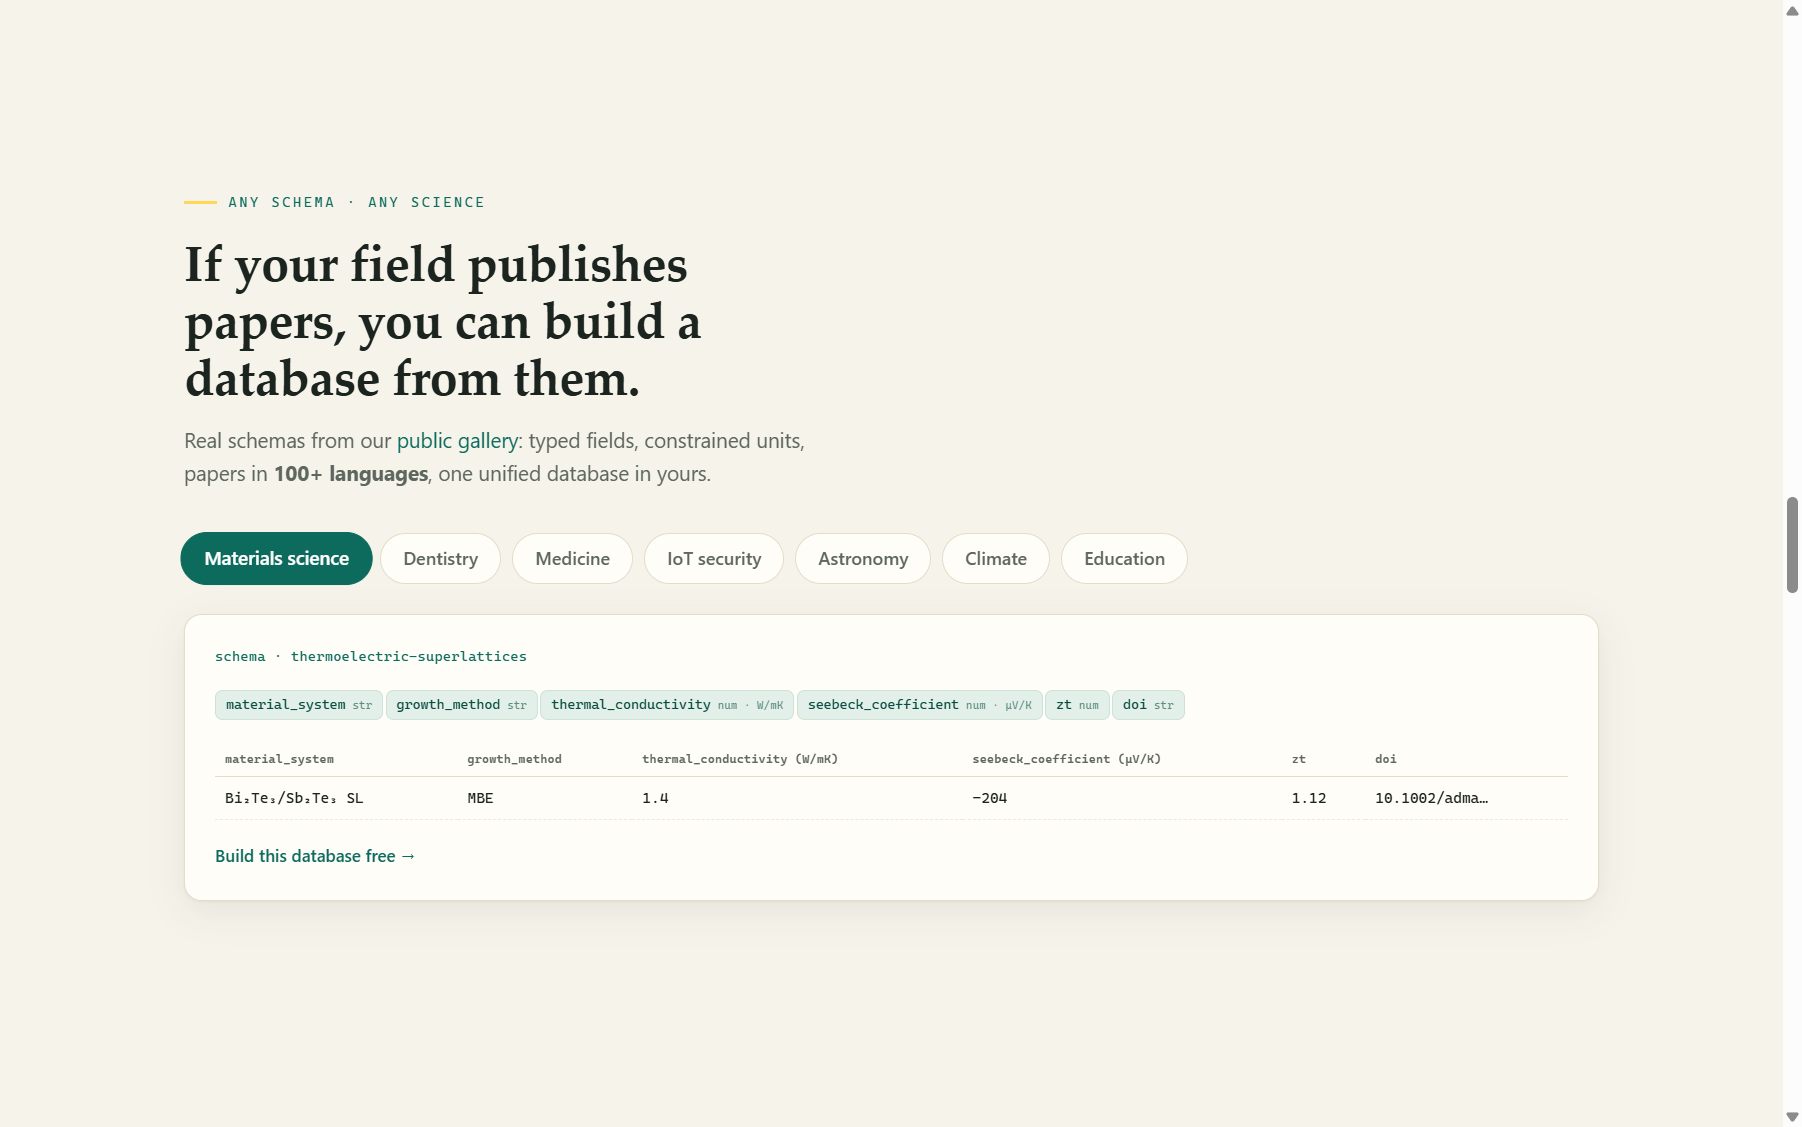
Si su campo publica artículos, puede crear una base de datos a partir de ellos: la plataforma es independiente del dominio. Ya existen esquemas públicos para termoelectricidad, compuestos dentales, ECA sobre hipertensión, seguridad de IoT, observaciones de supernovas, proyecciones climáticas y más.
Los principios de confianza
Sci-database está diseñado para uso académico, donde un número incorrecto en un metanálisis es peor que uno faltante. Cuatro principios recorren todo el producto:
1. Cero datos sintéticos
El modelo de extracción opera bajo una instrucción estricta: si falta un valor en el documento, o el modelo no es muy seguro, debe devolver exactamente N/A: nunca una suposición, nunca una invención que suene plausible.
2. Nada se resuelve silenciosamente
Cuando el modelo del validador no está de acuerdo con la extracción original, el desacuerdo se le muestra **** en una fila de comparación resaltada en rojo. Usted (opcionalmente ayudado por un tercer árbitro de IA) decide cuál es la verdad.
3. Converge, no esperes
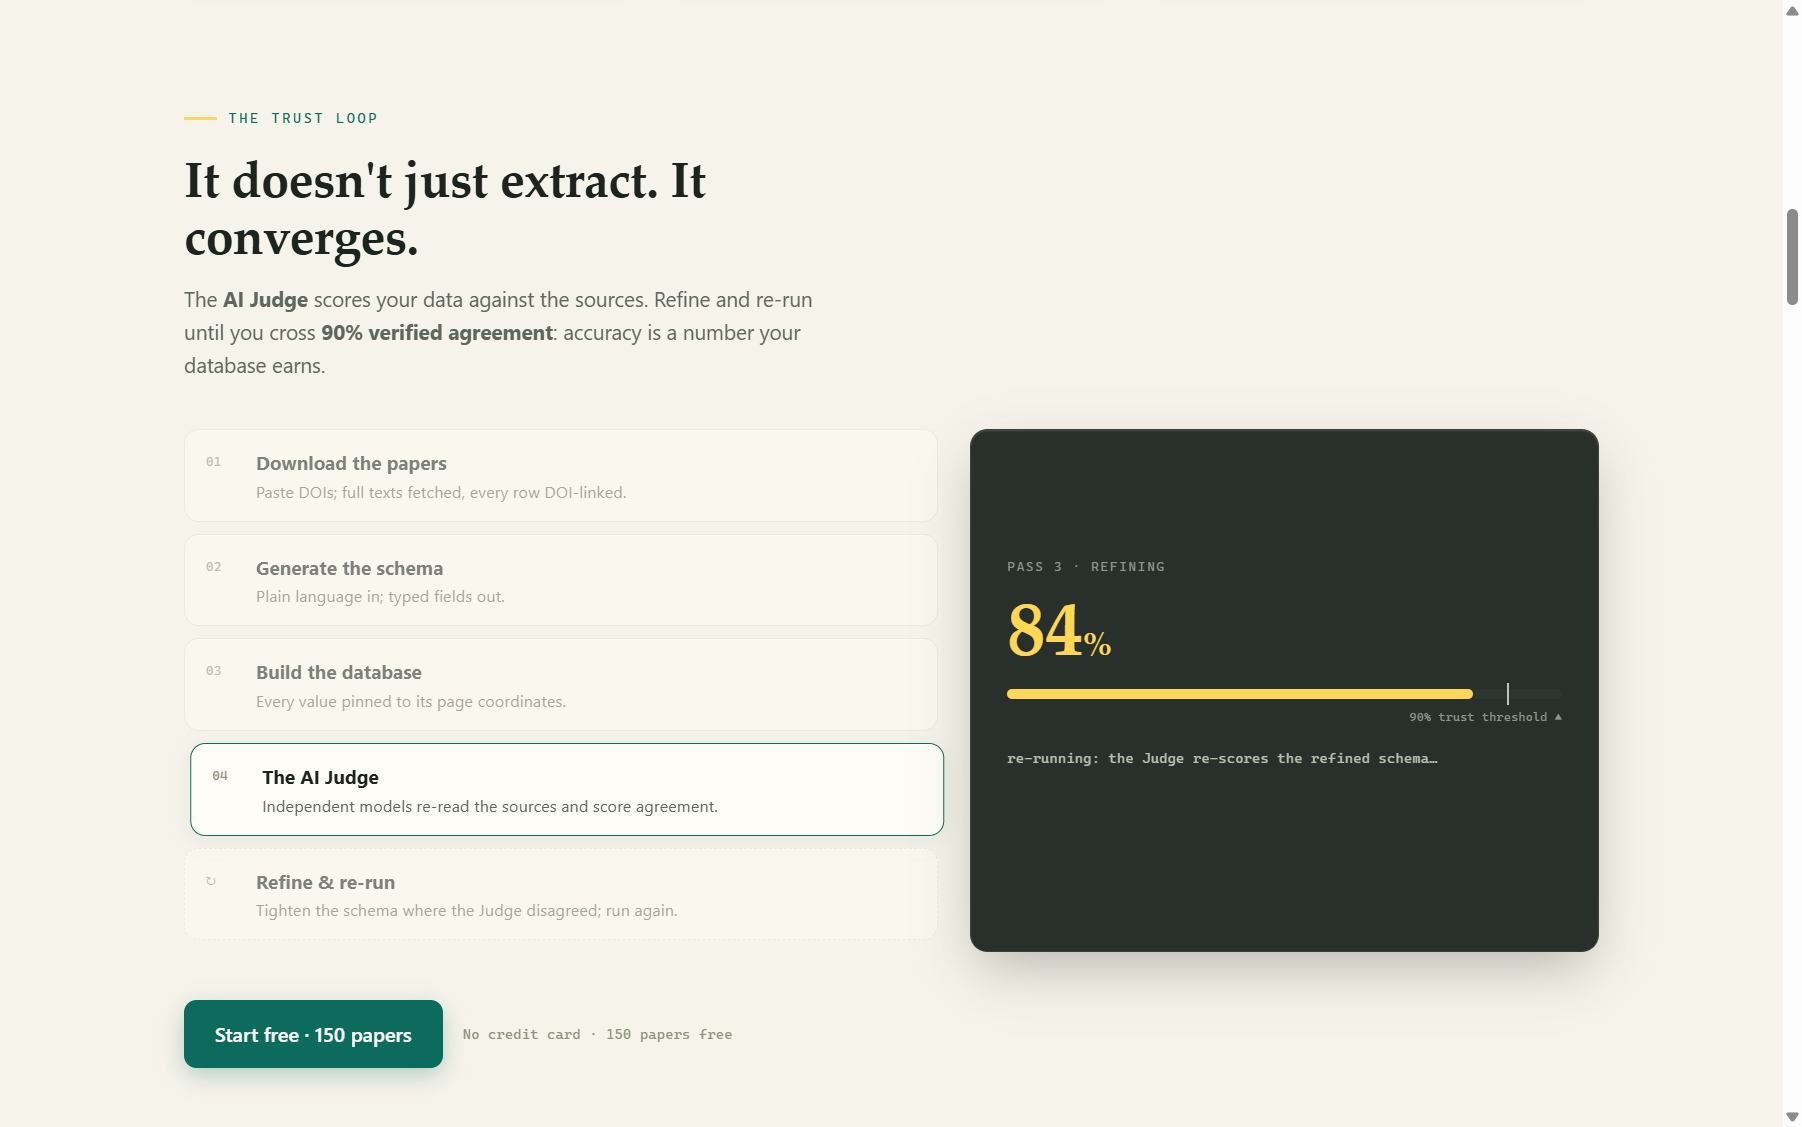
La extracción no es una sola oportunidad. El ciclo previsto es: extraer → validar con un segundo modelo → investigar desacuerdos → dejar que la IA mejore las descripciones de los campos de su esquema → volver a ejecutar. Cada pase plantea el acuerdo entre modelos; El umbral de confianza de la plataforma es 90%+ acuerdo antes de que una base de datos se considere "confiable".
4. Tus datos siguen siendo tuyos
- Sus documentos y datos extraídos son privados para su cuenta de forma predeterminada.
- Su esquema (solo las definiciones de campo, sin datos) se puede compartir en la galería pública para ayudar a otros investigadores; esto se establece en los Términos que acepta al registrarse.
- Las cargas nunca se utilizan para entrenar modelos.
- Puedes eliminar tus archivos, trabajos y bases de datos en cualquier momento.
El motor Kateeb
El motor de extracción tiene la marca Kateeb (كاتب, "escriba" en árabe). En las vistas de validación, la columna de extracción original siempre está etiquetada como "Original (Kateeb)" para que pueda saber de un vistazo qué modelo produjo qué valor. Sci-database fue desarrollado en la Universidad Hamad Bin Khalifa (Doha, Qatar) y está registrado como patente (QF Ref: 2024-066).
Siguiente: Empezando →
