The Kateeb engine, multi-record extraction, zero-hallucination rules, and resume.
6 · Executando uma extração
Com os arquivos verificados na fila e um esquema salvo, você está pronto para o evento principal.
Iniciando um trabalho
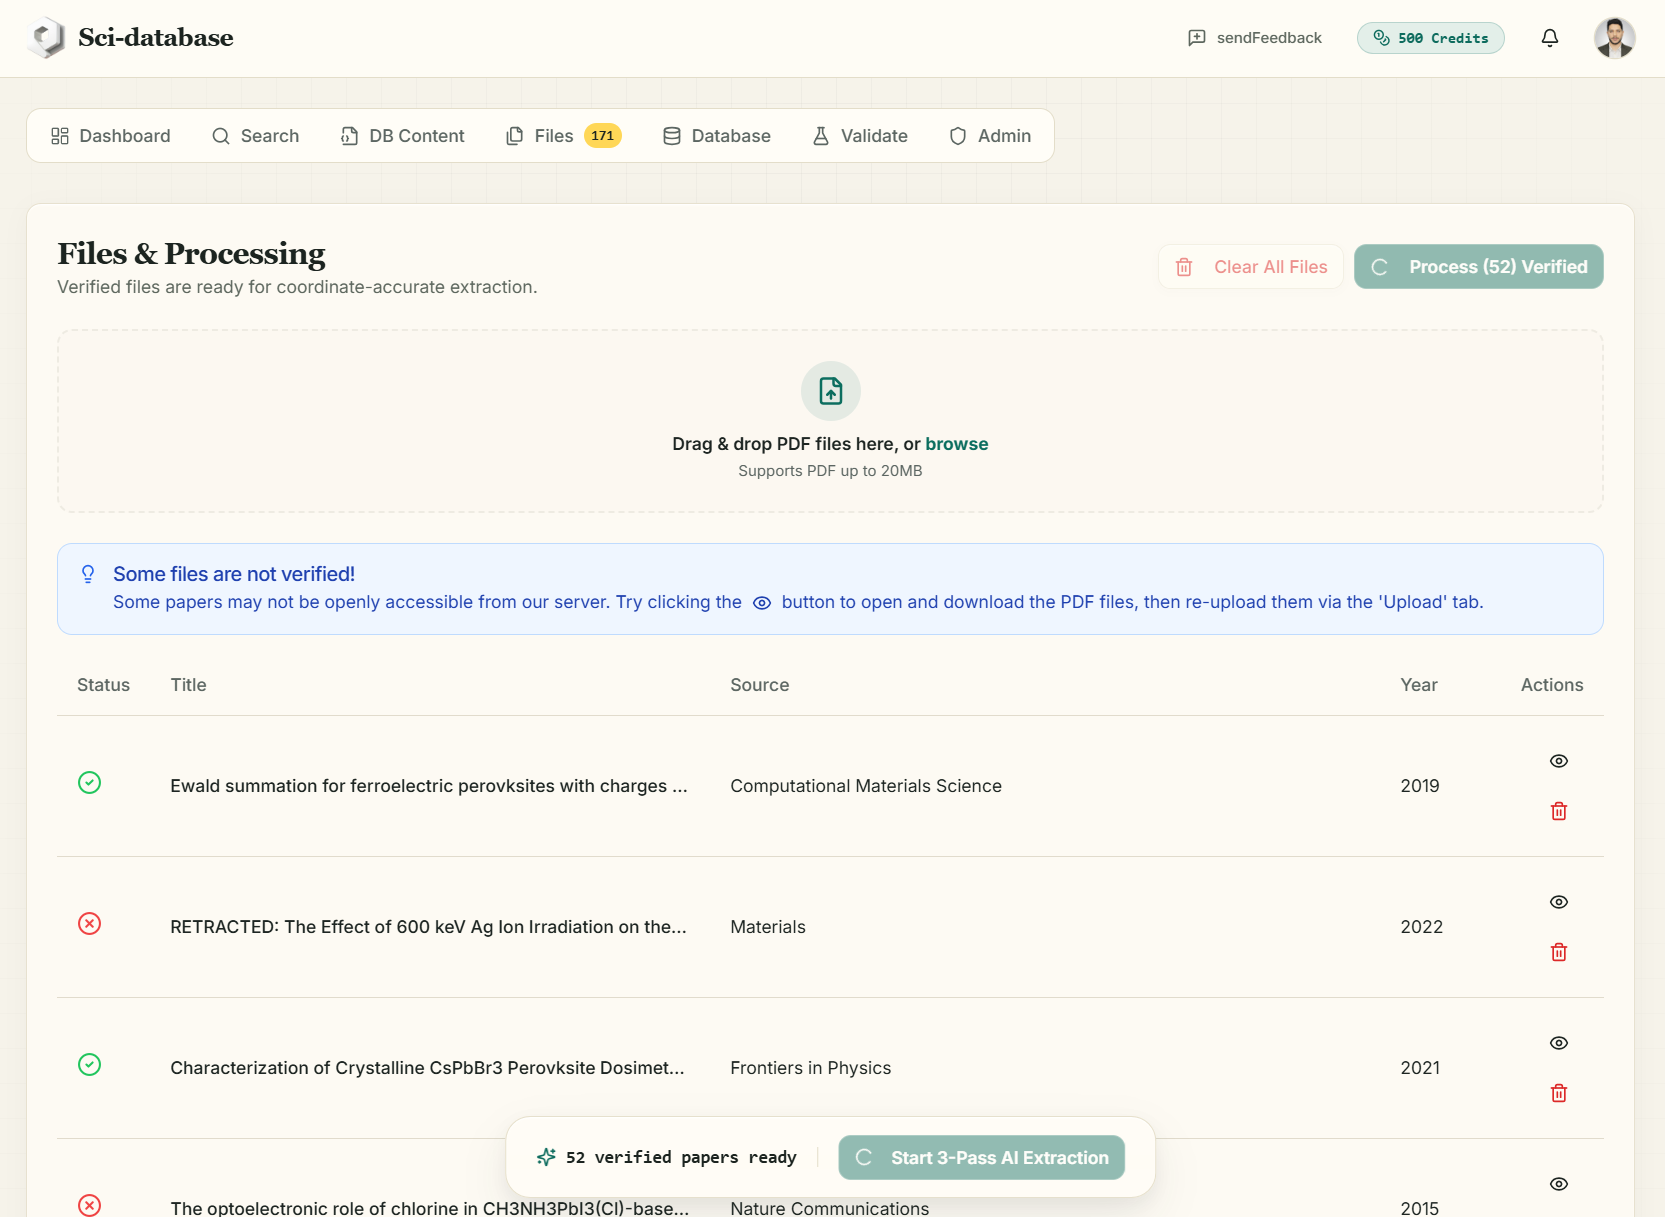
Na guia Arquivos, clique em Processo (N) verificado (ou Iniciar extração de IA em 3 passagens na doca flutuante). O que acontece:
- 1 crédito por artigo é cobrado antecipadamente.
- Um job é criado contendo seus documentos e um instantâneo permanente do seu esquema.
- Você recebe um e-mail de confirmação ("Sci-database Trabalho enviado"), o brinde "Trabalho enviado — N documentos estão sendo processados." aparece e o aplicativo muda você para a guia Banco de dados automaticamente.
Você pode fechar o navegador — o processamento continua no servidor e os resultados serão enviados para você por e-mail.
O que acontece com cada papel
Os documentos são processados um de cada vez, na seguinte ordem:
- O PDF é baixado e seu texto completo extraído (até ~950.000 caracteres — artigos inteiros, não apenas resumos).
- O mecanismo Kateeb lê o texto em relação ao seu esquema sob instruções estritas - as principais, literalmente a partir do prompt de extração:
- "Encontre todos os registros distintos que correspondam ao esquema" — um artigo pode produzir várias linhas (por exemplo, vários materiais ou braços de estudo).
- "Se um artigo for irrelevante para o esquema, retorne um array vazio" — papéis irrelevantes não geram nada, nem ruído.
- "Para qualquer campo, se o valor estiver faltando, não estiver presente ou você não estiver 99% confiante, você DEVE retornar a string exata 'N/A'. Não use nulo ou adivinhação."
- "Para valores numéricos, extraia o valor exato do papel. Não arredonde."
- Os registros extraídos e o uso do token são salvos no trabalho.
Assistindo ao progresso
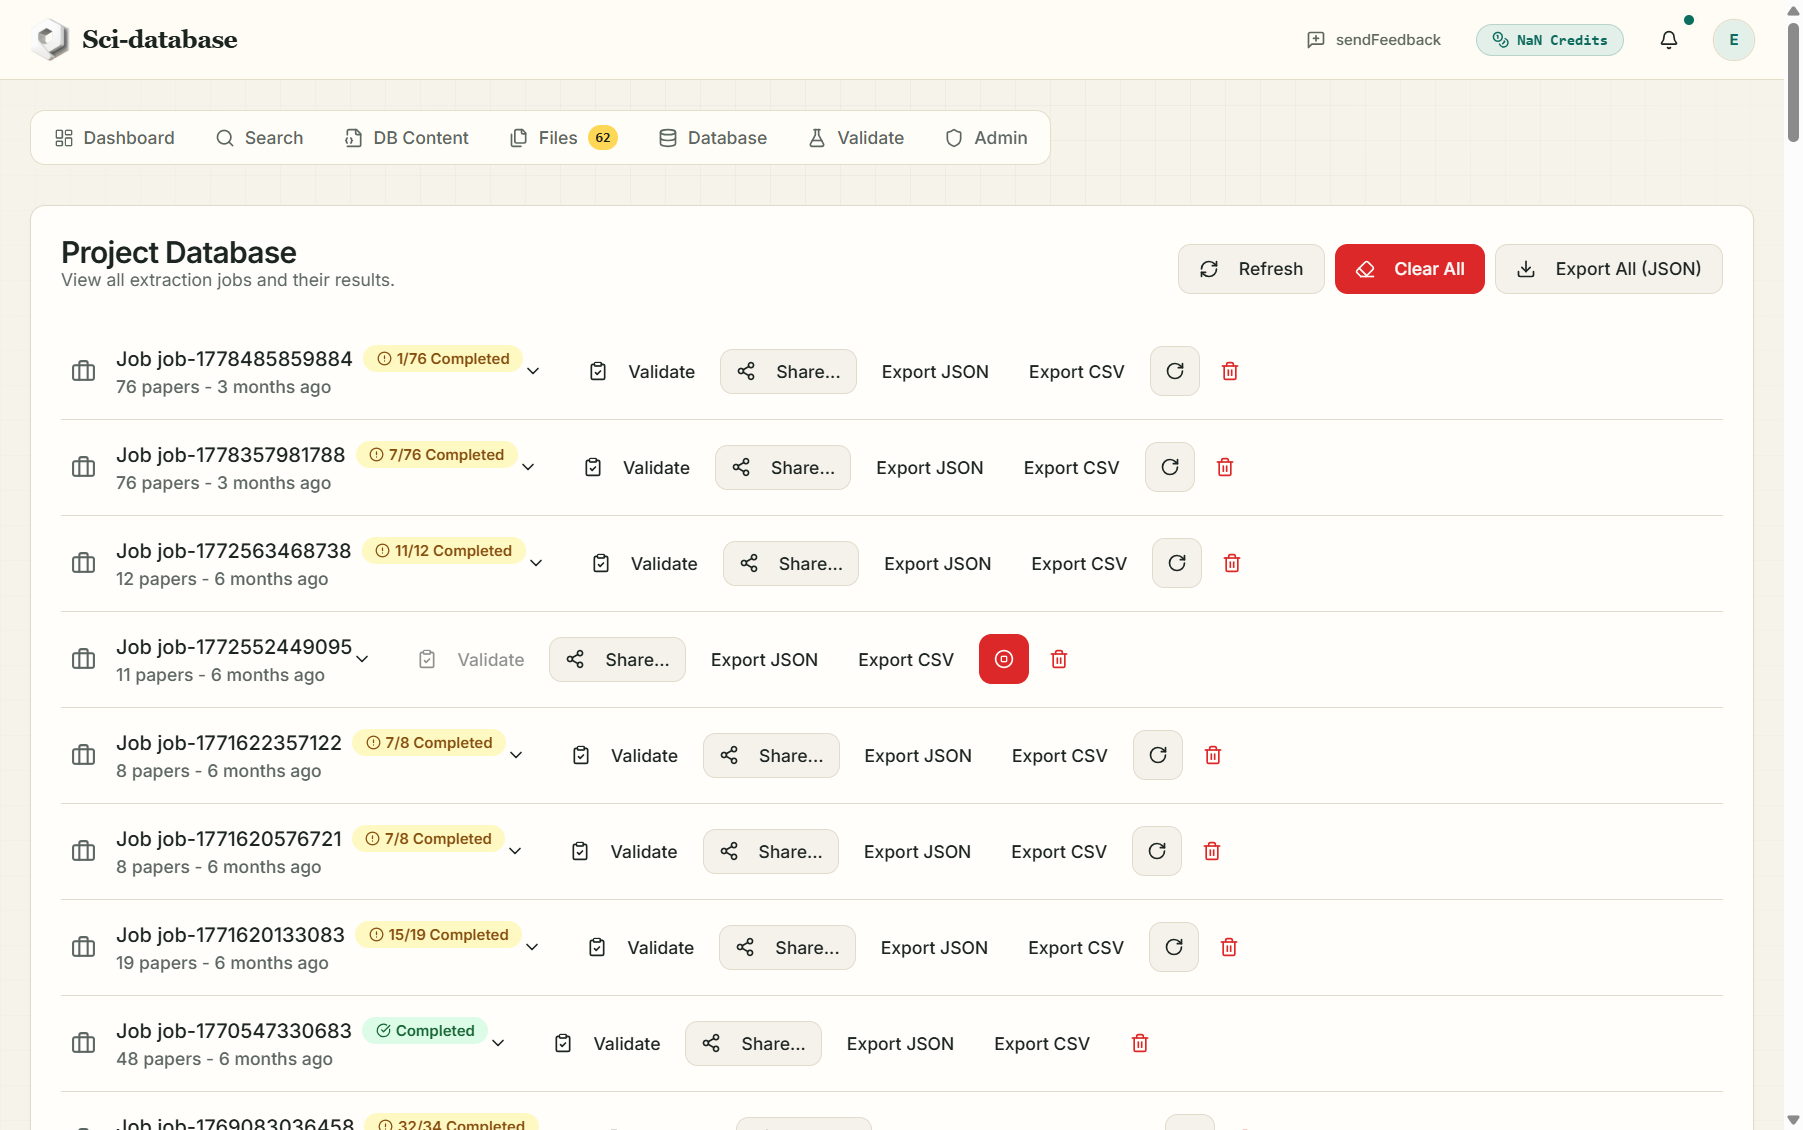
A guia Database é atualizada automaticamente a cada poucos segundos enquanto uma tarefa é executada. Cada papel carrega um crachá de status:
| Distintivo | Significado |
|---|---|
| Na fila | Esperando sua vez |
| Processando (spinner) | Sendo lido agora |
| Concluído | Extração concluída |
| Erro | Este papel falhou (por exemplo, PDF ilegível/digitalizado) — a mensagem de erro está armazenada no papel |
Status de nível de trabalho: Processando → Concluído (todos os artigos foram bem-sucedidos), "X/Y Concluído" (sucesso parcial — alguns artigos falharam) ou Error (nenhum bem-sucedido).
Parar e retomar
- Stop (ícone ⏹ na linha do trabalho) interrompe o trabalhador após o trabalho atual: "Trabalho interrompido — O processamento será interrompido em breve." Artigos já concluídos mantêm seus dados.
- Resume (ícone ↻) reinicia um trabalho interrompido ou parcial. Somente os trabalhos inacabados são recolocados na fila e recarregados (1 crédito cada) — os trabalhos concluídos nunca são reprocessados ou recarregados.
Quando o trabalho termina
- Você recebe um e-mail — "Sci-database Trabalho concluído" — com os resultados CSV anexados, para que seu banco de dados esteja em sua caixa de entrada antes mesmo de você retornar ao aplicativo.
- O cartão "próxima etapa" do Dashboard passa para "Explorar seu novo banco de dados".
Uma observação em escala: um único papel paralisado não pode bloquear seu trabalho — se um papel falhar, o funcionário registra o erro e segue em frente, e o trabalho termina com um sucesso parcial que você pode retomar ou exportar como está.
Próximo: Validação e o Juiz de IA →
