What Sci-database is, who it's for, and the 4 academic trust principles.
1 · परिचय
Sci-database क्या है?
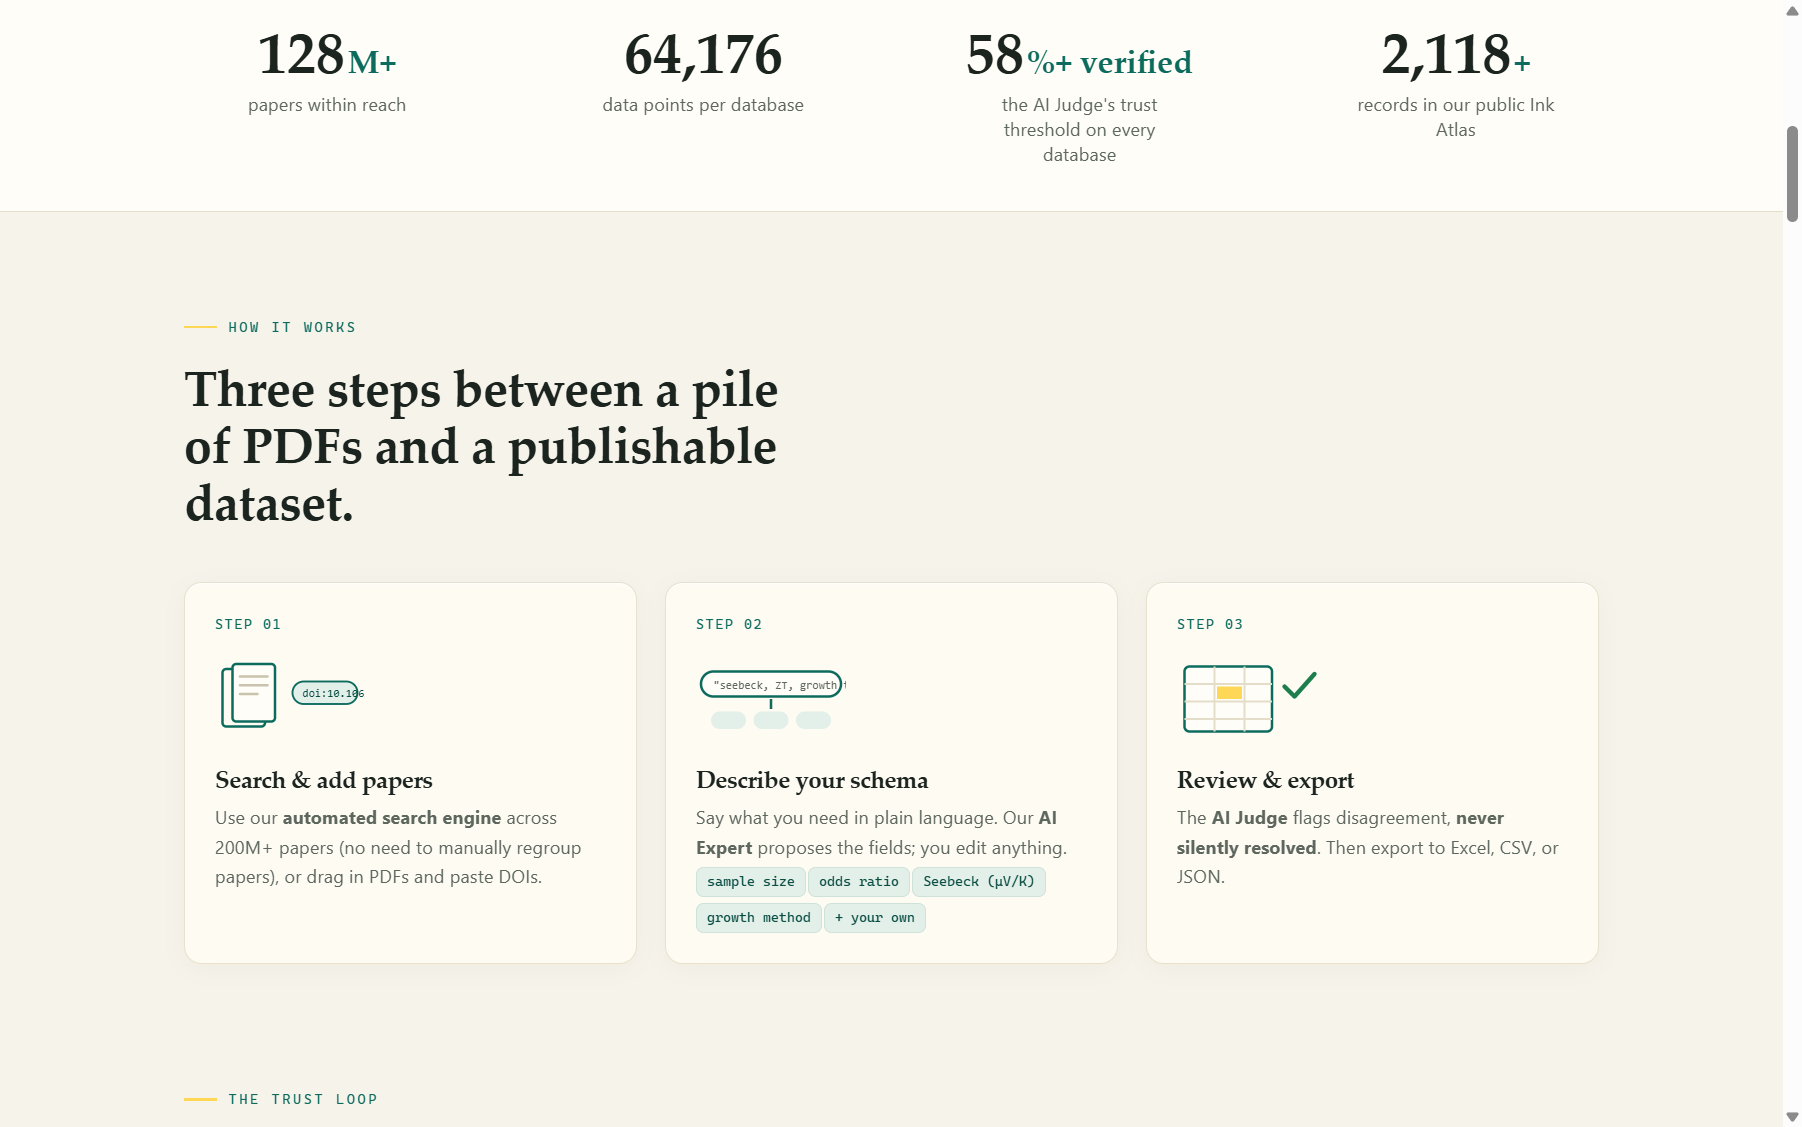
Sci-database अनुसंधान पीडीएफ के ढेर को एक संरचित, सत्यापित डेटाबेस में बदल देता है। सैकड़ों कागजों से मानों को एक स्प्रेडशीट में मैन्युअल रूप से कॉपी करने में महीनों बिताने के बजाय, आप:
- खोज सार्वजनिक रिपॉजिटरी (OpenAlex, CORE, Semantic Scholar) के माध्यम से 200एम+ वैज्ञानिक पेपर, या अपनी खुद की पीडीएफ अपलोड करें।
- आपको जिस डेटा की आवश्यकता है उसका सरल अंग्रेजी में वर्णन करें- एआई एक संरचित स्कीमा (आपके भविष्य के डेटाबेस के कॉलम) का प्रस्ताव करता है, जिसे आप फ़ील्ड दर फ़ील्ड संपादित कर सकते हैं।
- Extract - Kateeb इंजन प्रत्येक पूर्ण पेपर को पढ़ता है और आपकी स्कीमा भरता है। एक पेपर से कई रिकॉर्ड प्राप्त हो सकते हैं (उदाहरण के लिए, प्रति सामग्री एक पंक्ति या प्रति प्रयोगात्मक स्थिति)।
- Validate - एक दूसरा, स्वतंत्र एआई मॉडल आपके कागजात का एक नमूना फिर से निकालता है, और प्लेटफ़ॉर्म फ़ील्ड-दर-फ़ील्ड तुलना दिखाता है। असहमति को उजागर किया जाता है, चुपचाप कभी हल नहीं किया जाता।
- अपने डेटाबेस को Excel-तैयार CSV या JSON पर निर्यात करें - या खुले विज्ञान में योगदान देने के लिए इसे सार्वजनिक रूप से साझा करें।
यह किसके लिए है?
| आप हैं… | आप Sci-database का उपयोग करते हैं… |
|---|---|
| एक व्यवस्थित समीक्षक/मेटा-विश्लेषक | सैकड़ों परीक्षणों से परिणाम, नमूना आकार, प्रभाव आकार और अध्ययन विशेषताओं को निकालें, फिर आर (meta), स्टाटा, या RevMan |
| एक सामग्री वैज्ञानिक / भौतिक विज्ञानी / रसायनज्ञ | समीक्षा पत्रों के लिए संपत्ति डेटाबेस (जैसे सीबेक गुणांक, जेडटी मान, बैंड अंतराल, संश्लेषण विधियां) बनाएं |
| एक एमएल शोधकर्ता | साहित्य को बड़े पैमाने पर लेबल किए गए प्रशिक्षण डेटा में बदलें |
| समीक्षा लिखने वाला कोई भी शोधकर्ता | महीनों की मैन्युअल डेटा प्रविष्टि को पर्यवेक्षित निष्कर्षण की एक दोपहर से बदलें |
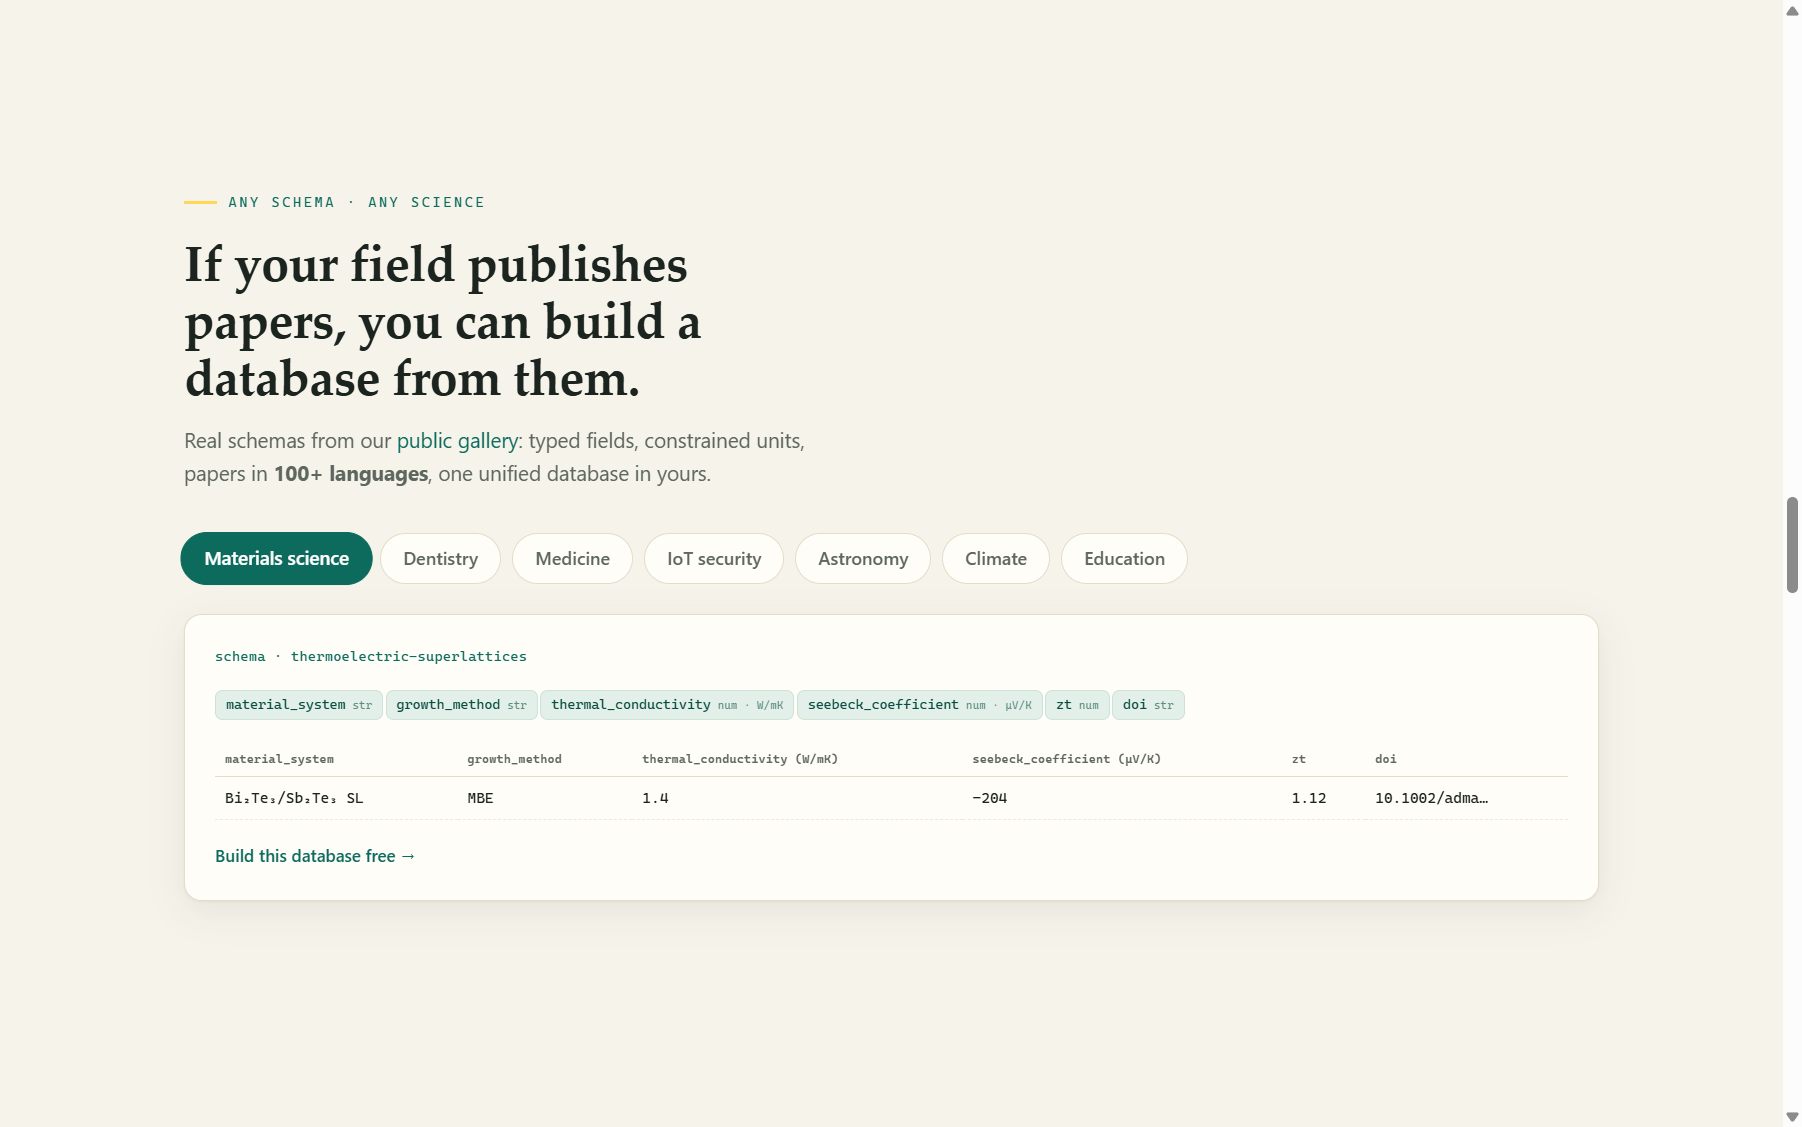
यदि आपका क्षेत्र कागजात प्रकाशित करता है, तो आप उनसे एक डेटाबेस बना सकते हैं - प्लेटफ़ॉर्म डोमेन-अज्ञेयवादी है। थर्मोइलेक्ट्रिक्स, डेंटल कंपोजिट, उच्च रक्तचाप आरसीटी, आईओटी सुरक्षा, सुपरनोवा अवलोकन, जलवायु अनुमान और बहुत कुछ के लिए सार्वजनिक स्कीमा पहले से ही मौजूद हैं।
विश्वास सिद्धांत
Sci-database अकादमिक उपयोग के लिए बनाया गया है, जहां मेटा-विश्लेषण में एक गलत संख्या एक लापता संख्या से भी बदतर है। पूरे उत्पाद में चार सिद्धांत चलते हैं:
1. शून्य सिंथेटिक डेटा
निष्कर्षण मॉडल एक सख्त निर्देश के तहत संचालित होता है: यदि कागज से कोई मान गायब है, या मॉडल अत्यधिक आश्वस्त नहीं है, तो उसे बिल्कुल N/A वापस आना चाहिए - कभी भी अनुमान नहीं, कभी भी प्रशंसनीय-लगने वाला निर्माण नहीं।
2. कोई भी बात चुपचाप हल नहीं होती
जब सत्यापनकर्ता मॉडल मूल निष्कर्षण से असहमत होता है, तो असहमति आपको लाल-हाइलाइट की गई तुलना पंक्ति में दिखाई जाती है। आप (वैकल्पिक रूप से तीसरे एआई मध्यस्थ द्वारा सहायता प्राप्त) तय करते हैं कि सच्चाई क्या है।
3. जुट जाओ, आशा मत करो
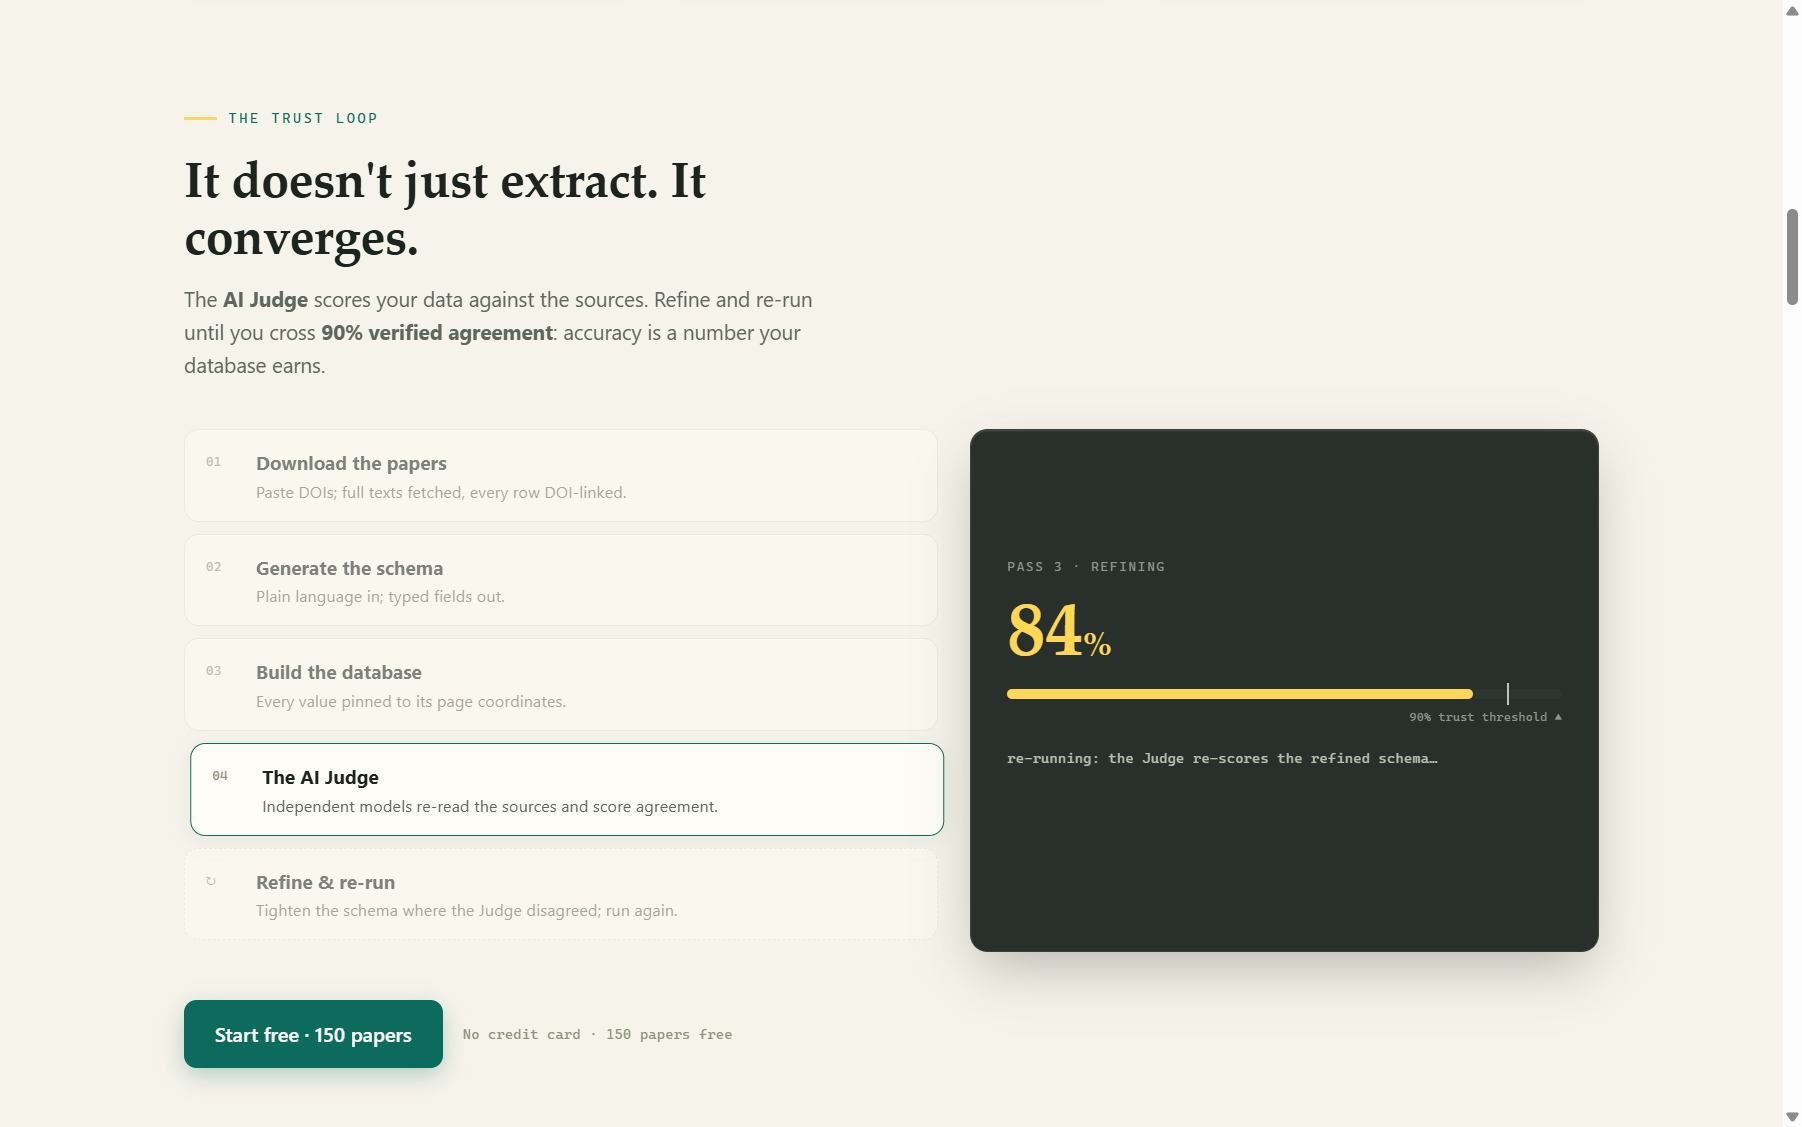
निष्कर्षण एक बार में नहीं होता. इच्छित लूप है: निकालें → दूसरे मॉडल के विरुद्ध मान्य करें → असहमति की जांच करें → एआई को अपने स्कीमा के फ़ील्ड विवरण में सुधार करने दें → फिर से चलाएं। प्रत्येक पास क्रॉस-मॉडल समझौते को बढ़ाता है; किसी डेटाबेस को "विश्वसनीय" मानने से पहले प्लेटफ़ॉर्म की विश्वास सीमा 90%+ समझौता है।
4. आपका डेटा आपका ही रहता है
- आपके कागजात और निकाला गया डेटा डिफ़ॉल्ट रूप से आपके खाते में निजी हैं।
- आपका schema (केवल फ़ील्ड परिभाषाएँ - कोई डेटा नहीं) अन्य शोधकर्ताओं की मदद के लिए सार्वजनिक गैलरी में साझा किया जा सकता है; यह उन शर्तों में बताया गया है जिन्हें आप साइन-अप के समय स्वीकार करते हैं।
- अपलोड का उपयोग मॉडल को प्रशिक्षित करने के लिए कभी नहीं किया जाता।
- आप किसी भी समय अपनी फ़ाइलें, नौकरियां और डेटाबेस हटा सकते हैं।
Kateeb इंजन
निष्कर्षण इंजन ब्रांडेड है Kateeb (كاتب, अरबी में "मुंशी")। सत्यापन दृश्यों में, मूल निष्कर्षण कॉलम को हमेशा "मूल (Kateeb)" लेबल किया जाता है ताकि आप एक नज़र में बता सकें कि कौन सा मॉडल किस मूल्य का उत्पादन करता है। Sci-database हमाद बिन खलीफा विश्वविद्यालय (दोहा, कतर) में विकसित किया गया था और पेटेंट-पंजीकृत है (क्यूएफ संदर्भ: 2024-066)।
अगला: आरंभ करना →
